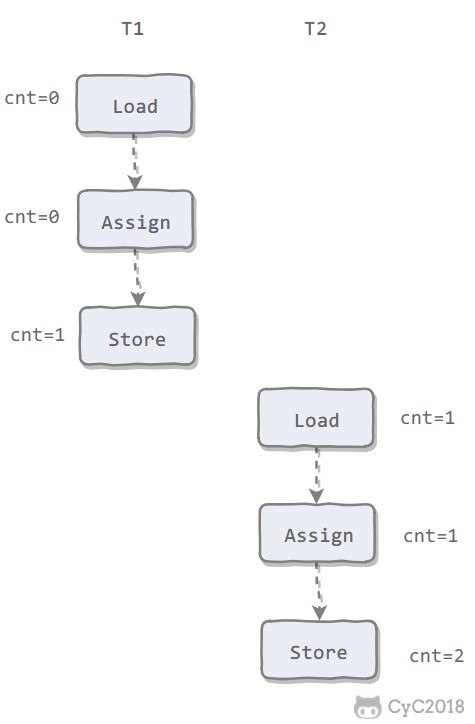
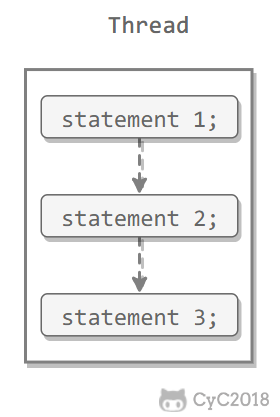
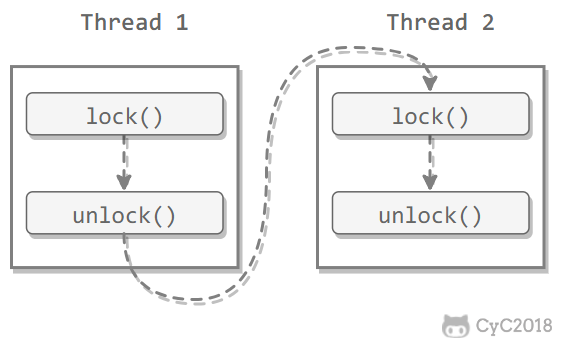
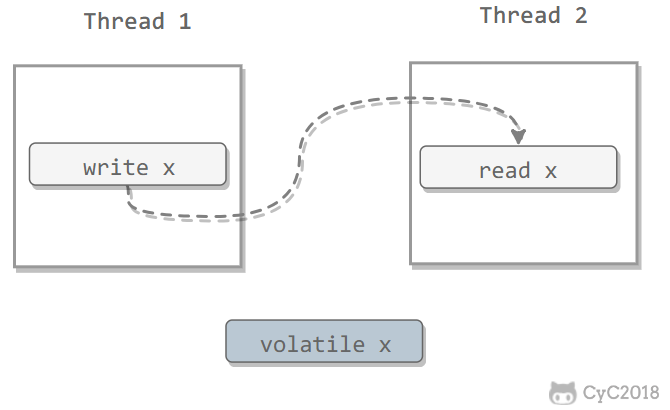
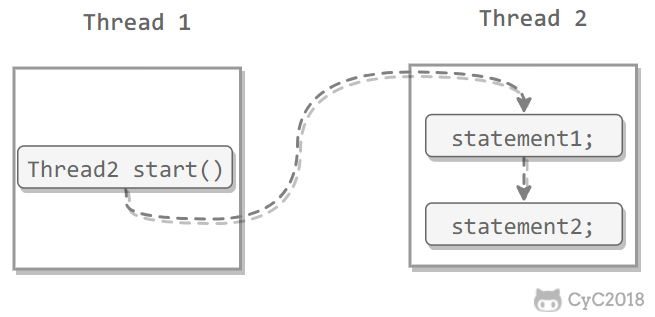
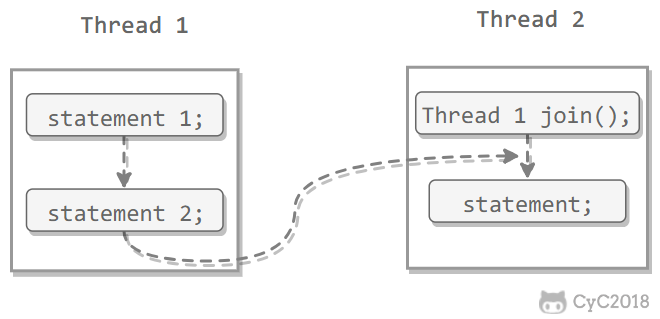
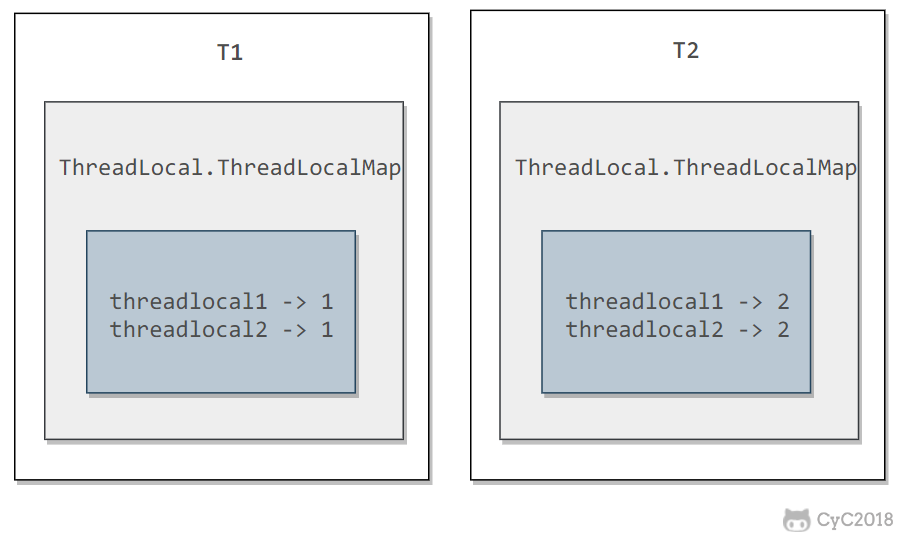
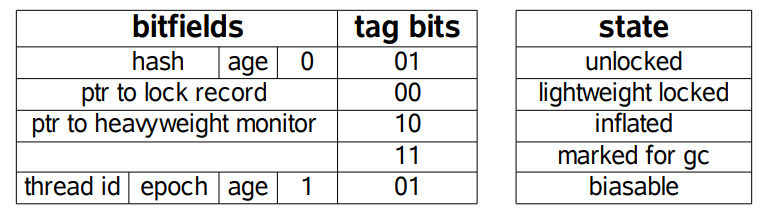
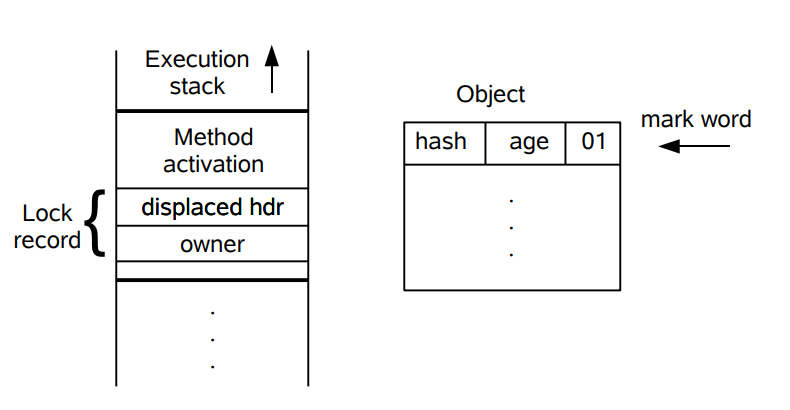
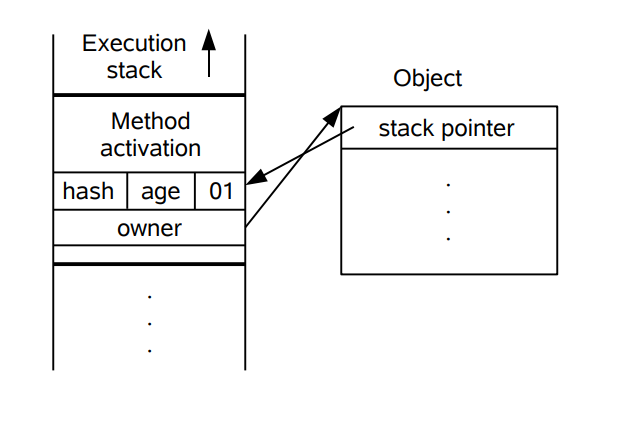
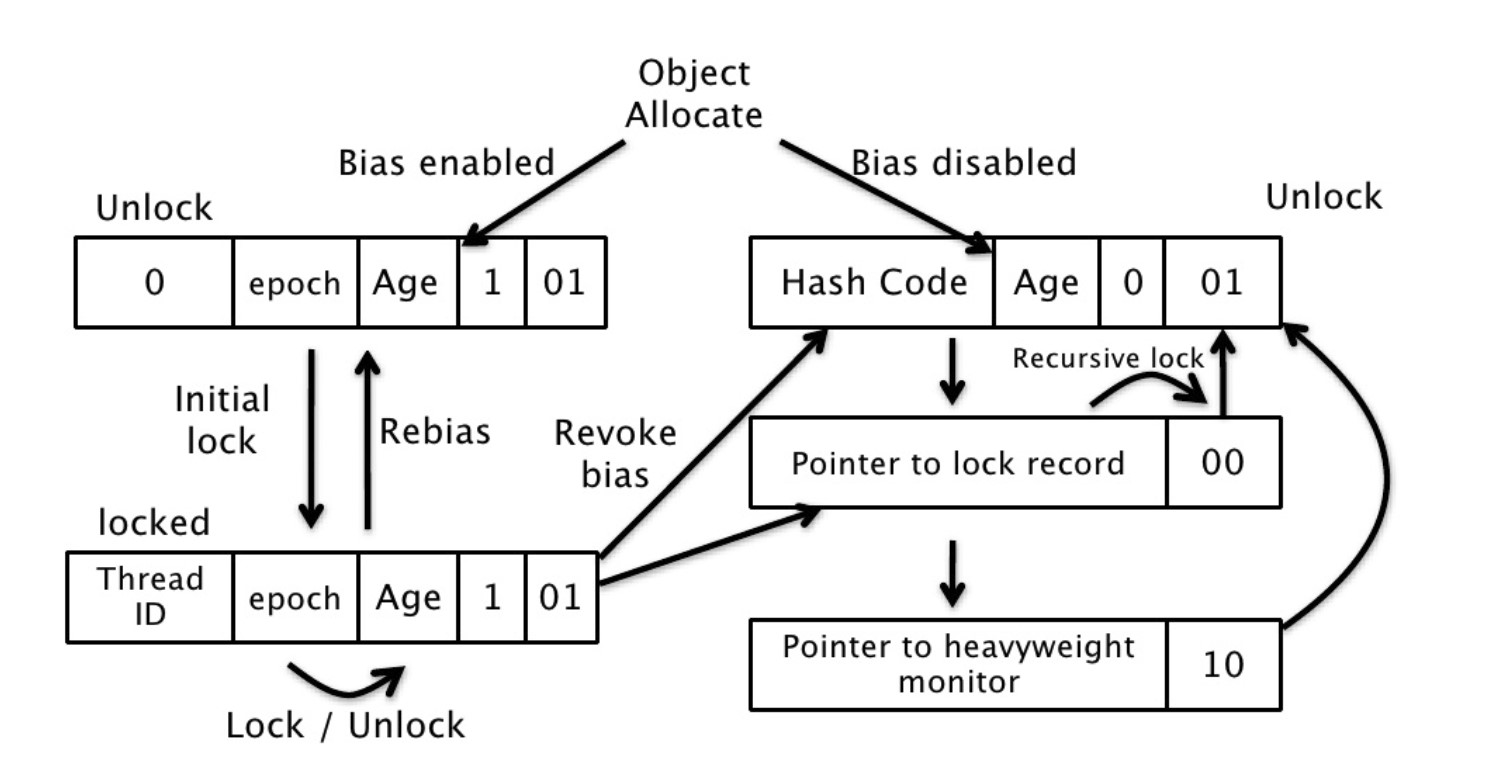
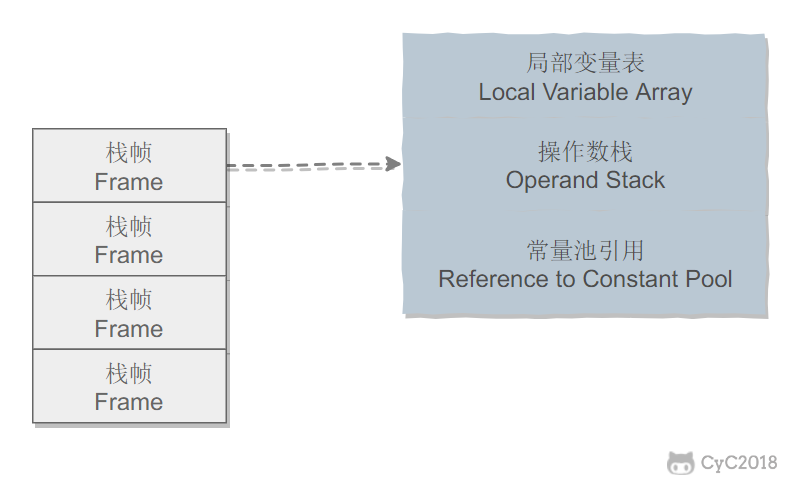
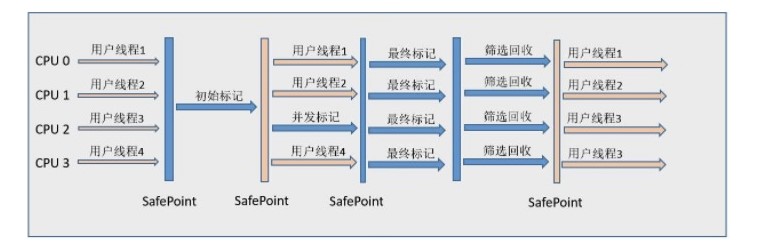
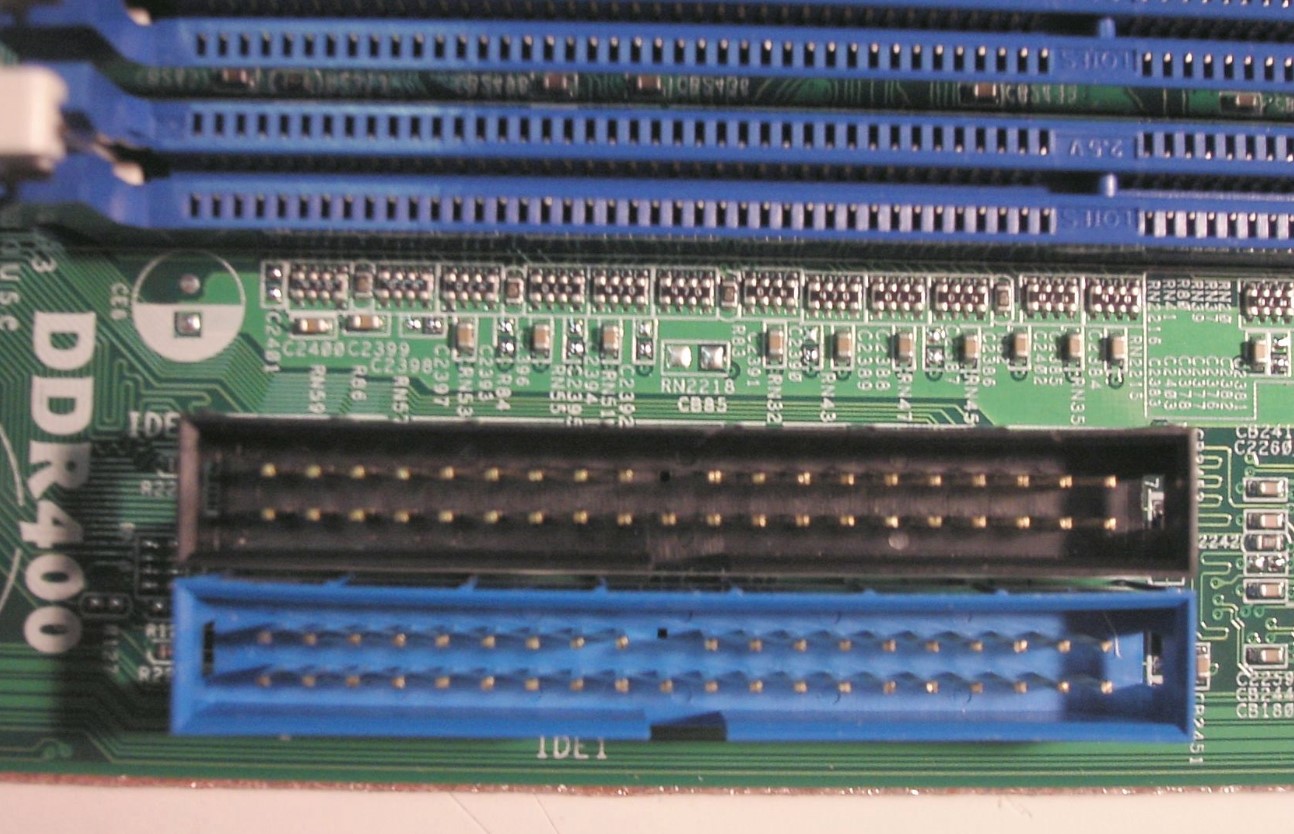
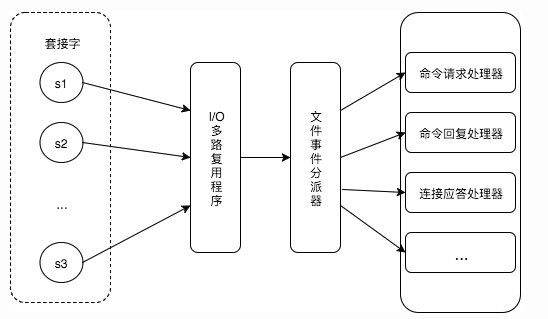
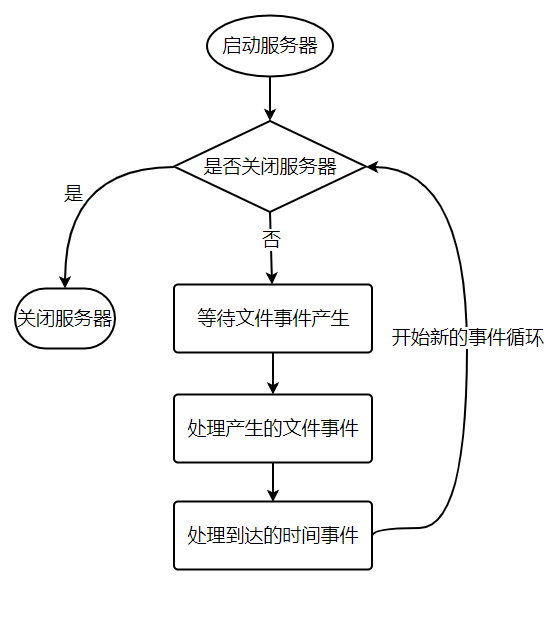
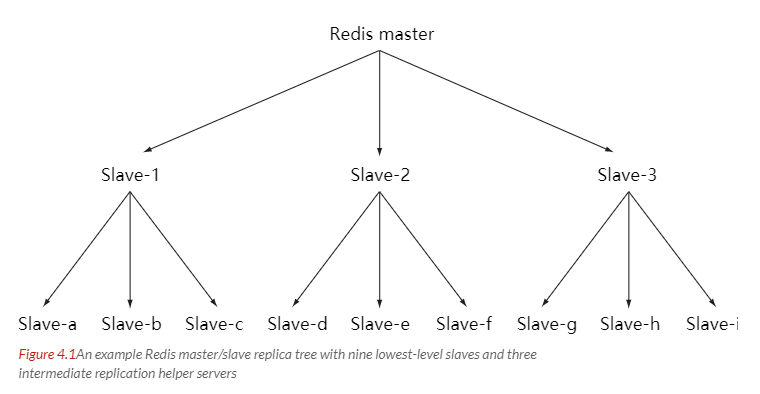
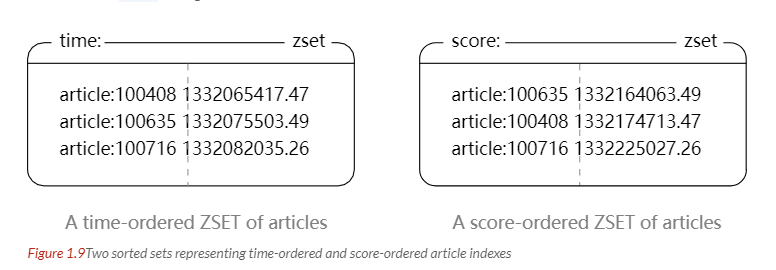
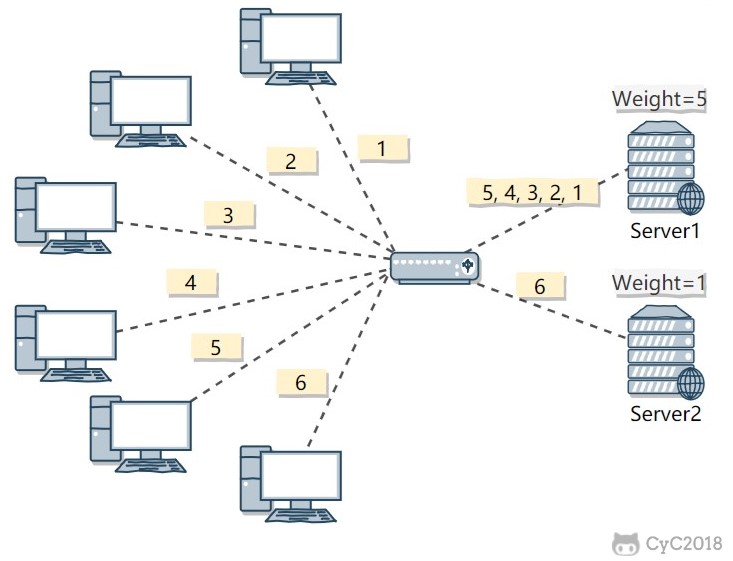
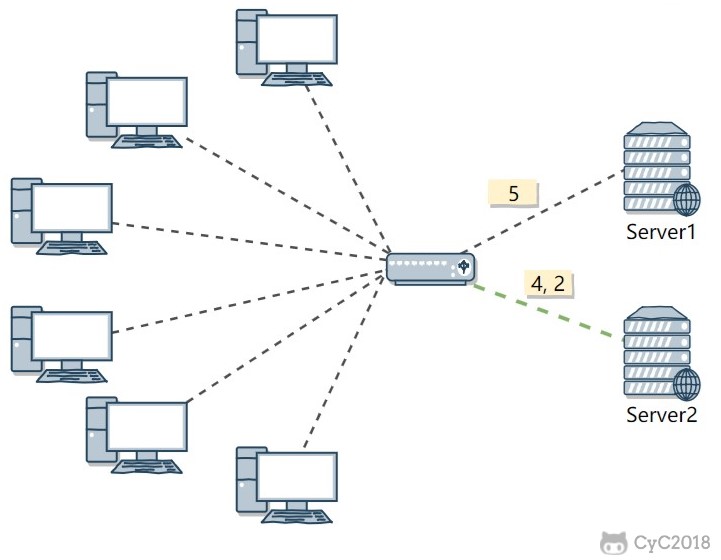
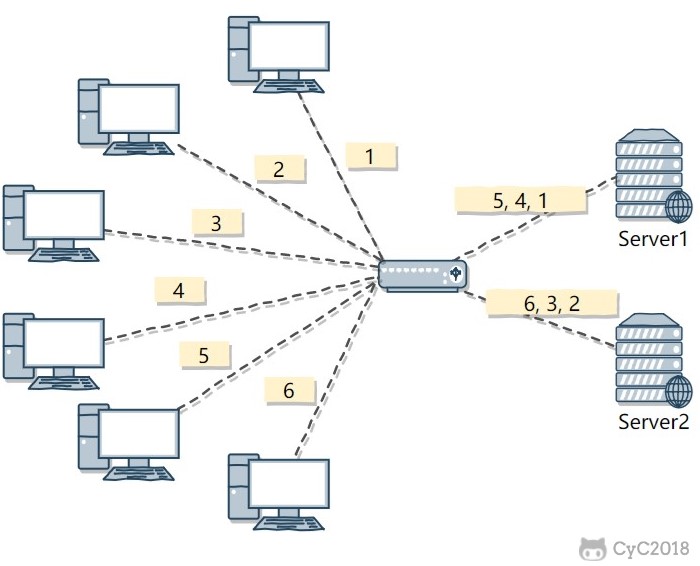
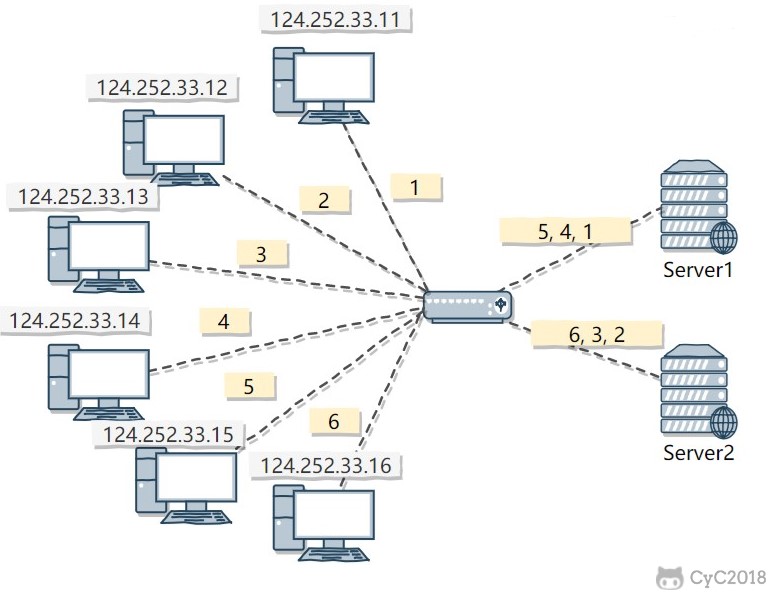
diff --git a/README.md b/README.md index d586386c7..759bb9fea 100644 --- a/README.md +++ b/README.md @@ -20,6 +20,10 @@
+
准备面试可以从 面试高频问题 开始,每个问题都链接到对应的章节。
+ +
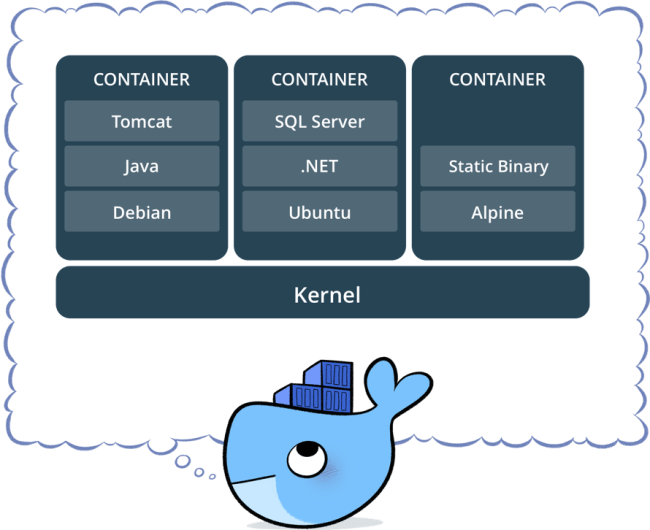
+ ## :pencil2: 算法 - [剑指 Offer 题解](https://github.com/CyC2018/CS-Notes/blob/master/notes/剑指%20Offer%20题解%20-%20目录.md) diff --git a/notes/Docker.md b/notes/Docker.md index ecebdfc34..eb575b717 100644 --- a/notes/Docker.md +++ b/notes/Docker.md @@ -6,6 +6,8 @@ * [三、优势](#三优势) * [四、使用场景](#四使用场景) * [五、镜像与容器](#五镜像与容器) + * [六、实现原理](#六实现原理) + * [七、Kubernetes](#七kubernetes) * [参考资料](#参考资料) @@ -16,13 +18,13 @@ Docker 主要解决环境配置问题,它是一种虚拟化技术,对进程进行隔离,被隔离的进程独立于宿主操作系统和其它隔离的进程。使用 Docker 可以不修改应用程序代码,不需要开发人员学习特定环境下的技术,就能够将现有的应用程序部署在其它机器上。 -

+

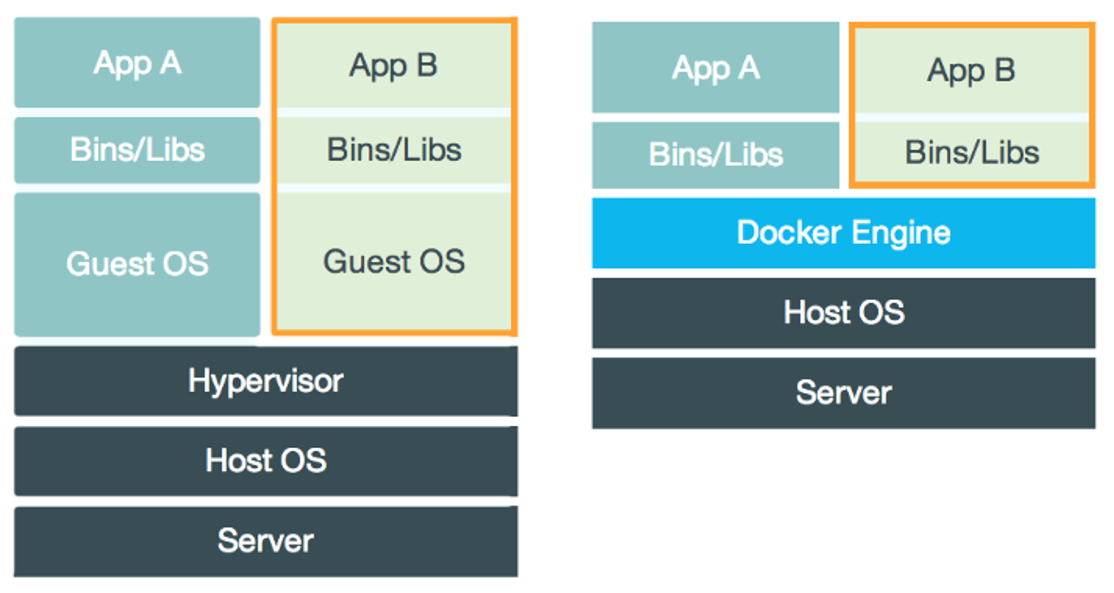
## 二、与虚拟机的比较 虚拟机也是一种虚拟化技术,它与 Docker 最大的区别在于它是通过模拟硬件,并在硬件上安装操作系统来实现。 -

+

### 启动速度 @@ -76,7 +78,84 @@ Docker 轻量级的特点使得它很适合用于部署、维护、组合微服 构建容器时,通过在镜像的基础上添加一个可写层(writable layer),用来保存着容器运行过程中的修改。 -

+

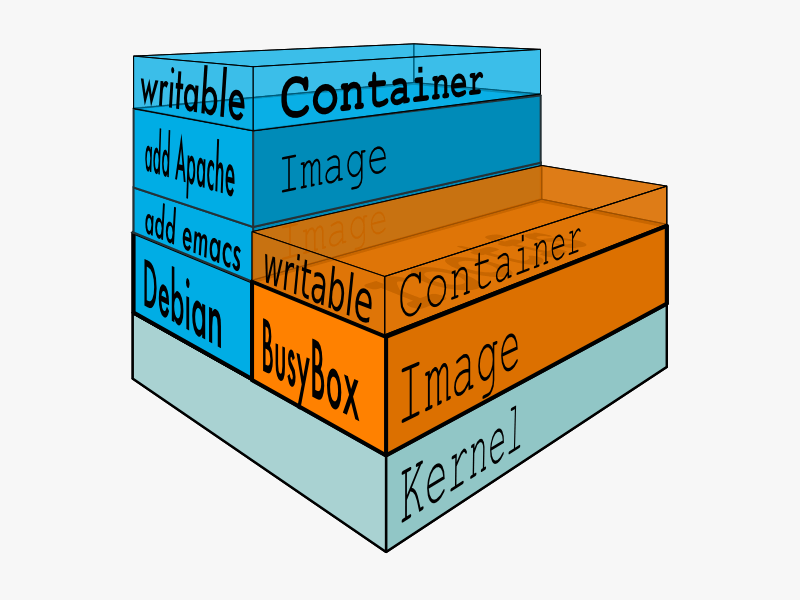
+ +## 六、实现原理 + +容器就是宿主机上的普通进程,Docker 用 Linux 内核的两个机制把它和其它进程隔开: + +- 命名空间(Namespace)负责隔离“能看到什么”:PID 命名空间让容器中的第一个进程以为自己是 1 号进程;网络命名空间让容器有自己的网卡、IP 和端口;挂载命名空间让容器有自己的根文件系统;UTS 命名空间让容器有自己的主机名; +- 控制组(cgroup)负责限制“能用多少”:限制 CPU、内存、磁盘 I/O 等资源。 + +例如用 docker run --memory 64m --cpus 0.5 启动一个容器,在容器中查看: + +```sh +$ cat /sys/fs/cgroup/memory.max /sys/fs/cgroup/cpu.max +67108864 +50000 100000 +$ echo $$ +1 +``` + +内存上限是 64 MB,CPU 每 100 ms 最多使用 50 ms,即半个 CPU;容器里的 shell 的进程号是 1。在容器中不断申请内存,超过 64 MB 时进程被内核杀掉,退出码为 137(128 + SIGKILL 的 9)。 + +因为所有容器共享宿主机的内核,所以容器比虚拟机轻量,但隔离性也更弱:内核漏洞可能让容器中的进程影响宿主机。 + +## 七、Kubernetes + +Docker 解决的是单台机器上怎样运行容器。服务有几十个、部署在几十台机器上时,还需要决定每个容器放在哪台机器上、挂了谁来重启、怎样扩容、怎样不停机升级,这就是 Kubernetes(K8s)做的事情。 + +K8s 的核心思想是声明期望的状态,由控制器不断把实际状态调整为期望状态。例如下面的配置声明 order-service 要运行 3 个副本,并通过一个 Service 对外提供访问: + +```yaml +apiVersion: apps/v1 +kind: Deployment +metadata: + name: order-service +spec: + replicas: 3 + selector: + matchLabels: + app: order-service + template: + metadata: + labels: + app: order-service + spec: + containers: + - name: app + image: nginx:1.27-alpine + ports: + - containerPort: 80 + readinessProbe: + httpGet: { path: /, port: 80 } +--- +apiVersion: v1 +kind: Service +metadata: + name: order-service +spec: + selector: + app: order-service + ports: + - port: 80 + targetPort: 80 +``` + +其中的几个概念: + +- Pod:K8s 调度的最小单位,包含一个或几个共享网络和存储的容器,每个 Pod 有自己的 IP,重建后 IP 会变; +- Deployment:管理一组相同的 Pod,负责保持副本数、扩缩容和滚动升级; +- Service:为一组 Pod 提供固定的虚拟 IP 和域名,把请求负载均衡到其中就绪的 Pod 上; +- 控制平面:API Server 接收所有请求,etcd 保存集群状态,调度器决定 Pod 放在哪个节点,控制器管理器运行各种控制器;每个节点上的 kubelet 负责启动和检查本节点的容器。 + +在本机的单节点 K8s(k3s v1.31)上实际操作: + +- kubectl apply 之后约 20 秒,3 个 Pod 全部就绪,Service 得到虚拟 IP 10.43.189.89,在集群内用 http://order-service 就能访问; +- 删除一个 Pod,Deployment 发现副本数少于 3,立即创建新的 Pod,约 1.2 秒后恢复为 3/3,新 Pod 的 IP 与原来不同,Service 自动更新了后端列表; +- kubectl scale 把副本数改为 5;kubectl set image 修改镜像版本后,Deployment 创建新的 ReplicaSet,逐个用新版本的 Pod 替换旧的,约 12 秒完成滚动升级,期间一直有就绪的 Pod 在提供服务,需要时可以用 kubectl rollout undo 回滚。 + +readinessProbe 是就绪探针:Pod 启动后要通过检查才会加入 Service 的后端列表,避免把请求转发给还没启动完成的实例。 ## 参考资料 @@ -85,7 +164,11 @@ Docker 轻量级的特点使得它很适合用于部署、维护、组合微服 - [Docker container vs Virtual machine](http://www.bogotobogo.com/DevOps/Docker/Docker_Container_vs_Virtual_Machine.php) - [How to Create Docker Container using Dockerfile](https://linoxide.com/linux-how-to/dockerfile-create-docker-container/) - [理解 Docker(2):Docker 镜像](http://www.cnblogs.com/sammyliu/p/5877964.html) -- [为什么要使用 Docker?](https://yeasy.gitbooks.io/docker_practice/introduction/why.html) +- [为什么要使用 Docker?](https://yeasy.gitbook.io/docker_practice/introduction/why) - [What is Docker](https://www.docker.com/what-docker) - [持续集成是什么?](http://www.ruanyifeng.com/blog/2015/09/continuous-integration.html) - +- [Understanding the image layers | Docker Docs](https://docs.docker.com/get-started/docker-concepts/building-images/understanding-image-layers/) +- [Kubernetes 文档:Deployments](https://kubernetes.io/docs/concepts/workloads/controllers/deployment/) +- [Kubernetes 文档:Service](https://kubernetes.io/docs/concepts/services-networking/service/) +- [namespaces(7) — Linux manual page](https://man7.org/linux/man-pages/man7/namespaces.7.html) +- [cgroups(7) — Linux manual page](https://man7.org/linux/man-pages/man7/cgroups.7.html) diff --git a/notes/Git.md b/notes/Git.md index 1f3922a81..d8add9588 100644 --- a/notes/Git.md +++ b/notes/Git.md @@ -141,9 +141,30 @@ $ ssh-keygen -t rsa -C "youremail@example.com" ## Git 命令一览 -

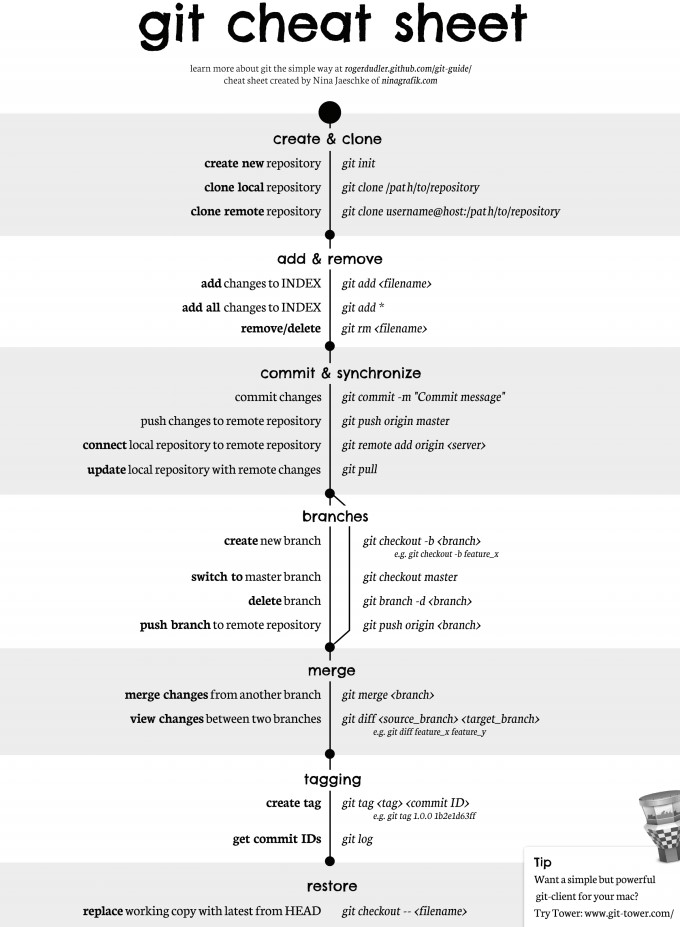
- -比较详细的地址:http://www.cheat-sheets.org/saved-copy/git-cheat-sheet.pdf +| 用途 | 命令 | +| --- | --- | +| 克隆仓库 | git clone | +| 查看状态 | git status | +| 加入暂存区 | git add | +| 提交 | git commit -m "说明" | +| 查看历史 | git log --oneline --graph | +| 查看改动 | git diff(工作区与暂存区),git diff --staged(暂存区与最新提交) | +| 撤销工作区的修改 | git restore | +| 撤销 git add | git restore --staged | +| 新建并切换分支 | git switch -c dev | +| 切换分支 | git switch master | +| 合并分支 | git merge dev | +| 变基 | git rebase master | +| 临时保存修改 | git stash,之后用 git stash pop 恢复 | +| 撤销最近一次提交,保留修改 | git reset --soft HEAD~1 | +| 回到某个提交,丢弃之后的修改 | git reset --hard | +| 用一个新提交抵消某次提交 | git revert | +| 拉取并合并远程分支 | git pull | +| 推送 | git push origin dev | + +git restore 和 git switch 是 Git 2.23 加入的命令,分别承担了原来 git checkout 恢复文件和切换分支两种用途。需要注意的是,reset --hard 会丢弃未提交的修改;已经推送到远程的提交,应该用 revert 撤销,而不是 reset 后强制推送。 + +比较详细的命令列表:http://www.cheat-sheets.org/saved-copy/git-cheat-sheet.pdf ## 参考资料 diff --git a/notes/HTTP.md b/notes/HTTP.md index 578e53e52..1ade6a90d 100644 --- a/notes/HTTP.md +++ b/notes/HTTP.md @@ -36,9 +36,12 @@ * [多部分对象集合](#多部分对象集合) * [虚拟主机](#虚拟主机) * [通信数据转发](#通信数据转发) + * [WebSocket](#websocket) + * [跨域](#跨域) * [六、HTTPS](#六https) * [加密](#加密) * [认证](#认证) + * [TLS 握手](#tls-握手) * [完整性保护](#完整性保护) * [HTTPS 的缺点](#https-的缺点) * [七、HTTP/2.0](#七http20) @@ -46,6 +49,7 @@ * [二进制分帧层](#二进制分帧层) * [服务端推送](#服务端推送) * [首部压缩](#首部压缩) + * [HTTP/3](#http3) * [八、HTTP/1.1 新特性](#八http11-新特性) * [九、GET 和 POST 比较](#九get-和-post-比较) * [作用](#作用) @@ -69,7 +73,7 @@ - 第一行是包含了请求方法、URL、协议版本; - 接下来的多行都是请求首部 Header,每个首部都有一个首部名称,以及对应的值。 - 一个空行用来分隔首部和内容主体 Body -- 最后是请求的内容主体 +- 最后是请求的内容主体,GET 请求通常没有主体,POST 请求的表单数据、JSON 放在这里 ```http GET http://www.example.com/ HTTP/1.1 @@ -84,7 +88,6 @@ Proxy-Connection: keep-alive Upgrade-Insecure-Requests: 1 User-Agent: Mozilla/5.0 xxx -param1=1¶m2=2 ``` 响应报文结构: @@ -218,7 +221,7 @@ DELETE /file.html HTTP/1.1 CONNECT www.example.com:443 HTTP/1.1 ``` -

+

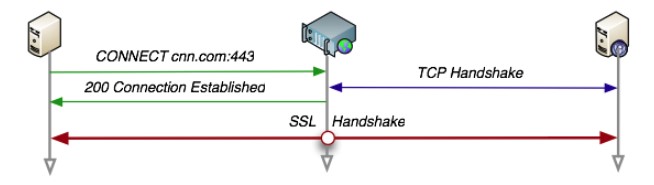
### TRACE @@ -270,6 +273,8 @@ CONNECT www.example.com:443 HTTP/1.1 - **307 Temporary Redirect** :临时重定向,与 302 的含义类似,但是 307 要求浏览器不会把重定向请求的 POST 方法改成 GET 方法。 +- **308 Permanent Redirect** :永久重定向,与 301 的含义类似,但不允许改变请求方法。 + ### 4XX 客户端错误 - **400 Bad Request** :请求报文中存在语法错误。 @@ -280,12 +285,20 @@ CONNECT www.example.com:443 HTTP/1.1 - **404 Not Found** +- **429 Too Many Requests** :请求太频繁,被限流,可以在 Retry-After 首部中告诉客户端多久之后再试。 + ### 5XX 服务器错误 - **500 Internal Server Error** :服务器正在执行请求时发生错误。 +- **502 Bad Gateway** :作为网关或代理的服务器从上游服务器收到了无效的响应,例如 Nginx 连不上后端,或者后端在返回响应之前断开了连接。 + - **503 Service Unavailable** :服务器暂时处于超负载或正在进行停机维护,现在无法处理请求。 +- **504 Gateway Timeout** :作为网关或代理的服务器没有及时收到上游服务器的响应,例如 Nginx 等待后端的时间超过了 proxy_read_timeout(默认 60 秒)。 + +502 和 504 都说明问题出在网关后面的服务上:502 是后端出错或者不可达,504 是后端太慢,排查时先看网关的错误日志,再看对应时间后端的日志和耗时。 + ## 四、HTTP 首部 有 4 种类型的首部字段:通用首部字段、请求首部字段、响应首部字段和实体首部字段。 @@ -363,7 +376,7 @@ CONNECT www.example.com:443 HTTP/1.1 ### 连接管理 -

+

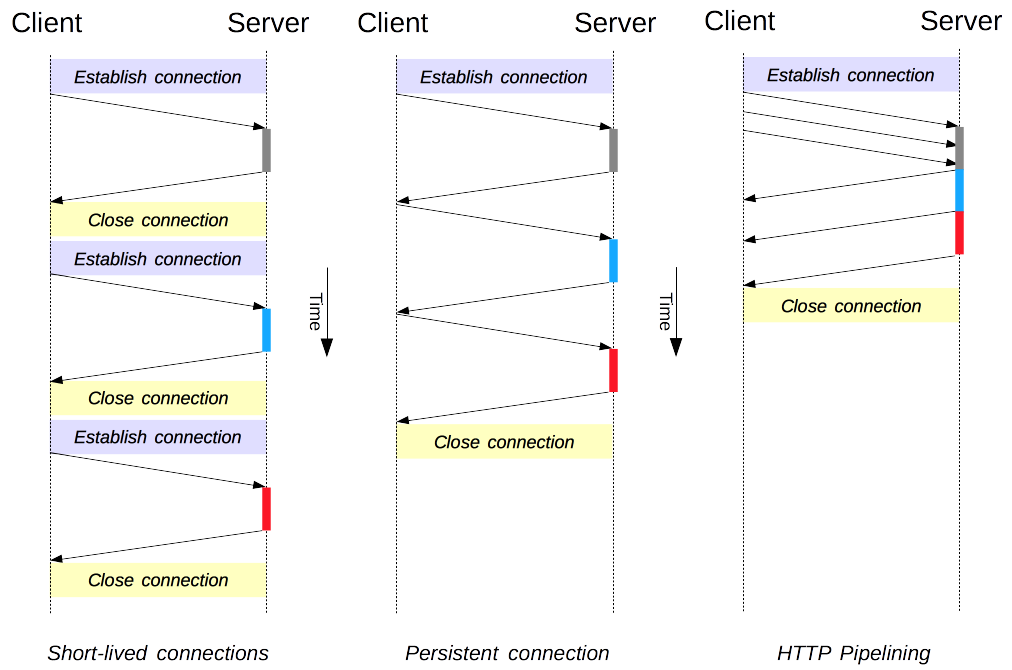
#### 1. 短连接与长连接 @@ -456,6 +469,8 @@ Set-Cookie: id=a3fWa; Expires=Wed, 21 Oct 2015 07:28:00 GMT; Secure; HttpOnly 标记为 Secure 的 Cookie 只能通过被 HTTPS 协议加密过的请求发送给服务端。但即便设置了 Secure 标记,敏感信息也不应该通过 Cookie 传输,因为 Cookie 有其固有的不安全性,Secure 标记也无法提供确实的安全保障。 +SameSite 属性控制跨站请求是否携带 Cookie,用于防范跨站请求伪造,见 [设置 Cookie 的 SameSite 属性](攻击技术.md#3-设置-cookie-的-samesite-属性)。 + #### 8. Session 除了可以将用户信息通过 Cookie 存储在用户浏览器中,也可以利用 Session 存储在服务器端,存储在服务器端的信息更加安全。 @@ -515,6 +530,56 @@ JWT 与 Session 的区别: JWT 只是令牌的格式,而 OAuth 2.0 是授权框架,规定第三方应用如何获得访问令牌,这个访问令牌可以用 JWT 表示。 +#### 12. 单点登录与 OAuth 2.0 + +单点登录(Single Sign-On, SSO)指的是在一个地方登录后,访问同一家公司的多个系统都不需要再登录。 + +多个系统在同一个父域名下时(a.example.com、b.example.com),把会话的 Cookie 设置为 Domain=example.com 就能共享。域名不同时(shop.com、pay.com),Cookie 无法跨域,需要一个统一的认证中心 sso.example.com: + +1. 用户访问 pay.com,pay.com 发现没有会话,重定向到 sso.example.com/login?redirect=https://pay.com/; +2. 用户之前在 shop.com 登录时已经在认证中心登录过,认证中心的域名下有它自己的 Cookie,于是不需要输入密码,直接生成一个一次性的票据,重定向回 https://pay.com/?ticket=ST-1024; +3. pay.com 的后端拿票据向认证中心验证,得到用户信息后建立 pay.com 自己的会话。 + +票据经过浏览器的地址栏,可能被记录或截获,所以只能使用一次、有效期很短,并且必须由后端去认证中心验证,而不是直接信任。 + +OAuth 2.0 解决的是另一个问题:授权第三方应用访问用户在某个服务上的数据,而不把密码交给它,例如笔记网站读取用户在账号中心的昵称和头像。“用微信登录”这类功能就是基于 OAuth 2.0 实现的,最常用的是授权码模式: + +

+ +在本机用 Python 实现了一个最小的授权服务器,按上图运行了一遍,第 ① 步之后浏览器访问的地址和第 ⑥ 步笔记网站后端发送的请求如下(域名已替换,省略了部分字段): + +```text +GET https://id.example.com/authorize?response_type=code&client_id=notes-app + &redirect_uri=https://notes.example.com/callback&scope=profile&state=x7Kp2 + &code_challenge=RQgc0f_GtuKCUitkJiCz7wNdN-_2JLHQ0JGLD9XxGtg&code_challenge_method=S256 + +POST https://id.example.com/token +grant_type=authorization_code&code=R9YdiYheE6HIfYaA0e8LkQ + &redirect_uri=https://notes.example.com/callback&client_id=notes-app + &code_verifier=notes-demo-verifier-0123456789abcdefghijklmnop + +{"access_token": "v-7DlxOYaDNY-ewb8cCXCujdIyR7qdtl", "token_type": "Bearer", "expires_in": 3600} +``` + +几个参数的作用: + +- code:授权码,经过浏览器传给笔记网站,规范建议最长 10 分钟有效,并且只能使用一次。同一个授权码第二次换令牌时,返回 400 {"error": "invalid_grant"}; +- code_verifier 和 code_challenge(PKCE):笔记网站先生成一个随机串 code_verifier,把它的 SHA-256 摘要 code_challenge 放在第一步的地址中,换令牌时再提交原文,授权服务器核对两者是否对应。攻击者即使截获了授权码,没有 code_verifier 也换不到令牌,实测同样返回 invalid_grant; +- state:笔记网站生成的随机值,回调时检查是否与发出的一致,防止攻击者用自己账号的授权码构造回调地址,让用户登录到攻击者的账号上,这是一种 [CSRF](攻击技术.md#二跨站请求伪造); +- access_token:访问令牌,由笔记网站的后端直接向授权服务器换取,不经过浏览器。 + +早期还有一种隐式模式,授权服务器直接把访问令牌放在重定向的地址中返回,令牌会出现在浏览器历史记录和日志中。RFC 9700(OAuth 2.0 安全最佳实践)规定不应该再使用隐式模式,没有能力保存密钥的客户端(例如单页应用、手机 App)必须使用 PKCE。 + +OAuth 2.0 本身只负责授权,访问令牌表示“可以读取昵称”,并不说明当前用户是谁。OpenID Connect 在它的基础上增加了 ID Token,这是一个包含用户 ID 的 JWT,专门用于登录,很多“第三方账号登录”使用的就是它。 + +扫码登录也是类似的思路,把手机上已有的登录状态安全地交给电脑: + +1. 电脑网页向服务器申请一个二维码 ID,状态为“等待扫码”,并开始轮询这个 ID 的状态; +2. 已登录的手机 App 扫码后,带着手机自己的令牌把二维码 ID 发给服务器,状态变为“已扫码”,电脑上显示“请在手机上确认”; +3. 用户在手机上点击确认,服务器为电脑签发一个新的令牌,状态变为“已确认”,电脑轮询拿到令牌后完成登录。 + +需要注意的是,电脑拿到的是新签发的令牌,而不是手机的令牌;二维码 ID 有效期很短,确认这一步要求用户在手机上手动点击,防止别人把二维码发给用户诱导扫码。 + ### 缓存 #### 1. 优点 @@ -604,6 +669,23 @@ Last-Modified: Wed, 21 Oct 2015 07:28:00 GMT If-Modified-Since: Wed, 21 Oct 2015 07:28:00 GMT ``` +#### 5. 强缓存与协商缓存 + +浏览器使用缓存分为两种情况: + +- 强缓存:缓存还在 max-age 规定的有效期内,直接使用,不发送请求; +- 协商缓存:缓存已经过期,或者响应中有 no-cache,浏览器带上 If-None-Match 或 If-Modified-Since 向服务器确认,资源没有变化就返回 304,只传输首部,浏览器继续使用本地的缓存。 + +在本机用 Python 写一个服务器,a.js 返回 Cache-Control: max-age=600,b.js 返回 Cache-Control: no-cache,两者都带 ETag,用 Edge 打开同一个页面两次,服务器收到的请求如下: + +```text +第 1 次 /a.js 无条件请求 -> 200 + /b.js 无条件请求 -> 200 +第 2 次 /b.js If-None-Match: "b-v1" -> 304 +``` + +第 2 次打开时 a.js 没有发出请求,直接使用了强缓存;b.js 每次都要确认,但内容没有变化时只返回 304。常见的做法是 HTML 使用 no-cache,保证总能拿到最新的页面;JS、CSS 的文件名中带上内容的哈希值,例如 app.3f2a1c.js,设置很长的 max-age,内容变化时文件名随之改变,旧的缓存自然不再被使用。 + ### 内容协商 通过内容协商返回最合适的内容,例如根据浏览器的默认语言选择返回中文界面还是英文界面。 @@ -638,9 +720,9 @@ Vary: Accept-Language 内容编码将实体主体进行压缩,从而减少传输的数据量。 -常用的内容编码有:gzip、compress、deflate、identity。 +常用的内容编码有 gzip、deflate 和 br(Brotli),identity 表示不压缩。本机的 Edge 156 发出的请求中带的是 Accept-Encoding: gzip, deflate, br, zstd,较新的浏览器还支持 zstd。 -浏览器发送 Accept-Encoding 首部,其中包含有它所支持的压缩算法,以及各自的优先级。服务器则从中选择一种,使用该算法对响应的消息主体进行压缩,并且发送 Content-Encoding 首部来告知浏览器它选择了哪一种算法。由于该内容协商过程是基于编码类型来选择资源的展现形式的,响应报文的 Vary 首部字段至少要包含 Content-Encoding。 +浏览器发送 Accept-Encoding 首部,其中包含有它所支持的压缩算法,以及各自的优先级。服务器则从中选择一种,使用该算法对响应的消息主体进行压缩,并且发送 Content-Encoding 首部来告知浏览器它选择了哪一种算法。由于响应的内容取决于请求中的 Accept-Encoding,响应报文的 Vary 首部字段要包含 Accept-Encoding,否则缓存服务器可能把压缩过的内容返回给不支持该算法的客户端。 ### 范围请求 @@ -682,7 +764,7 @@ Accept-Ranges: bytes ### 分块传输编码 -Chunked Transfer Encoding,可以把数据分割成多块,让浏览器逐步显示页面。 +Chunked Transfer Encoding,可以把数据分割成多块,让浏览器逐步显示页面。响应中带有 Transfer-Encoding: chunked 首部,不需要 Content-Length,每一块先写明长度,再写内容,最后以长度为 0 的块结束,适合事先不知道总长度的场景,例如边生成边返回的页面。HTTP/2 有自己的分帧机制,不再使用分块传输编码。 ### 多部分对象集合 @@ -726,11 +808,9 @@ HTTP/1.1 使用虚拟主机技术,使得一台服务器拥有多个域名, - 用户察觉得到正向代理的存在。 -

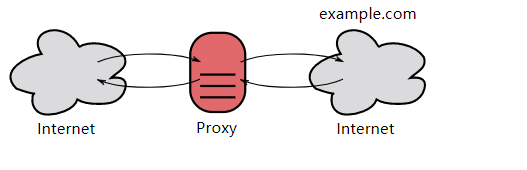
- - 而反向代理一般位于内部网络中,用户察觉不到。 -

+

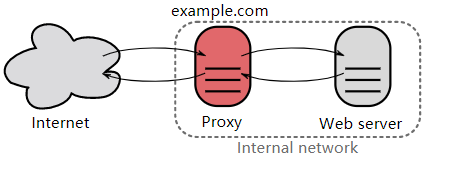
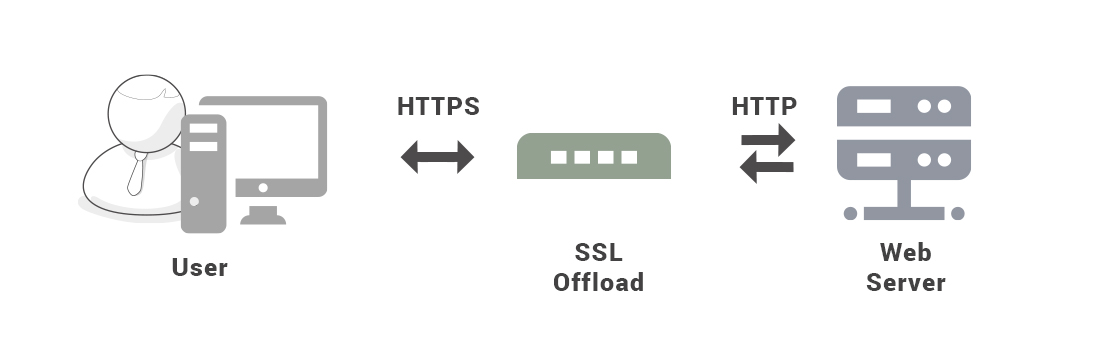
#### 2. 网关 @@ -740,6 +820,68 @@ HTTP/1.1 使用虚拟主机技术,使得一台服务器拥有多个域名, 使用 SSL 等加密手段,在客户端和服务器之间建立一条安全的通信线路。 +### WebSocket + +HTTP 是请求-响应模式,服务器不能主动给客户端发消息。聊天、实时通知这类场景以前只能轮询:短轮询定时发请求,大部分请求都是空的;长轮询让服务器挂起请求,直到有新消息再响应,但每条消息仍要一次新的请求。WebSocket 在一个 TCP 连接上提供全双工通信,建立连接后双方随时都可以发送消息。 + +WebSocket 连接由一次 HTTP 请求升级而来: + +```text +GET /chat HTTP/1.1 +Host: www.example.com +Upgrade: websocket +Connection: Upgrade +Sec-WebSocket-Key: Y3Mtbm90ZXMtMjAyNi0xMA== +Sec-WebSocket-Version: 13 + +HTTP/1.1 101 Switching Protocols +Upgrade: websocket +Connection: Upgrade +Sec-WebSocket-Accept: N5dfgp7eKvv+Po1vS+eAAHg5F1I= +``` + +Sec-WebSocket-Key 是客户端随机生成的 16 字节的 Base64 编码。服务器在它后面拼上协议规定的 GUID 258EAFA5-E914-47DA-95CA-C5AB0DC85B11,计算 SHA-1 后再做 Base64 编码,作为 Sec-WebSocket-Accept 返回,证明自己确实支持 WebSocket,而不是把请求当作普通的 HTTP 请求处理。之后连接上传输的不再是 HTTP 报文,而是 WebSocket 帧,帧头最短只有 2 字节,不用像 HTTP 那样每次都携带首部。 + +需要注意的是,长时间没有数据时,中间的代理或 NAT 可能会断开空闲的连接,所以通常定时发送 Ping 帧,对方回复 Pong 帧,以此保活并发现已经断开的连接。 + +SSE(Server-Sent Events)是另一种服务器推送方式:它是一个普通的 HTTP 响应,服务器不断地往响应中写入文本事件,只能由服务器发给客户端,浏览器断开后会自动重连。只需要服务器单向推送时(例如大模型逐字输出),SSE 更简单;客户端和服务器都需要随时发消息时(例如聊天、协同编辑),使用 WebSocket。 + +### 跨域 + +同源指的是协议、域名和端口都相同。浏览器的同源策略限制网页中的脚本读取其它源的响应,例如 https://shop.example.com 页面中的脚本请求 https://api.example.com/orders,请求能够发出去,但浏览器默认不把响应交给脚本。 + +跨域资源共享(Cross-Origin Resource Sharing, CORS)指的是服务器通过响应首部声明允许哪些源读取响应: + +```text +GET /orders HTTP/1.1 +Host: api.example.com +Origin: https://shop.example.com + +HTTP/1.1 200 OK +Access-Control-Allow-Origin: https://shop.example.com +``` + +GET、HEAD 和表单形式的 POST 这类简单请求直接发送;其它请求,例如 PUT 或者 Content-Type 为 application/json 的 POST,浏览器会先发一个 OPTIONS 预检请求,询问服务器是否允许,允许之后才发送真正的请求: + +```text +OPTIONS /orders/1024 HTTP/1.1 +Origin: https://shop.example.com +Access-Control-Request-Method: PUT +Access-Control-Request-Headers: content-type + +HTTP/1.1 204 No Content +Access-Control-Allow-Origin: https://shop.example.com +Access-Control-Allow-Methods: GET, PUT +Access-Control-Allow-Headers: content-type +Access-Control-Max-Age: 600 +``` + +Access-Control-Max-Age 表示预检结果可以缓存的秒数,期间相同的请求不再预检。跨域请求默认不携带 Cookie,前端设置 credentials: 'include' 后,服务器还要返回 Access-Control-Allow-Credentials: true,并且 Access-Control-Allow-Origin 不能是 *,必须写明具体的源。 + +在本机用两个端口模拟两个源,用 Edge 验证:服务器不返回 Access-Control-Allow-Origin 时,fetch 失败,但服务器的日志显示请求已经执行了;预检请求没有允许 PUT 时,浏览器不再发送 PUT;携带 Cookie 而服务器返回 * 时,fetch 同样失败。 + +需要注意的是,CORS 只决定浏览器是否把响应交给脚本,并不是安全措施:服务器仍然执行了请求,curl 这类不经过浏览器的工具也完全不受限制,权限要靠认证和 [CSRF 防护](攻击技术.md#二跨站请求伪造) 保证。另一种解决跨域的办法是同源的反向代理,例如由 Nginx 把 https://shop.example.com/api 转发给后端,浏览器看到的就是同源的请求。 + ## 六、HTTPS HTTP 有以下安全性问题: @@ -754,7 +896,7 @@ HTTPS 并不是新协议,而是让 HTTP 先和 SSL(Secure Sockets Layer) 通过使用 SSL,HTTPS 具有了加密(防窃听)、认证(防伪装)和完整性保护(防篡改)。 -

+

### 加密 @@ -765,7 +907,7 @@ HTTPS 并不是新协议,而是让 HTTP 先和 SSL(Secure Sockets Layer) - 优点:运算速度快; - 缺点:无法安全地将密钥传输给通信方。 -

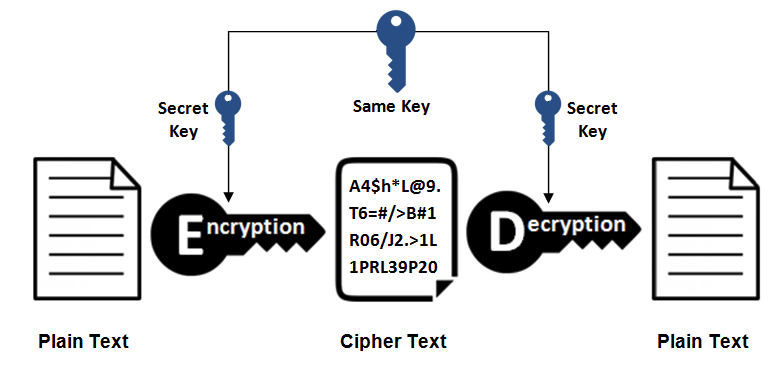
+

#### 2.非对称密钥加密 @@ -773,23 +915,23 @@ HTTPS 并不是新协议,而是让 HTTP 先和 SSL(Secure Sockets Layer) 公开密钥所有人都可以获得,通信发送方获得接收方的公开密钥之后,就可以使用公开密钥进行加密,接收方收到通信内容后使用私有密钥解密。 -非对称密钥除了用来加密,还可以用来进行签名。因为私有密钥无法被其他人获取,因此通信发送方使用其私有密钥进行签名,通信接收方使用发送方的公开密钥对签名进行解密,就能判断这个签名是否正确。 +非对称密钥除了用来加密,还可以用来进行签名。因为私有密钥无法被其他人获取,因此通信发送方使用其私有密钥进行签名,通信接收方使用发送方的公开密钥对签名进行验证,就能判断这个签名是否正确。 - 优点:可以更安全地将公开密钥传输给通信发送方; - 缺点:运算速度慢。 -

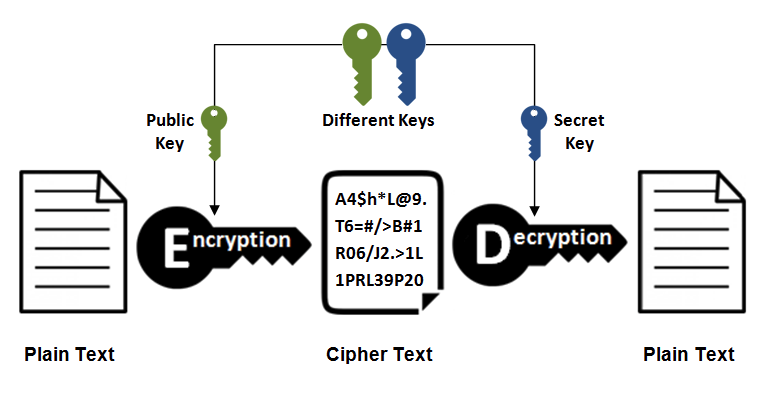
+

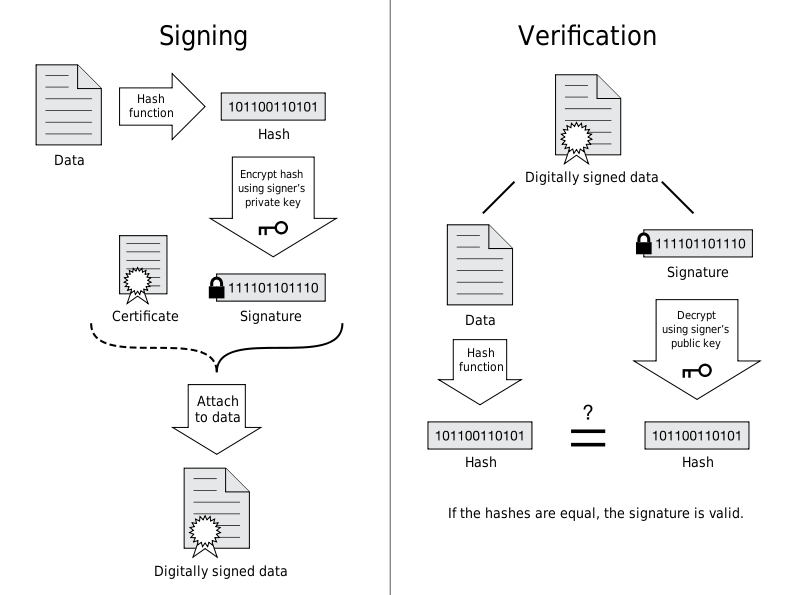
#### 3. HTTPS 采用的加密方式 -上面提到对称密钥加密方式的传输效率更高,但是无法安全地将密钥 Secret Key 传输给通信方。而非对称密钥加密方式可以保证传输的安全性,因此我们可以利用非对称密钥加密方式将 Secret Key 传输给通信方。HTTPS 采用混合的加密机制,正是利用了上面提到的方案: +上面提到对称密钥加密方式的传输效率更高,但是无法安全地将密钥 Secret Key 传输给通信方。而非对称密钥加密方式可以保证传输的安全性,因此可以利用非对称密钥加密方式将 Secret Key 传输给通信方。HTTPS 采用混合的加密机制,正是利用了上面提到的方案: - 使用非对称密钥加密方式,传输对称密钥加密方式所需要的 Secret Key,从而保证安全性; -- 获取到 Secret Key 后,再使用对称密钥加密方式进行通信,从而保证效率。(下图中的 Session Key 就是 Secret Key) +- 获取到 Secret Key 后,再使用对称密钥加密方式进行通信,从而保证效率。(下图中的会话密钥就是 Secret Key) 需要注意的是,TLS 1.3 不再用公钥加密传输对称密钥,而是通过 ECDHE 密钥交换协商出会话密钥,非对称密钥只用于签名认证。 -

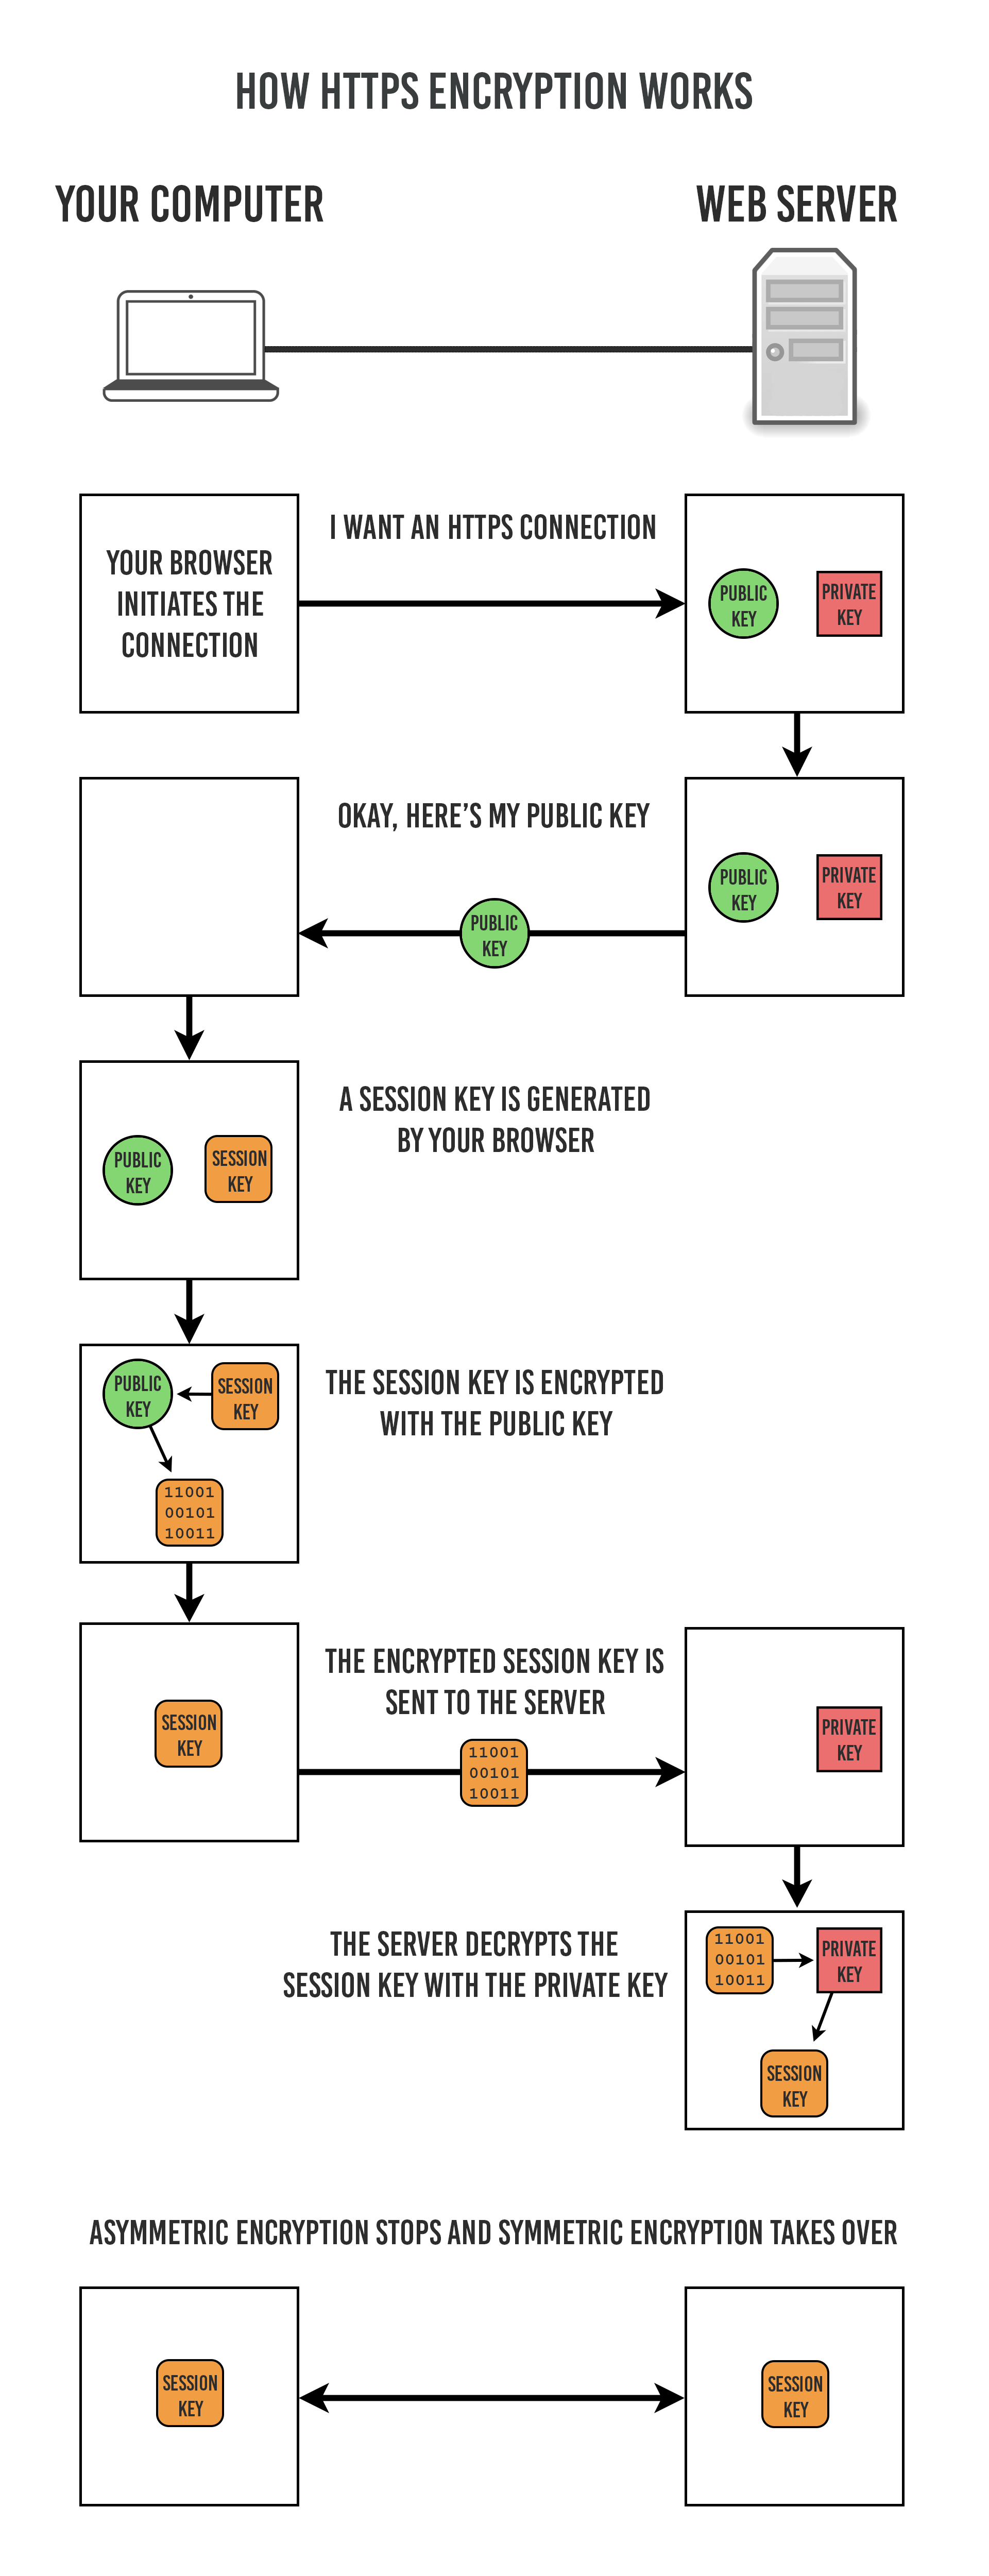
+

### 认证 @@ -801,7 +943,17 @@ HTTPS 并不是新协议,而是让 HTTP 先和 SSL(Secure Sockets Layer) 进行 HTTPS 通信时,服务器会把证书发送给客户端。客户端取得其中的公开密钥之后,先使用数字签名进行验证,如果验证通过,就可以开始通信了。 -

+

+ +### TLS 握手 + +TLS 握手完成三件事:协商加密算法、验证服务器的证书、协商出会话密钥。目前常用的密钥交换方式是 ECDHE:双方各自临时生成一对椭圆曲线密钥,把公钥发给对方,再用自己的私钥和对方的公钥算出相同的共享密钥。会话密钥本身从不在网络上传输,即使服务器的证书私钥日后泄露,之前录下的通信也无法解密,称为前向安全。服务器还要用证书的私钥对握手内容签名,证明自己就是证书的持有者。 + +下图是本机用 openssl s_client 连接两个网站时记录的握手报文: + +

+ +TLS 1.2 要 2 个 RTT 之后才能发送 HTTP 请求。TLS 1.3 把 ECDHE 公钥直接放在 ClientHello 中,服务器回复 ServerHello 时双方就能算出密钥,之后的握手报文(图中花括号内)都已加密,1 个 RTT 后就能发送请求;TLS 1.3 还去掉了 RSA 密钥交换等不安全的算法。 ### 完整性保护 @@ -809,7 +961,7 @@ SSL 提供报文摘要功能来进行完整性保护。 HTTP 也提供了 MD5 报文摘要功能,但不是安全的。例如报文内容被篡改之后,同时重新计算 MD5 的值,通信接收方是无法意识到发生了篡改。 -HTTPS 的报文摘要功能之所以安全,是因为它结合了加密和认证这两个操作。试想一下,加密之后的报文,遭到篡改之后,也很难重新计算报文摘要,因为无法轻易获取明文。 +HTTPS 的报文摘要功能之所以安全,是因为计算摘要时用到了握手协商出的会话密钥(HMAC,或者 AES-GCM 等算法自带的认证标签)。攻击者没有这个密钥,篡改报文之后无法算出正确的摘要,接收方校验失败就会断开连接。 ### HTTPS 的缺点 @@ -830,7 +982,7 @@ HTTP/1.x 实现简单是以牺牲性能为代价的: HTTP/2.0 将报文分成 HEADERS 帧和 DATA 帧,它们都是二进制格式的。 -

+

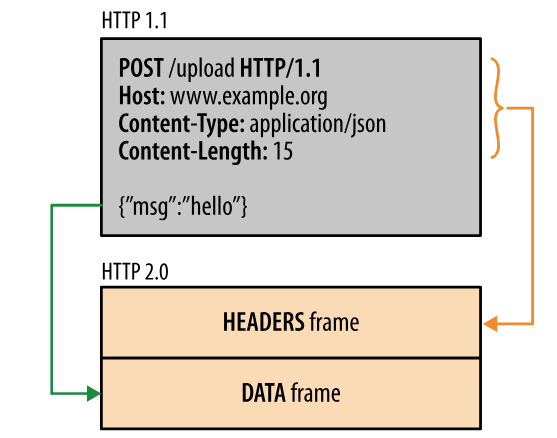
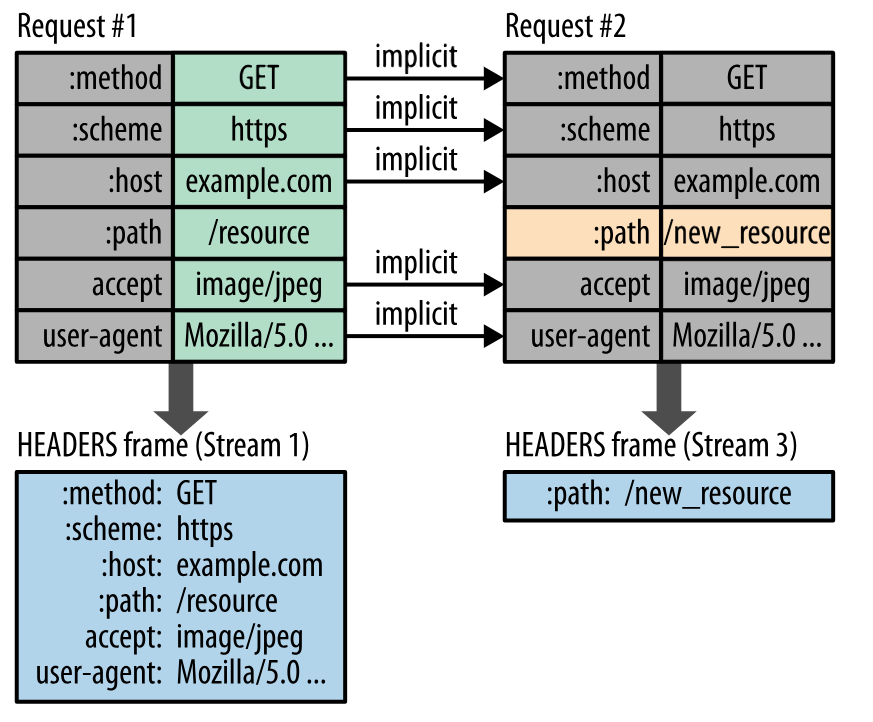
在通信过程中,只会有一个 TCP 连接存在,它承载了任意数量的双向数据流(Stream)。 @@ -838,13 +990,13 @@ HTTP/2.0 将报文分成 HEADERS 帧和 DATA 帧,它们都是二进制格式 - 消息(Message)是与逻辑请求或响应对应的完整的一系列帧。 - 帧(Frame)是最小的通信单位,来自不同数据流的帧可以交错发送,然后再根据每个帧头的数据流标识符重新组装。 -

+

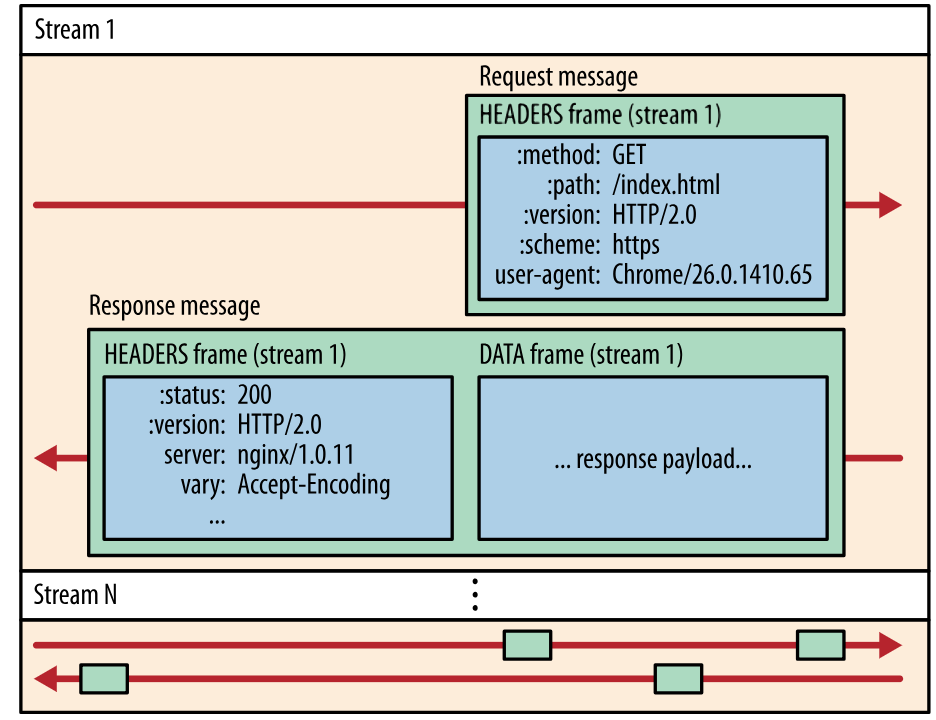
### 服务端推送 HTTP/2.0 在客户端请求一个资源时,会把相关的资源一起发送给客户端,客户端就不需要再次发起请求了。例如客户端请求 page.html 页面,服务端就把 script.js 和 style.css 等与之相关的资源一起发给客户端。 -

+

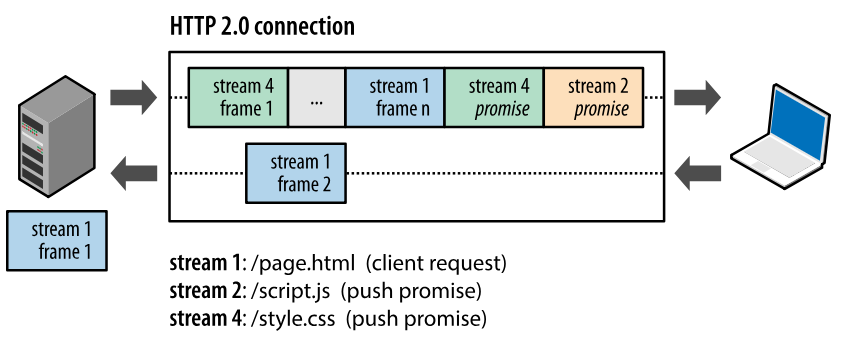
需要注意的是,Chrome 106 起默认禁用了服务端推送,其它基于 Chromium 的浏览器也随之跟进。 @@ -856,7 +1008,19 @@ HTTP/2.0 要求客户端和服务器同时维护和更新一个包含之前见 不仅如此,HTTP/2.0 也使用 Huffman 编码对首部字段进行压缩。 -

+

+ +### HTTP/3 + +HTTP/2 在一个 TCP 连接上复用多个流,但 TCP 只保证整个字节流按序到达:一个报文段丢失时,后面已经到达的数据也要等它重传,所有的流都被阻塞,称为队头阻塞。 + +HTTP/3 改为基于 UDP 的 QUIC 协议: + +- 每个流单独保证顺序,一个流丢包不影响其它流; +- QUIC 内置了 TLS 1.3,传输层握手和加密握手合并,新连接 1 个 RTT 后就能发送请求,恢复之前的会话时可以 0 RTT; +- 连接用连接 ID 标识,而不是 IP 地址和端口,手机从 Wi-Fi 切换到移动网络时连接不用重建。 + +浏览器通常先用 HTTP/2 访问,从响应首部 Alt-Svc 得知服务器支持 HTTP/3 后再切换,例如 www.example.com 的响应中有 alt-svc: h3=":443"; ma=86400。 ## 八、HTTP/1.1 新特性 @@ -889,6 +1053,8 @@ GET /test/demo_form.asp?name1=value1&name2=value2 HTTP/1.1 ```http POST /test/demo_form.asp HTTP/1.1 Host: w3schools.com +Content-Type: application/x-www-form-urlencoded + name1=value1&name2=value2 ``` @@ -922,7 +1088,7 @@ GET /pageX HTTP/1.1 POST /add_row HTTP/1.1 不是幂等的,如果调用多次,就会增加多行记录: ```text -POST /add_row HTTP/1.1 -> Adds a 1nd row +POST /add_row HTTP/1.1 -> Adds a 1st row POST /add_row HTTP/1.1 -> Adds a 2nd row POST /add_row HTTP/1.1 -> Adds a 3rd row ``` @@ -945,42 +1111,46 @@ DELETE /idX/delete HTTP/1.1 -> Returns 404 ### XMLHttpRequest -为了阐述 POST 和 GET 的另一个区别,需要先了解 XMLHttpRequest: - -> XMLHttpRequest 是一个 API,它为客户端提供了在客户端和服务器之间传输数据的功能。它提供了一个通过 URL 来获取数据的简单方式,并且不会使整个页面刷新。这使得网页只更新一部分页面而不会打扰到用户。XMLHttpRequest 在 AJAX 中被大量使用。 +XMLHttpRequest 是浏览器提供的 API,用于在不刷新页面的情况下向服务器发送请求,是 AJAX 的基础,现在更常用的是 fetch()。 -- 在使用 XMLHttpRequest 的 POST 方法时,浏览器会先发送 Header 再发送 Data。但并不是所有浏览器会这么做,例如火狐就不会。 -- 而 GET 方法 Header 和 Data 会一起发送。 +网上流传一种说法:XMLHttpRequest 发送 POST 时,会先发送首部,再单独发送请求体,GET 则一次发完。HTTP 规范中没有这样的规定,这只是个别浏览器早期的实现细节,不能作为 GET 和 POST 的区别。在本机用 Edge 记录网络日志(--log-net-log),通过 XMLHttpRequest 发送一个带 21 字节请求体的 POST 请求,首部和请求体是在同一次 socket 写入中发出的,共 723 字节。 ## 参考资料 - [RFC 7519: JSON Web Token (JWT)](https://www.rfc-editor.org/rfc/rfc7519) +- [RFC 6749: The OAuth 2.0 Authorization Framework](https://www.rfc-editor.org/rfc/rfc6749) +- [RFC 7636: Proof Key for Code Exchange (PKCE)](https://www.rfc-editor.org/rfc/rfc7636) +- [RFC 9700: Best Current Practice for OAuth 2.0 Security](https://www.rfc-editor.org/rfc/rfc9700) - [OWASP: JSON Web Token Cheat Sheet](https://cheatsheetseries.owasp.org/cheatsheets/JSON_Web_Token_Cheat_Sheet.html) - [OWASP: HTML5 Security Cheat Sheet](https://cheatsheetseries.owasp.org/cheatsheets/HTML5_Security_Cheat_Sheet.html) - 上野宣. 图解 HTTP[M]. 人民邮电出版社, 2014. - [MDN : HTTP](https://developer.mozilla.org/en-US/docs/Web/HTTP) +- [MDN : Cross-Origin Resource Sharing (CORS)](https://developer.mozilla.org/en-US/docs/Web/HTTP/CORS) - [HTTP/2 简介](https://developers.google.com/web/fundamentals/performance/http2/?hl=zh-cn) - [htmlspecialchars](http://php.net/manual/zh/function.htmlspecialchars.php) -- [Difference between file URI and URL in java](http://java2db.com/java-io/how-to-get-and-the-difference-between-file-uri-and-url-in-java) +- [Difference between file URI and URL in java](https://web.archive.org/web/20191216080403/http://java2db.com:80/java-io/how-to-get-and-the-difference-between-file-uri-and-url-in-java) - [How to Fix SQL Injection Using Java PreparedStatement & CallableStatement](https://software-security.sans.org/developer-how-to/fix-sql-injection-in-java-using-prepared-callable-statement) - [浅谈 HTTP 中 Get 与 Post 的区别](https://www.cnblogs.com/hyddd/archive/2009/03/31/1426026.html) - [Are http:// and www really necessary?](https://www.webdancers.com/are-http-and-www-necesary/) -- [HTTP (HyperText Transfer Protocol)](https://www.ntu.edu.sg/home/ehchua/programming/webprogramming/HTTP_Basics.html) +- [HTTP (HyperText Transfer Protocol)](https://www3.ntu.edu.sg/home/ehchua/programming/webprogramming/HTTP_Basics.html) - [Web-VPN: Secure Proxies with SPDY & Chrome](https://www.igvita.com/2011/12/01/web-vpn-secure-proxies-with-spdy-chrome/) - [File:HTTP persistent connection.svg](http://en.wikipedia.org/wiki/File:HTTP_persistent_connection.svg) - [Proxy server](https://en.wikipedia.org/wiki/Proxy_server) - [What Is This HTTPS/SSL Thing And Why Should You Care?](https://www.x-cart.com/blog/what-is-https-and-ssl.html) -- [What is SSL Offloading?](https://securebox.comodo.com/ssl-sniffing/ssl-offloading/) - [Sun Directory Server Enterprise Edition 7.0 Reference - Key Encryption](https://docs.oracle.com/cd/E19424-01/820-4811/6ng8i26bn/index.html) - [An Introduction to Mutual SSL Authentication](https://www.codeproject.com/Articles/326574/An-Introduction-to-Mutual-SSL-Authentication) - [The Difference Between URLs and URIs](https://danielmiessler.com/study/url-uri/) - [Cookie 与 Session 的区别](https://juejin.im/entry/5766c29d6be3ff006a31b84e#comment) - [COOKIE 和 SESSION 有什么区别](https://www.zhihu.com/question/19786827) - [Cookie/Session 的机制与安全](https://harttle.land/2015/08/10/cookie-session.html) -- [HTTPS 证书原理](https://shijianan.com/2017/06/11/https/) - [What is the difference between a URI, a URL and a URN?](https://stackoverflow.com/questions/176264/what-is-the-difference-between-a-uri-a-url-and-a-urn) - [XMLHttpRequest](https://developer.mozilla.org/zh-CN/docs/Web/API/XMLHttpRequest) - [XMLHttpRequest (XHR) Uses Multiple Packets for HTTP POST?](https://blog.josephscott.org/2009/08/27/xmlhttprequest-xhr-uses-multiple-packets-for-http-post/) - [Symmetric vs. Asymmetric Encryption – What are differences?](https://www.ssl2buy.com/wiki/symmetric-vs-asymmetric-encryption-what-are-differences) - [Web 性能优化与 HTTP/2](https://www.kancloud.cn/digest/web-performance-http2) - [HTTP/2 简介](https://developers.google.com/web/fundamentals/performance/http2/?hl=zh-cn) +- [RFC 8446: The Transport Layer Security (TLS) Protocol Version 1.3](https://www.rfc-editor.org/rfc/rfc8446) +- [RFC 7541: HPACK: Header Compression for HTTP/2](https://www.rfc-editor.org/rfc/rfc7541) +- [RFC 9114: HTTP/3](https://www.rfc-editor.org/rfc/rfc9114) +- [RFC 9000: QUIC](https://www.rfc-editor.org/rfc/rfc9000) +- [RFC 6455: The WebSocket Protocol](https://www.rfc-editor.org/rfc/rfc6455) diff --git a/notes/Java IO.md b/notes/Java IO.md index 491b7357c..e8c8ea475 100644 --- a/notes/Java IO.md +++ b/notes/Java IO.md @@ -617,6 +617,6 @@ NIO 与普通 I/O 的区别主要有以下两点: - [IBM: 深入分析 Java I/O 的工作机制](https://www.ibm.com/developerworks/cn/java/j-lo-javaio/index.html) - [IBM: 深入分析 Java 中的中文编码问题](https://www.ibm.com/developerworks/cn/java/j-lo-chinesecoding/index.html) - [IBM: Java 序列化的高级认识](https://www.ibm.com/developerworks/cn/java/j-lo-serial/index.html) -- [NIO 与传统 IO 的区别](http://blog.csdn.net/shimiso/article/details/24990499) +- [NIO 与传统 IO 的区别](https://web.archive.org/web/20250917122905/https://blog.csdn.net/shimiso/article/details/24990499) - [Decorator Design Pattern](http://stg-tud.github.io/sedc/Lecture/ws13-14/5.3-Decorator.html#mode=document) - [Socket Multicast](http://labojava.blogspot.com/2012/12/socket-multicast.html) diff --git "a/notes/Java \345\237\272\347\241\200.md" "b/notes/Java \345\237\272\347\241\200.md" index 7d8dc70ff..8f006ed40 100644 --- "a/notes/Java \345\237\272\347\241\200.md" +++ "b/notes/Java \345\237\272\347\241\200.md" @@ -256,7 +256,7 @@ System.out.println(s5 == s6); // true 使用这种方式一共会创建两个字符串对象(前提是 String Pool 中还没有 "abc" 字符串对象)。 -- "abc" 属于字符串字面量,因此编译时期会在 String Pool 中创建一个字符串对象,指向这个 "abc" 字符串字面量; +- "abc" 属于字符串字面量,编译时记录在 class 文件的常量池中,HotSpot 在运行时第一次执行到对应的 ldc 指令时,才在 String Pool 中创建这个字符串对象,之后再执行就直接复用; - 而使用 new 的方式会在堆中创建一个字符串对象。 创建一个测试类,其 main 方法中使用这种方式来创建字符串对象。 @@ -295,7 +295,7 @@ Constant pool: // ... ``` -在 Constant Pool 中,#19 存储这字符串字面量 "abc",#3 是 String Pool 的字符串对象,它指向 #19 这个字符串字面量。在 main 方法中,0: 行使用 new #2 在堆中创建一个字符串对象,并且使用 ldc #3 将 String Pool 中的字符串对象作为 String 构造函数的参数。 +在 class 文件的常量池中,#19 存储字符串字面量 "abc",#3 是 String 类型的常量,它指向 #19;运行时解析 #3 得到的就是 String Pool 中的字符串对象。在 main 方法中,0: 行使用 new #2 在堆中创建一个字符串对象,并且使用 ldc #3 将 String Pool 中的字符串对象作为 String 构造函数的参数。 以下是 String 构造函数的源码,可以看到,在将一个字符串对象作为另一个字符串对象的构造函数参数时,并不会完全复制 value 数组内容,而是都会指向同一个 value 数组。 @@ -1384,7 +1384,7 @@ Throwable 可以用来表示任何可以作为异常抛出的类,分为两种 - **受检异常** :需要用 try...catch... 语句捕获并进行处理,或者用 throws 声明抛出,并且可以从异常中恢复; - **非受检异常** :是程序运行时错误,例如除 0 会引发 ArithmeticException。编译器不强制处理这类异常,通常应该修改代码来避免,而不是捕获之后恢复。 -

+

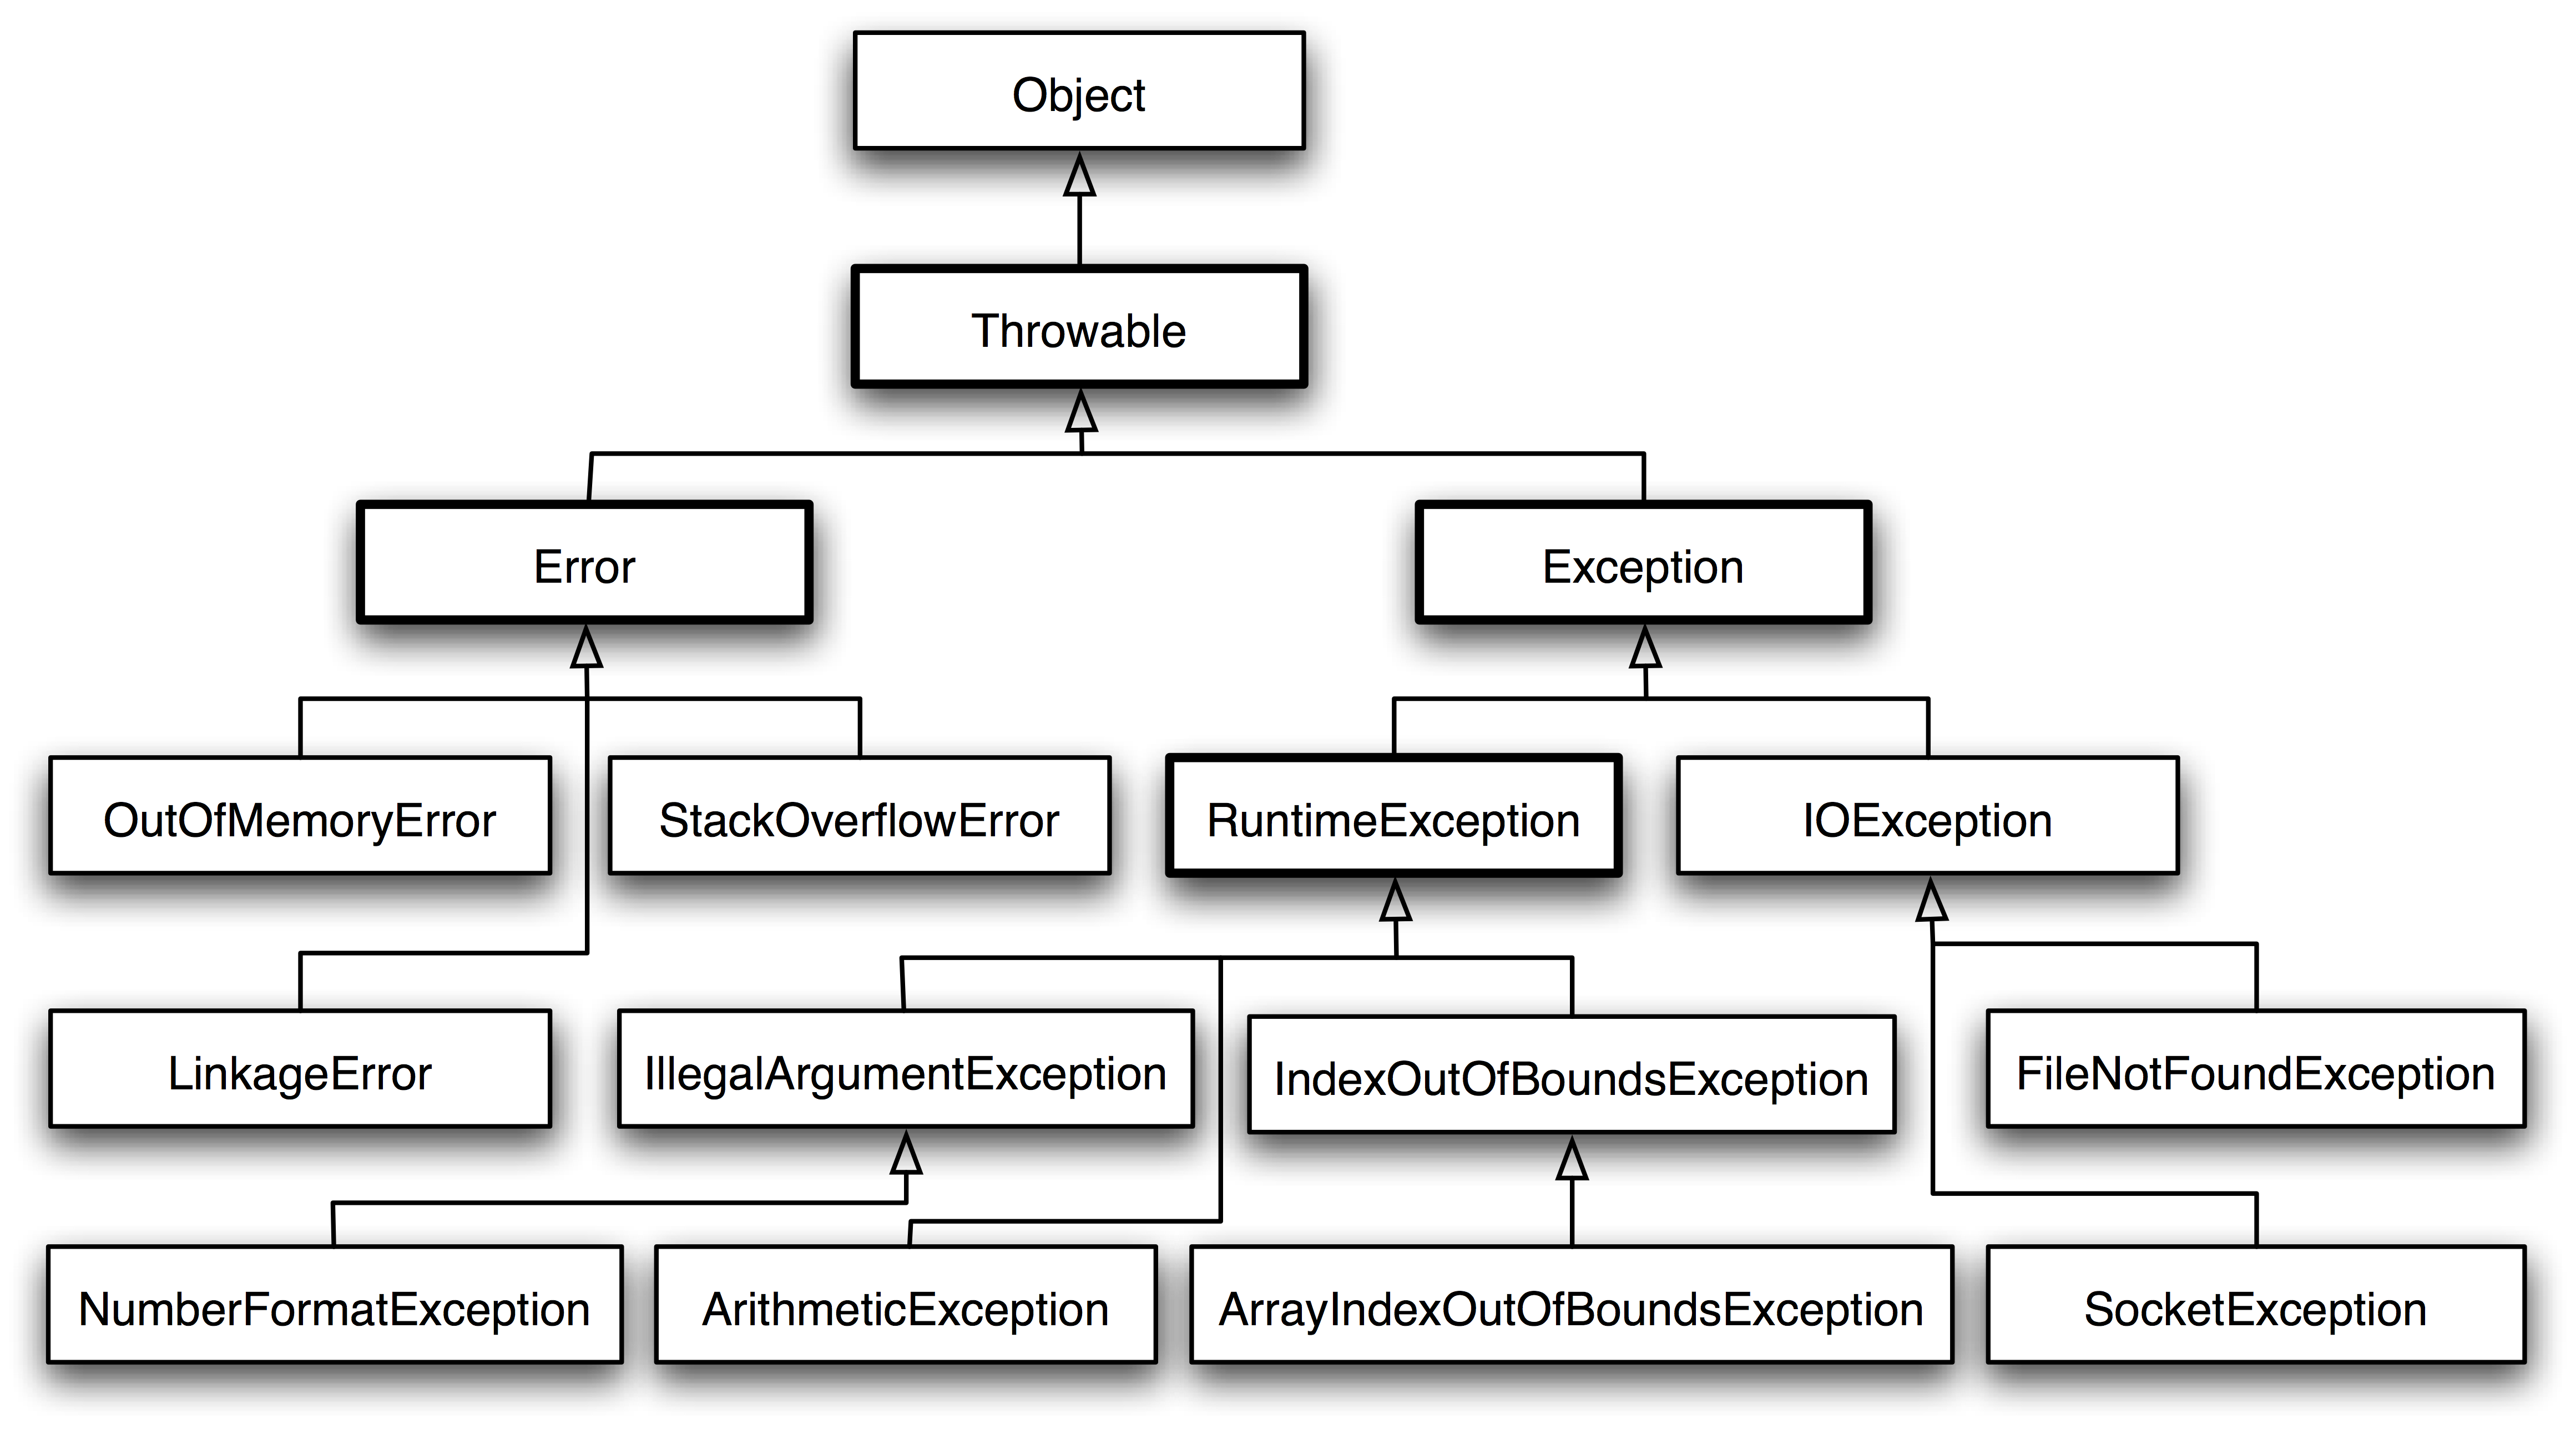
- [Java Exception Interview Questions and Answers](https://www.journaldev.com/2167/java-exception-interview-questions-and-answers) @@ -1414,35 +1414,44 @@ Java 注解是附加在代码中的一些元信息,用于一些工具在编译 ### Java 各版本的新特性 -**New highlights in Java SE 8** +目前常用的是长期支持(LTS)版本 8、11、17、21,面试中最常问 Java 8 和 Java 21: -1. Lambda Expressions -2. Pipelines and Streams -3. Date and Time API -4. Default Methods -5. Type Annotations -6. Nashorn JavaScript Engine -7. Concurrent Accumulators -8. Parallel operations -9. PermGen Error Removed +| 版本 | 与上一个长期支持版本相比的主要新特性 | +| --- | --- | +| Java 8(2014) | Lambda 表达式、Stream、Optional、新的日期时间 API(java.time)、接口默认方法;永久代被元空间取代 | +| Java 11(2018) | var 用于 Lambda 参数(var 本身在 Java 10 引入)、标准化的 HttpClient、String 新增 isBlank、strip、repeat 等方法 | +| Java 17(2021) | 记录类(record)、密封类(sealed)、文本块、instanceof 模式匹配、新的 switch 表达式 | +| Java 21(2023) | 虚拟线程、switch 模式匹配、记录模式、有序集合接口 SequencedCollection | -**New highlights in Java SE 7** +以下代码在 JDK 21 上编译运行,用到了其中的大部分特性: -1. Strings in Switch Statement -2. Type Inference for Generic Instance Creation -3. Multiple Exception Handling -4. Support for Dynamic Languages -5. Try with Resources -6. Java nio Package -7. Binary Literals, Underscore in literals -8. Diamond Syntax +```java +sealed interface Shape permits Circle, Square {} +record Circle(double r) implements Shape {} +record Square(double side) implements Shape {} + +static double area(Shape s) { + return switch (s) { // switch 模式匹配,编译器检查是否覆盖了所有子类 + case Circle c -> Math.PI * c.r() * c.r(); + case Square(double side) -> side * side; // 记录模式,直接取出字段 + }; +} -- [Difference between Java 1.8 and Java 1.7?](http://www.selfgrowth.com/articles/difference-between-java-18-and-java-17) -- [Java 8 特性](http://www.importnew.com/19345.html) +var upper = List.of("redis", "mysql", "kafka", "java").stream() + .filter(w -> w.length() == 5) + .map(String::toUpperCase) + .collect(Collectors.toList()); // [REDIS, MYSQL, KAFKA] + +Thread.ofVirtual().start(() -> System.out.println(Thread.currentThread().isVirtual())); // true +``` + +Lambda 表达式不会生成匿名内部类的 class 文件。用 javap 查看编译结果,Lambda 的方法体被编译成当前类的私有静态方法 lambda$main$0,调用处是一条 invokedynamic 指令,第一次执行时由 LambdaMetafactory 在运行时生成实现函数式接口的类。 + +Stream 是惰性求值的:filter、map 等中间操作只是记录下来,遇到 collect、findFirst 等终止操作才开始执行,并且每个元素依次走完整条流水线。上例改为 findFirst() 时,只处理了第一个元素 redis 就返回了,后面的 mysql、kafka 都没有被处理。 ### Java 与 C++ 的区别 -- Java 是纯粹的面向对象语言,所有的对象都继承自 java.lang.Object,C++ 为了兼容 C 即支持面向对象也支持面向过程。 +- Java 的代码都写在类中,除了基本类型之外,所有的对象都继承自 java.lang.Object;C++ 为了兼容 C,既支持面向对象也支持面向过程。 - Java 通过虚拟机从而实现跨平台特性,但是 C++ 依赖于特定的平台。 - Java 没有指针,它的引用可以理解为安全指针,而 C++ 具有和 C 一样的指针。 - Java 支持自动垃圾回收,而 C++ 需要手动回收。 @@ -1452,6 +1461,16 @@ Java 注解是附加在代码中的一些元信息,用于一些工具在编译 [What are the main differences between Java and C++?](http://cs-fundamentals.com/tech-interview/java/differences-between-java-and-cpp.php) +与 Go、Python 相比: + +| | Java | Go | Python(CPython) | +| --- | --- | --- | --- | +| 执行方式 | 编译为字节码,由 JVM 解释执行,热点代码由 JIT 编译为机器码 | 直接编译为机器码,生成一个可执行文件,启动快 | 编译为字节码,由解释器执行,3.13 起有实验性的 JIT | +| 类型检查 | 静态类型,编译时检查 | 静态类型,编译时检查 | 动态类型,运行时才发现类型错误 | +| 并发 | 线程对应操作系统线程,JDK 21 起有虚拟线程 | goroutine 由运行时调度到少量线程上,用 channel 通信 | 有全局解释器锁(GIL),同一时刻只有一个线程执行 Python 代码,CPU 密集型任务要用多进程;3.13 起提供去掉 GIL 的版本,3.14 起正式支持,但不是默认版本 | +| 内存回收 | 分代的垃圾收集器,可以选择 G1、ZGC 等 | 与程序并发执行的标记清除,不移动对象 | 以引用计数为主,计数为 0 时立即释放,再用垃圾收集器处理循环引用 | +| 错误处理 | 异常 | 函数返回 error 值,由调用方检查 | 异常 | + ### JRE or JDK - JRE:Java Runtime Environment,Java 运行环境的简称,为 Java 的运行提供了所需的环境。它是一个 JVM 程序,主要包括了 JVM 的标准实现和一些 Java 基本类库。 @@ -1461,3 +1480,8 @@ Java 注解是附加在代码中的一些元信息,用于一些工具在编译 - Eckel B. Java 编程思想[M]. 机械工业出版社, 2002. - Bloch J. Effective java[M]. Addison-Wesley Professional, 2017. +- [JEP 441: Pattern Matching for switch](https://openjdk.org/jeps/441) +- [JEP 444: Virtual Threads](https://openjdk.org/jeps/444) +- [PEP 703: Making the Global Interpreter Lock Optional in CPython](https://peps.python.org/pep-0703/) +- [What’s New in Python 3.14](https://docs.python.org/3/whatsnew/3.14.html) +- [A Guide to the Go Garbage Collector](https://go.dev/doc/gc-guide) diff --git "a/notes/Java \345\256\271\345\231\250.md" "b/notes/Java \345\256\271\345\231\250.md" index 600f36e29..99d88f898 100644 --- "a/notes/Java \345\256\271\345\231\250.md" +++ "b/notes/Java \345\256\271\345\231\250.md" @@ -498,9 +498,9 @@ map.put("K3", "V3"); ``` - 新建一个 HashMap,默认大小为 16; -- 插入 <K1,V1\> 键值对,先计算 K1 的 hashCode 为 115,使用除留余数法得到所在的桶下标 115%16=3。 -- 插入 <K2,V2\> 键值对,先计算 K2 的 hashCode 为 118,使用除留余数法得到所在的桶下标 118%16=6。 -- 插入 <K3,V3\> 键值对,先计算 K3 的 hashCode 为 118,使用除留余数法得到所在的桶下标 118%16=6,插在 <K2,V2\> 前面。 +- 插入 <K1,V1\> 键值对,先计算 K1 的 hashCode,为了便于说明,假设为 115(实际上 "K1".hashCode() 是 2374),使用除留余数法得到所在的桶下标 115%16=3。 +- 插入 <K2,V2\> 键值对,假设 K2 的 hashCode 为 118,使用除留余数法得到所在的桶下标 118%16=6。 +- 插入 <K3,V3\> 键值对,假设 K3 的 hashCode 也为 118,使用除留余数法得到所在的桶下标 118%16=6,插在 <K2,V2\> 前面。 应该注意到链表的插入是以头插法方式进行的,例如上面的 <K3,V3\> 不是插在 <K2,V2\> 后面,而是插入在链表头部。JDK 1.8 改成了尾插法。 @@ -754,7 +754,7 @@ new capacity : 00100000 - 为 0,那么 hash%00010000 = hash%00100000,桶位置和原来一致; - 为 1,hash%00100000 = hash%00010000 + 16,桶位置是原位置 + 16。 -

+

#### 7. 计算数组容量 @@ -800,6 +800,12 @@ static final int tableSizeFor(int cap) { - HashMap 的迭代器是 fail-fast 迭代器。 - HashMap 不能保证随着时间的推移 Map 中的元素次序是不变的。 +#### 10. 线程安全 + +HashMap 不是线程安全的。例如两个线程同时向同一个空桶插入,都判断桶为空,后写入的会覆盖先写入的;size++ 也不是原子操作。在 JDK 21 上用 8 个线程各插入 10 万个不同的键,HashMap 的 size 每次都不同,例如 281854、463269,远少于 80 万;同样的操作 ConcurrentHashMap 每次都是 800000。 + +JDK 1.7 的问题更严重:两个线程同时扩容时,头插法会把链表的顺序反转,可能让链表形成环,之后在这个桶上的 get 会陷入死循环。JDK 1.8 改为尾插法,扩容时保持链表原来的顺序,不会再成环,但并发写入仍然会丢失数据。多线程环境应该使用 ConcurrentHashMap。 + ### ConcurrentHashMap #### 1. 存储结构 @@ -926,9 +932,22 @@ public int size() { JDK 1.7 使用分段锁机制来实现并发更新操作,核心类为 Segment,它继承自重入锁 ReentrantLock,并发度与 Segment 数量相等。 -JDK 1.8 使用了 CAS 操作来支持更高的并发度,在 CAS 操作失败时使用内置锁 synchronized。 +JDK 1.8 去掉了 Segment,和 HashMap 一样使用 Node 数组加链表(或红黑树),锁的粒度缩小到每个桶。put 的过程如下: + +1. 用 spread() 计算哈希值,把 hashCode 的高 16 位异或到低 16 位,让高位也参与决定桶下标; +2. 如果桶是空的,用 CAS 把新节点放进去,不加锁。CAS 失败说明有其它线程刚刚放入了节点,重新循环; +3. 如果桶的头节点是 ForwardingNode(哈希值为 MOVED),说明正在扩容,当前线程先帮忙迁移数据; +4. 否则用 synchronized 锁住桶的头节点,在链表或红黑树中插入或更新,链表长度达到 8 时转为红黑树; +5. 最后更新元素个数。 + +get 不加锁:数组元素通过 Unsafe 的 volatile 方式读取,节点的 val 和 next 都是 volatile,能读到其它线程写入的最新值。 + +与 JDK 1.7 相比的其它变化: + +- 计数:元素个数保存在 baseCount 和一组 CounterCell 中,竞争激烈时不同线程更新不同的 CounterCell,size() 把它们加起来,与 LongAdder 的思路相同; +- 扩容:多个线程可以同时参与迁移,每个线程领取一段桶,迁移完的桶放一个 ForwardingNode,get 遇到它时到新数组中查找。 -并且 JDK 1.8 的实现也在链表过长时会转换为红黑树。 +需要注意的是,ConcurrentHashMap 的键和值都不能为 null。HashMap 中 get 返回 null 时,可以再用 containsKey 判断是键不存在还是值为 null;在并发环境下,这两次调用之间其它线程可能修改了数据,结果无法确定,所以干脆不允许 null。另外,ConcurrentHashMap 只保证单个操作是原子的,先 get 再 put 这样的组合操作仍然要用 putIfAbsent、compute 等原子方法。 ### LinkedHashMap @@ -1126,7 +1145,6 @@ public final class ConcurrentCache { - [Iterator 模式](https://openhome.cc/Gossip/DesignPattern/IteratorPattern.htm) - [Java 8 系列之重新认识 HashMap](https://tech.meituan.com/java_hashmap.html) - [What is difference between HashMap and Hashtable in Java?](http://javarevisited.blogspot.hk/2010/10/difference-between-hashmap-and.html) -- [Java 集合之 HashMap](http://www.zhangchangle.com/2018/02/07/Java%E9%9B%86%E5%90%88%E4%B9%8BHashMap/) - [The principle of ConcurrentHashMap analysis](http://www.programering.com/a/MDO3QDNwATM.html) - [探索 ConcurrentHashMap 高并发性的实现机制](https://www.ibm.com/developerworks/cn/java/java-lo-concurrenthashmap/) - [HashMap 相关面试题及其解答](https://www.jianshu.com/p/75adf47958a7) diff --git "a/notes/Java \345\271\266\345\217\221.md" "b/notes/Java \345\271\266\345\217\221.md" index 4bcfb2c07..d948c3101 100644 --- "a/notes/Java \345\271\266\345\217\221.md" +++ "b/notes/Java \345\271\266\345\217\221.md" @@ -21,6 +21,7 @@ * [ReentrantLock](#reentrantlock) * [比较](#比较) * [使用选择](#使用选择) + * [Java 中的锁](#java-中的锁) * [五、线程之间的协作](#五线程之间的协作) * [join()](#join) * [wait() notify() notifyAll()](#wait-notify-notifyall) @@ -39,6 +40,7 @@ * [Semaphore](#semaphore) * [八、J.U.C - 其它组件](#八juc---其它组件) * [FutureTask](#futuretask) + * [CompletableFuture](#completablefuture) * [BlockingQueue](#blockingqueue) * [ForkJoin](#forkjoin) * [九、线程不安全示例](#九线程不安全示例) @@ -121,7 +123,7 @@ public static void main(String[] args) throws ExecutionException, InterruptedExc ### 继承 Thread 类 -同样也是需要实现 run() 方法,因为 Thread 类也实现了 Runable 接口。 +同样也是需要实现 run() 方法,因为 Thread 类也实现了 Runnable 接口。 当调用 start() 方法启动一个线程时,虚拟机会将该线程放入就绪队列中等待被调度,当一个线程被调度时会执行该线程的 run() 方法。 @@ -155,7 +157,7 @@ Executor 管理多个异步任务的执行,而无需程序员显式地管理 主要有三种 Executor: -- CachedThreadPool:一个任务创建一个线程; +- CachedThreadPool:有空闲线程时复用,没有时为任务新建一个线程,线程空闲 60 秒后被回收; - FixedThreadPool:所有任务只能使用固定大小的线程; - SingleThreadExecutor:相当于大小为 1 的 FixedThreadPool。 @@ -290,7 +292,7 @@ public void run() { ### InterruptedException -通过调用一个线程的 interrupt() 来中断该线程,如果该线程处于阻塞、限期等待或者无限期等待状态,那么就会抛出 InterruptedException,从而提前结束该线程。但是不能中断 I/O 阻塞和 synchronized 锁阻塞。 +通过调用一个线程的 interrupt() 来中断该线程,如果该线程正在 sleep()、wait()、join() 等方法中处于限期等待或者无限期等待状态,那么就会抛出 InterruptedException,从而提前结束该线程。但是不能中断传统 I/O 的阻塞和等待 synchronized 锁的阻塞(BLOCKED)。 对于以下代码,在 main() 中启动一个线程之后再中断它,由于线程中调用了 Thread.sleep() 方法,因此会抛出一个 InterruptedException,从而提前结束线程,不执行之后的语句。 @@ -364,7 +366,7 @@ Thread end ### Executor 的中断操作 -调用 Executor 的 shutdown() 方法会等待线程都执行完毕之后再关闭,但是如果调用的是 shutdownNow() 方法,则相当于调用每个线程的 interrupt() 方法。 +调用 Executor 的 shutdown() 方法后,线程池不再接受新任务,已经提交的任务会继续执行完,它本身不会阻塞等待,需要等待时调用 awaitTermination();如果调用的是 shutdownNow() 方法,则相当于调用每个线程的 interrupt() 方法,并返回队列中还没有执行的任务。 以下使用 Lambda 创建线程,相当于创建了一个匿名内部线程。 @@ -590,7 +592,43 @@ synchronized 中的锁是非公平的,ReentrantLock 默认情况下也是非 ### 使用选择 -除非需要使用 ReentrantLock 的高级功能,否则优先使用 synchronized。这是因为 synchronized 是 JVM 实现的一种锁机制,JVM 原生地支持它,而 ReentrantLock 不是所有的 JDK 版本都支持。并且使用 synchronized 不用担心没有释放锁而导致死锁问题,因为 JVM 会确保锁的释放。 +除非需要使用 ReentrantLock 的高级功能,否则优先使用 synchronized。这是因为 synchronized 是 JVM 实现的一种锁机制,JVM 原生地支持它,并且使用 synchronized 不用担心没有释放锁而导致死锁问题,因为 JVM 会确保锁的释放;ReentrantLock 则必须在 finally 中调用 unlock()。 + +### Java 中的锁 + +Java 中的锁可以从几个角度分类,同一把锁会同时属于多类,例如 ReentrantLock 默认是悲观、独占、可重入的非公平锁: + +| 分类 | 区别 | 例子 | +| --- | --- | --- | +| [悲观锁与乐观锁](#4-乐观锁与悲观锁) | 先加锁再访问;或者先访问,提交时再检查有没有冲突 | synchronized、ReentrantLock;AtomicInteger 的 CAS、StampedLock 的乐观读 | +| 独占锁与共享锁 | 同一时刻只能有一个线程持有;或者可以有多个 | ReentrantLock、写锁;读锁、Semaphore | +| [公平锁与非公平锁](#七juc---aqs) | 按申请的顺序获得锁;或者允许新来的线程插队 | new ReentrantLock(true);synchronized、ReentrantLock 默认 | +| 可重入锁 | 持有锁的线程可以再次获得同一把锁,不会被自己阻塞 | synchronized、ReentrantLock、ReentrantReadWriteLock | +| [自旋锁](#自旋锁) | 获取失败时循环重试,而不是挂起线程 | synchronized 的自适应自旋、CAS 循环 | +| [偏向锁、轻量级锁、重量级锁](#十二锁优化) | synchronized 在不同竞争程度下的实现 | synchronized | + +读多写少时,读和读之间不需要互斥,可以使用读写锁 ReentrantReadWriteLock:读锁是共享锁,多个线程可以同时持有;写锁是独占锁,持有写锁时其它线程既不能读也不能写。JDK 8 的 StampedLock 还提供乐观读,读之前不加锁,只记下一个版本号,读完再检查期间有没有写入,有写入才加读锁重读: + +```java +long stamp = lock.tryOptimisticRead(); +long sum = readWork(); +if (!lock.validate(stamp)) { // 读的过程中有写入 + stamp = lock.readLock(); + try { sum = readWork(); } finally { lock.unlockRead(stamp); } +} +``` + +在本机用 8 个线程访问同一个保存了 1000 个商品价格的 HashMap,99% 的操作是遍历求总价,1% 是修改价格,每个线程 2 万次,三种锁的耗时如下(JDK 21,各运行 3 次): + +- ReentrantLock:365~427 ms,读也互斥,与单线程不加锁执行同样多次读的 357 ms 差不多,8 个线程实际上是排队执行的; +- ReentrantReadWriteLock:139~156 ms,读可以并行,但每次加读锁都要用 CAS 修改锁中的读线程计数,多个线程争抢同一个变量,不能做到 8 倍; +- StampedLock 乐观读:61~63 ms,读的时候不修改任何共享变量,只有极少数读取需要重试。 + +需要注意的是: + +- 读锁不能升级为写锁:持有读锁时再获取写锁,要等所有读锁释放,而自己的读锁不会释放,实测 tryLock 等待 1 秒后返回 false,用 lock() 就会永远阻塞; +- 写锁可以降级为读锁:先获取写锁,再获取读锁,然后释放写锁,这样修改之后的数据可以继续读,期间不会被其它线程修改; +- StampedLock 不可重入,也不支持 Condition,乐观读期间读到的数据可能是不一致的,只能在 validate 成功之后使用。 ## 五、线程之间的协作 @@ -844,6 +882,8 @@ for (int i = 0; i < 3; i++) { 阻塞和等待的区别在于,阻塞是被动的,它是在等待获取 monitor lock。而等待是主动的,通过调用 Object.wait() 等方法进入。 +需要注意的是,只有等待 synchronized 的线程才处于 BLOCKED 状态。ReentrantLock 基于 AQS,抢不到锁的线程通过 LockSupport.park() 挂起,状态是 WAITING:让一个线程等待 synchronized、另一个线程等待 ReentrantLock,在 JDK 21 上打印两者的 getState(),分别是 BLOCKED 和 WAITING。 + | 进入方法 | 退出方法 | | --- | --- | | 没有设置 Timeout 参数的 Object.wait() 方法 | Object.notify() / Object.notifyAll() | @@ -874,13 +914,37 @@ for (int i = 0; i < 3; i++) { java.util.concurrent(J.U.C)大大提高了并发性能,AQS 被认为是 J.U.C 的核心。 +AbstractQueuedSynchronizer(AQS)用两样东西实现了各种同步器: + +- 一个 int 类型的 state,含义由具体的同步器决定,修改时使用 CAS; +- 一个等待队列,获取失败的线程包装成节点加入队尾,并通过 LockSupport.park() 挂起,释放时唤醒队头的线程。 + +以 ReentrantLock 为例,state 表示锁被重入的次数:0 表示没有被持有,加锁时用 CAS 把 0 改为 1,同一个线程再次加锁时直接加 1,解锁时减 1,减到 0 才真正释放。下面的代码中,main 线程加锁两次后,t1、t2 都进入了等待队列: + +```java +ReentrantLock lock = new ReentrantLock(); +lock.lock(); +lock.lock(); +System.out.println(lock.getHoldCount()); // 2 +Thread t1 = new Thread(lock::lock), t2 = new Thread(lock::lock); +t1.start(); t2.start(); +Thread.sleep(200); +System.out.println(lock.getQueueLength()); // 2,t1、t2 的状态都是 WAITING +lock.unlock(); +lock.unlock(); // state 减到 0,唤醒队头的 t1 +``` + +公平锁与非公平锁的区别只在加锁的第一步:非公平锁不管队列里有没有线程在等,先尝试 CAS 抢一次;公平锁先检查队列(hasQueuedPredecessors),有线程在等就直接排到队尾。非公平锁的好处是刚释放锁的线程可以立即再次获得锁,省去了唤醒另一个线程的开销。在本机用 8 个线程各加锁、解锁 20 万次,非公平锁约 37 ms,公平锁约 3.3 秒,差距接近 100 倍,所以 ReentrantLock 默认是非公平的,只有严格要求先来先得时才使用公平锁。 + +CountDownLatch、Semaphore 等也基于 AQS,只是对 state 的解释不同:CountDownLatch 的 state 是剩余的计数,Semaphore 的 state 是剩余的许可数。 + ### CountDownLatch 用来控制一个或者多个线程等待多个线程。 维护了一个计数器 cnt,每次调用 countDown() 方法会让计数器的值减 1,减到 0 的时候,那些因为调用 await() 方法而在等待的线程就会被唤醒。 -

+

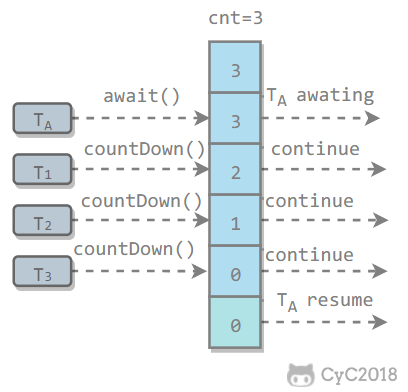
```java public class CountdownLatchExample { @@ -912,7 +976,7 @@ run..run..run..run..run..run..run..run..run..run..end 和 CountDownLatch 相似,都是通过维护计数器来实现的。线程执行 await() 方法之后计数器会减 1,并进行等待,直到计数器为 0,所有调用 await() 方法而在等待的线程才能继续执行。 -CyclicBarrier 和 CountDownLatch 的一个区别是,CyclicBarrier 的计数器通过调用 reset() 方法可以循环使用,所以它才叫做循环屏障。 +CyclicBarrier 和 CountDownLatch 的一个区别是,所有线程到达、屏障打开之后,CyclicBarrier 的计数器会自动恢复为初始值,可以用于下一轮,所以它才叫做循环屏障;CountDownLatch 的计数减到 0 之后不能再重置。reset() 用于强制重置屏障,正在等待的线程会抛出 BrokenBarrierException。 CyclicBarrier 有两个构造函数,其中 parties 指示计数器的初始值,barrierAction 在所有线程都到达屏障的时候会执行一次。 @@ -929,7 +993,7 @@ public CyclicBarrier(int parties) { } ``` -

+

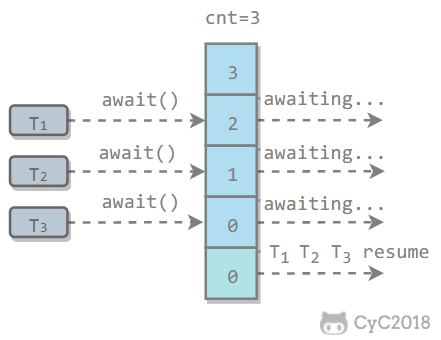
```java public class CyclicBarrierExample { @@ -1047,6 +1111,32 @@ other task is running... 4950 ``` +### CompletableFuture + +Future 只能调用 get() 阻塞等待结果,多个异步任务之间有依赖时(A 完成后做 B,A 和 B 都完成后合并结果),需要自己写等待的逻辑。JDK 8 的 CompletableFuture 可以给任务注册回调,把多个异步任务组合起来。 + +例如订单详情页要依次查询订单和物流(查物流要用到订单中的运单号),同时还要查询优惠券,每次调用约 200 ms。下面的 call() 模拟一次远程调用,其中优惠券服务会抛出异常: + +```java +ExecutorService pool = Executors.newFixedThreadPool(8); +CompletableFuture order = CompletableFuture.supplyAsync(() -> call("订单 1024", 200), pool); +CompletableFuture logistics = order.thenApplyAsync(o -> call("物流 SF1234567", 200), pool); // 依赖订单的结果 +CompletableFuture coupon = CompletableFuture.supplyAsync(() -> call("优惠券 2 张", 200), pool) + .exceptionally(e -> "优惠券暂不可用"); // 失败时降级 +String page = logistics.thenCombine(coupon, (l, c) -> l + "," + c).join(); +``` + +```text +串行:640 ms +物流 SF1234567,优惠券暂不可用,耗时 425 ms +``` + +需要注意的是: + +- 不传入线程池时,任务在 ForkJoinPool.commonPool() 中执行,它的线程数默认为 CPU 核数 − 1(本机 10 核时为 9),并且被并行流等代码共用,阻塞的 I/O 任务应该使用自己的线程池; +- 异常不会自动抛出,要用 exceptionally、handle 处理,否则只有调用 join() 时才会得到包装后的 CompletionException; +- thenApply 的函数返回普通的值,thenCompose 的函数返回另一个 CompletableFuture,用来串联两个异步调用,避免得到 CompletableFuture<CompletableFuture<T>>。 + ### BlockingQueue java.util.concurrent.BlockingQueue 接口有以下阻塞队列的实现: @@ -1164,9 +1254,9 @@ ForkJoin 使用 ForkJoinPool 来启动,它是一个特殊的线程池,线程 public class ForkJoinPool extends AbstractExecutorService ``` -ForkJoinPool 实现了工作窃取算法来提高 CPU 的利用率。每个线程都维护了一个双端队列,用来存储需要执行的任务。工作窃取算法允许空闲的线程从其它线程的双端队列中窃取一个任务来执行。窃取的任务必须是最晚的任务,避免和队列所属线程发生竞争。例如下图中,Thread2 从 Thread1 的队列中拿出最晚的 Task1 任务,Thread1 会拿出 Task2 来执行,这样就避免发生竞争。但是如果队列中只有一个任务时还是会发生竞争。 +ForkJoinPool 实现了工作窃取算法来提高 CPU 的利用率。每个线程都维护了一个双端队列,用来存储需要执行的任务。工作窃取算法允许空闲的线程从其它线程的双端队列中窃取一个任务来执行。线程从自己队列的一端取最新放入的任务,窃取者从另一端取最早放入的任务,两者分别在队列的两端操作,避免发生竞争。例如下图中,Thread2 从 Thread1 的队列中窃取最早的 Task1,Thread1 自己取出 Task3 执行。但是如果队列中只有一个任务时还是会发生竞争。 -

+

## 九、线程不安全示例 @@ -1221,19 +1311,19 @@ Java 内存模型试图屏蔽各种硬件和操作系统的内存访问差异, 加入高速缓存带来了一个新的问题:缓存一致性。如果多个缓存共享同一块主内存区域,那么多个缓存的数据可能会不一致,需要一些协议来解决这个问题。 -

+

所有的变量都存储在主内存中,每个线程还有自己的工作内存,工作内存存储在高速缓存或者寄存器中,保存了该线程使用的变量的主内存副本拷贝。 线程只能直接操作工作内存中的变量,不同线程之间的变量值传递需要通过主内存来完成。 -

+

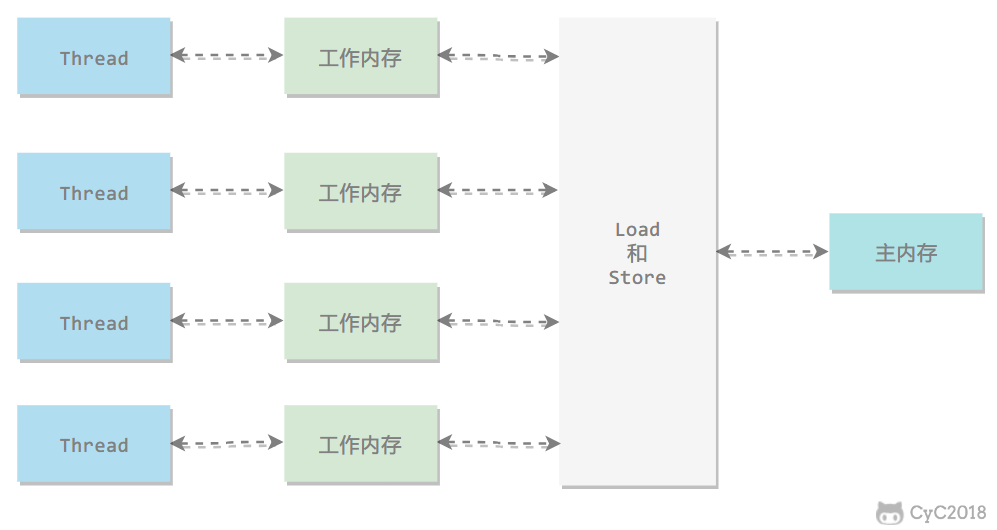
### 内存间交互操作 -Java 内存模型定义了 8 个操作来完成主内存和工作内存的交互操作。 +Java 内存模型定义了 8 个操作来完成主内存和工作内存的交互操作。这种描述来自 JDK 5 之前的规范,现在的规范改用下文的先行发生关系来定义,但它仍然便于理解变量在主内存和工作内存之间的传递。 -

+

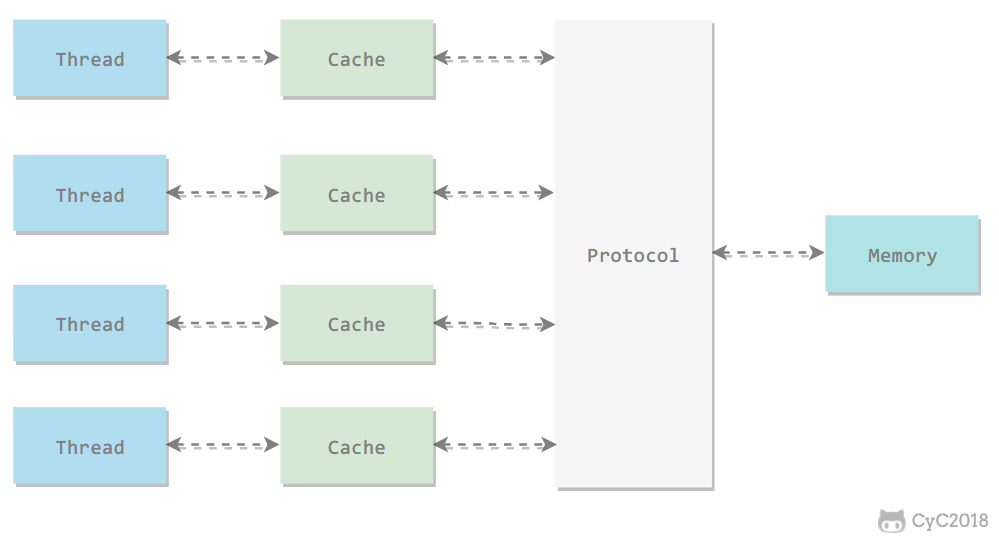
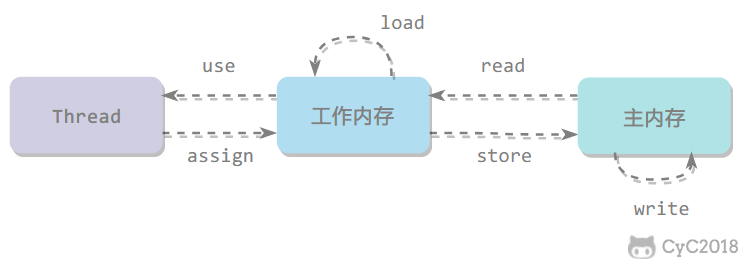
- read:把一个变量的值从主内存传输到工作内存中 - load:在 read 之后执行,把 read 得到的值放入工作内存的变量副本中 @@ -1256,11 +1346,11 @@ Java 内存模型保证了 read、load、use、assign、store、write、lock 和 下图演示了两个线程同时对 cnt 进行操作,load、assign、store 这一系列操作整体上看不具备原子性,那么在 T1 修改 cnt 并且还没有将修改后的值写入主内存,T2 依然可以读入旧值。可以看出,这两个线程虽然执行了两次自增运算,但是主内存中 cnt 的值最后为 1 而不是 2。因此对 int 类型读写操作满足原子性只是说明 load、assign、store 这些单个操作具备原子性。 -

+

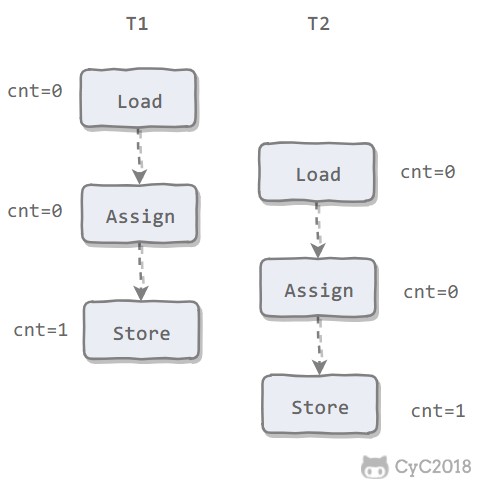
AtomicInteger 能保证多个线程修改的原子性。 -

+

使用 AtomicInteger 重写之前线程不安全的代码之后得到以下线程安全实现: @@ -1360,7 +1450,7 @@ volatile 关键字通过添加内存屏障的方式来禁止指令重排,即 ### 先行发生原则 -上面提到了可以用 volatile 和 synchronized 来保证有序性。除此之外,JVM 还规定了先行发生原则,让一个操作无需控制就能先于另一个操作完成。 +上面提到了可以用 volatile 和 synchronized 来保证有序性。JDK 5(JSR-133)起,Java 内存模型用先行发生(happens-before)关系来定义可见性:如果操作 A 先行发生于操作 B,那么 A 的结果对 B 可见。它说的是可见性和顺序上的保证,并不要求 A 在时间上先执行。以下规则天然成立,不需要额外的同步手段。 #### 1. 单一线程原则 @@ -1368,7 +1458,7 @@ volatile 关键字通过添加内存屏障的方式来禁止指令重排,即 在一个线程内,在程序前面的操作先行发生于后面的操作。 -

+

#### 2. 管程锁定规则 @@ -1376,7 +1466,7 @@ volatile 关键字通过添加内存屏障的方式来禁止指令重排,即 一个 unlock 操作先行发生于后面对同一个锁的 lock 操作。 -

+

#### 3. volatile 变量规则 @@ -1384,7 +1474,7 @@ volatile 关键字通过添加内存屏障的方式来禁止指令重排,即 对一个 volatile 变量的写操作先行发生于后面对这个变量的读操作。 -

+

#### 4. 线程启动规则 @@ -1392,7 +1482,7 @@ volatile 关键字通过添加内存屏障的方式来禁止指令重排,即 Thread 对象的 start() 方法调用先行发生于此线程的每一个动作。 -

+

#### 5. 线程加入规则 @@ -1400,7 +1490,7 @@ Thread 对象的 start() 方法调用先行发生于此线程的每一个动作 Thread 对象的结束先行发生于 join() 方法返回。 -

+

#### 6. 线程中断规则 @@ -1522,6 +1612,24 @@ public final int getAndAddInt(Object var1, long var2, int var4) { J.U.C 包提供了一个带有标记的原子引用类 AtomicStampedReference 来解决这个问题,它可以通过控制变量值的版本来保证 CAS 的正确性。大部分情况下 ABA 问题不会影响程序并发的正确性,如果需要解决 ABA 问题,改用传统的互斥同步可能会比原子类更高效。 +#### 4. 乐观锁与悲观锁 + +悲观锁认为冲突一定会发生,访问共享数据之前先加锁,其它线程只能等待,例如 synchronized、ReentrantLock,以及数据库的 SELECT ... FOR UPDATE。乐观锁认为冲突很少发生,不加锁直接操作,提交时再检查数据是否被别人改过,改过就重试或放弃,例如 CAS 和数据库中的版本号。 + +数据库中常用版本号实现乐观锁。例如两个请求都读到库存 10、版本号 1,然后都执行: + +```sql +UPDATE product SET stock = stock - 1, version = version + 1 WHERE id = 1 AND version = 1; +``` + +先执行的请求影响 1 行,库存变为 9、版本号变为 2;后执行的请求影响 0 行,说明数据已被修改,需要重新读取后再试。 + +两者的选择: + +- 读多写少、冲突少时用乐观锁,没有加锁和阻塞的开销; +- 写多、冲突频繁时用悲观锁,否则乐观锁会不断失败重试,反而浪费 CPU; +- 乐观锁只能保证单个变量或单行数据的原子更新,涉及多个资源时仍然要加锁或使用事务。 + ### 无同步方案 要保证线程安全,并不是一定就要进行同步。如果一个方法本来就不涉及共享数据,那它自然就无须任何同步措施去保证正确性。 @@ -1618,7 +1726,7 @@ public class ThreadLocalExample1 { 它所对应的底层结构图为: -

+

每个 Thread 都有一个 ThreadLocal.ThreadLocalMap 对象。 @@ -1661,7 +1769,18 @@ public T get() { ThreadLocal 从理论上讲并不是用来解决多线程并发问题的,因为根本不存在多线程竞争。 -在一些场景 (尤其是使用线程池) 下,由于 ThreadLocal.ThreadLocalMap 的底层数据结构导致 ThreadLocal 有内存泄漏的情况,应该尽可能在每次使用 ThreadLocal 后手动调用 remove(),以避免出现 ThreadLocal 经典的内存泄漏甚至是造成自身业务混乱的风险。 +ThreadLocalMap 的 Entry 继承自 WeakReference,对 key(ThreadLocal 对象)是弱引用,对 value 是强引用。ThreadLocal 对象没有其它强引用时,key 会在 GC 后变为 null,但 value 仍然被线程的 Map 引用着;线程池中的线程一直存活,这些 value 就一直无法回收,这就是 ThreadLocal 的内存泄漏。 + +更常见的问题是线程池复用线程导致数据串用。在只有一个线程的线程池中,请求 1 设置了用户 alice 但没有 remove(),请求 2 没有登录,调用 get() 却读到了 alice。所以每次使用 ThreadLocal 后都要在 finally 中调用 remove(): + +```java +try { + USER.set(user); + handle(request); +} finally { + USER.remove(); +} +``` #### 3. 可重入代码(Reentrant Code) @@ -1709,6 +1828,8 @@ public static String concatString(String s1, String s2, String s3) { 每个 append() 方法中都有一个同步块。虚拟机观察变量 sb,很快就会发现它的动态作用域被限制在 concatString() 方法内部。也就是说,sb 的所有引用永远不会逃逸到 concatString() 方法之外,其他线程无法访问到它,因此可以进行消除。 +需要注意的是,这是 JDK 1.5 之前的情况。JDK 5 到 8 的 javac 改用不加锁的 StringBuilder,JDK 9 起改为 invokedynamic 调用 makeConcatWithConstants,用 javap 查看 JDK 21 编译出的字节码可以确认,现在的字符串拼接已经没有锁了。但在代码中直接使用 StringBuffer、Vector 这类同步容器的局部对象时,锁消除仍然适用。 + ### 锁粗化 如果一系列的连续操作都对同一个对象反复加锁和解锁,频繁的加锁操作就会导致性能损耗。 @@ -1719,19 +1840,19 @@ public static String concatString(String s1, String s2, String s3) { JDK 1.6 引入了偏向锁和轻量级锁,从而让锁拥有了四个状态:无锁状态(unlocked)、偏向锁状态(biasable)、轻量级锁状态(lightweight locked)和重量级锁状态(inflated)。 -以下是 HotSpot 虚拟机对象头的内存布局,这些数据被称为 Mark Word。其中 tag bits 对应了五个状态,这些状态在右侧的 state 表格中给出。除了 marked for gc 状态,其它四个状态已经在前面介绍过了。 +以下是 64 位 HotSpot 虚拟机对象头的内存布局,这些数据被称为 Mark Word。末尾两位的锁标志和倒数第 3 位的偏向标志区分了五种状态,除了 GC 标记状态,其它四个状态已经在前面介绍过了。 -

+

下图左侧是一个线程的虚拟机栈,其中有一部分称为 Lock Record 的区域,这是在轻量级锁运行过程创建的,用于存放锁对象的 Mark Word。而右侧就是一个锁对象,包含了 Mark Word 和其它信息。 -

+

轻量级锁是相对于传统的重量级锁而言,它使用 CAS 操作来避免重量级锁使用互斥量的开销。对于绝大部分的锁,在整个同步周期内都是不存在竞争的,因此也就不需要都使用互斥量进行同步,可以先采用 CAS 操作进行同步,如果 CAS 失败了再改用互斥量进行同步。 当尝试获取一个锁对象时,如果锁对象标记为 0 01,说明锁对象的锁未锁定(unlocked)状态。此时虚拟机在当前线程的虚拟机栈中创建 Lock Record,然后使用 CAS 操作将对象的 Mark Word 更新为 Lock Record 指针。如果 CAS 操作成功了,那么线程就获取了该对象上的锁,并且对象的 Mark Word 的锁标记变为 00,表示该对象处于轻量级锁状态。 -

+

如果 CAS 操作失败了,虚拟机首先会检查对象的 Mark Word 是否指向当前线程的虚拟机栈,如果是的话说明当前线程已经拥有了这个锁对象,那就可以直接进入同步块继续执行,否则说明这个锁对象已经被其他线程线程抢占了。如果有两条以上的线程争用同一个锁,那轻量级锁就不再有效,要膨胀为重量级锁。 @@ -1743,8 +1864,6 @@ JDK 1.6 引入了偏向锁和轻量级锁,从而让锁拥有了四个状态: 当有另外一个线程去尝试获取这个锁对象时,偏向状态就宣告结束,此时撤销偏向(Revoke Bias)后恢复到未锁定状态或者轻量级锁状态。 -

- 需要注意的是,偏向锁在 JDK 15 中被默认禁用并废弃(JEP 374),JDK 18 起相关参数已不再生效。 ## 十三、多线程开发良好的实践 @@ -1775,7 +1894,7 @@ JDK 1.6 引入了偏向锁和轻量级锁,从而让锁拥有了四个状态: - [Java 线程面试题 Top 50](http://www.importnew.com/12773.html) - [BlockingQueue](http://tutorials.jenkov.com/java-util-concurrent/blockingqueue.html) - [thread state java](https://stackoverflow.com/questions/11265289/thread-state-java) -- [CSC 456 Spring 2012/ch7 MN](http://wiki.expertiza.ncsu.edu/index.php/CSC_456_Spring_2012/ch7_MN) +- [CSC 456 Spring 2012/ch7 MN](https://web.archive.org/web/20250417190245/https://wiki.expertiza.ncsu.edu/index.php/CSC_456_Spring_2012/ch7_MN) - [Java - Understanding Happens-before relationship](https://www.logicbig.com/tutorials/core-java-tutorial/java-multi-threading/happens-before.html) - [6장 Thread Synchronization](https://www.slideshare.net/novathinker/6-thread-synchronization) - [How is Java's ThreadLocal implemented under the hood?](https://stackoverflow.com/questions/1202444/how-is-javas-threadlocal-implemented-under-the-hood/15653015) @@ -1783,3 +1902,5 @@ JDK 1.6 引入了偏向锁和轻量级锁,从而让锁拥有了四个状态: - [JAVA FORK JOIN EXAMPLE](http://www.javacreed.com/java-fork-join-example/ "Java Fork Join Example") - [聊聊并发(八)——Fork/Join 框架介绍](http://ifeve.com/talk-concurrency-forkjoin/) - [Eliminating SynchronizationRelated Atomic Operations with Biased Locking and Bulk Rebiasing](http://www.oracle.com/technetwork/java/javase/tech/biasedlocking-oopsla2006-preso-150106.pdf) +- [JEP 374: Deprecate and Disable Biased Locking](https://openjdk.org/jeps/374) +- [markOop.hpp | OpenJDK jdk8u](https://github.com/openjdk/jdk8u/blob/master/hotspot/src/share/vm/oops/markOop.hpp) diff --git "a/notes/Java \350\231\232\346\213\237\346\234\272.md" "b/notes/Java \350\231\232\346\213\237\346\234\272.md" index e4c912715..b76b26b4e 100644 --- "a/notes/Java \350\231\232\346\213\237\346\234\272.md" +++ "b/notes/Java \350\231\232\346\213\237\346\234\272.md" @@ -9,6 +9,8 @@ * [方法区](#方法区) * [运行时常量池](#运行时常量池) * [直接内存](#直接内存) + * [堆和栈的区别](#堆和栈的区别) + * [对象的创建与内存布局](#对象的创建与内存布局) * [二、垃圾收集](#二垃圾收集) * [判断一个对象是否可被回收](#判断一个对象是否可被回收) * [引用类型](#引用类型) @@ -27,6 +29,7 @@ * [双亲委派模型](#双亲委派模型) * [自定义类加载器实现](#自定义类加载器实现) * [五、线上问题排查](#五线上问题排查) + * [JVM 调优](#jvm-调优) * [内存溢出与内存泄漏](#内存溢出与内存泄漏) * [CPU 占用过高](#cpu-占用过高) * [死锁](#死锁) @@ -50,7 +53,7 @@

-可以通过 -Xss 这个虚拟机参数来指定每个线程的 Java 虚拟机栈内存大小,在 JDK 1.4 中默认为 256K,而在 JDK 1.5+ 默认为 1M: +可以通过 -Xss 这个虚拟机参数来指定每个线程的 Java 虚拟机栈内存大小,默认值与平台有关,64 位 Linux 上为 1 MB,本机 macOS(Apple 芯片)上的 JDK 21 用 -XX:+PrintFlagsFinal 查看 ThreadStackSize 为 2048 KB: ```java java -Xss2M HackTheJava @@ -110,6 +113,62 @@ Class 文件中的常量池(编译器生成的字面量和符号引用)会 在 JDK 1.4 中新引入了 NIO 类,它可以使用 Native 函数库直接分配堆外内存,然后通过 Java 堆里的 DirectByteBuffer 对象作为这块内存的引用进行操作。这样能在一些场景中显著提高性能,因为避免了在堆内存和堆外内存来回拷贝数据。 +### 堆和栈的区别 + +- 存放的内容:虚拟机栈中是方法调用的栈帧,保存局部变量、操作数和返回地址;堆中是对象和数组,JDK 7 起静态变量和字符串常量池也在堆中; +- 共享范围:每个线程有自己的栈,其它线程访问不到;堆被所有线程共享,所以只有堆中的对象才存在线程安全问题; +- 生命周期:栈帧在方法调用时创建、返回时销毁,不需要垃圾回收;堆中的对象由垃圾收集器回收; +- 大小和异常:栈的大小由 -Xss 设置,调用层次太深时抛出 StackOverflowError;堆的大小由 -Xms、-Xmx 设置,放不下时抛出 OutOfMemoryError。 + +```java +void pay(long orderId) { + int amount = 100; // 基本类型的局部变量,值在栈帧中 + Order order = new Order(orderId); // 引用 order 在栈帧中,Order 对象在堆中 +} +``` + +方法返回后,栈帧中的 amount 和 order 立即消失;Order 对象如果没有被其它地方引用,会在之后的 GC 中被回收。操作系统中进程地址空间的栈和堆也是类似的划分:栈由编译器生成的代码自动分配和释放,堆由程序调用 malloc、free 管理。 + +需要注意的是,对象不一定都在堆中创建。JIT 编译时会做逃逸分析,如果一个对象不会离开创建它的方法(没有被返回、没有赋给字段、没有传给其它线程),HotSpot 会把它拆成几个局部变量,这称为标量替换,堆中不再创建这个对象。例如在循环中创建 2 亿个只在方法内部使用的 Point 对象,在 JDK 21 上默认没有发生 GC,耗时约 134 ms;加上 -XX:-DoEscapeAnalysis 关闭逃逸分析后,发生了 31 次 GC,耗时约 305 ms。 + +### 对象的创建与内存布局 + +执行 new Order() 时,虚拟机依次完成以下步骤: + +1. 类加载检查:如果 Order 类还没有加载,先执行 [类加载过程](#类加载过程); +2. 分配内存:对象的大小在类加载完成后就确定了。堆中的内存规整时,只需把空闲位置的指针向后移动对象大小的距离(指针碰撞),有碎片时从空闲列表中找一块;为了避免多个线程同时分配时加锁,每个线程先在 Eden 中领取一小块私有的缓冲区(Thread Local Allocation Buffer, TLAB),在其中分配; +3. 初始化零值:把实例字段都设为 0、false 或 null,所以字段不赋值也有默认值; +4. 设置对象头:写入 Mark Word 和指向类元数据的类型指针; +5. 执行构造方法:按照代码给字段赋值。 + +对象在堆中由对象头、实例数据和对齐填充三部分组成。用 JOL 在 JDK 21 上查看(64 位,默认开启压缩指针),其中 Order 依次声明了 boolean paid、int userId、long id 和 String note 四个字段: + +```text +java.lang.Object +OFF SZ DESCRIPTION + 0 8 (object header: mark) + 8 4 (object header: class) + 12 4 (object alignment gap) +Instance size: 16 bytes + +Order +OFF SZ DESCRIPTION + 0 8 (object header: mark) + 8 4 (object header: class) + 12 4 int Order.userId + 16 8 long Order.id + 24 1 boolean Order.paid + 25 3 (alignment/padding gap) + 28 4 java.lang.String Order.note +Instance size: 32 bytes +``` + +- 对象头:Mark Word 占 8 字节,存放哈希码、GC 年龄和锁状态,见 [锁优化](Java%20并发.md#十二锁优化);类型指针占 4 字节,指向对象所属的类;数组还要多 4 字节记录长度; +- 实例数据:字段不按声明的顺序排列,虚拟机会重排以减少空隙,例如 userId 被放进了对象头后面 4 字节的空位; +- 对齐填充:对象的大小必须是 8 字节的整数倍,new Object() 只有 12 字节的对象头,要补齐到 16 字节。 + +关闭压缩指针(-XX:-UseCompressedOops -XX:-UseCompressedClassPointers)后,类型指针和 note 引用都变成 8 字节,Order 从 32 字节变成 40 字节。压缩指针用 32 位存放对象地址,因为对象按 8 字节对齐,地址的低 3 位总是 0,可以省略,所以最多能表示 232 × 8 = 32 GB 的堆。堆超过 32 GB 时压缩指针自动关闭,所有引用都变大,这是堆的大小通常不超过 32 GB 的原因。 + ## 二、垃圾收集 垃圾收集主要是针对堆和方法区进行。程序计数器、虚拟机栈和本地方法栈这三个区域属于线程私有的,只存在于线程的生命周期内,线程结束之后就会消失,因此不需要对这三个区域进行垃圾回收。 @@ -284,7 +343,7 @@ HotSpot 虚拟机的 Eden 和 Survivor 大小比例默认为 8:1,保证了内 ### 垃圾收集器 -

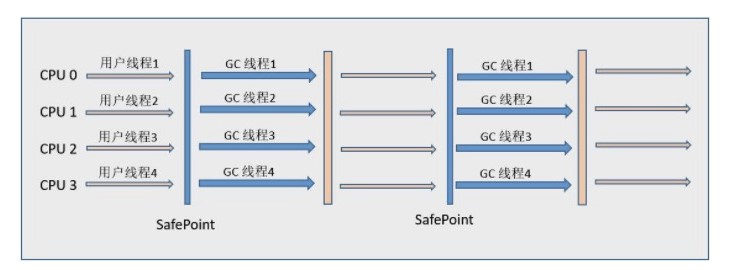
+

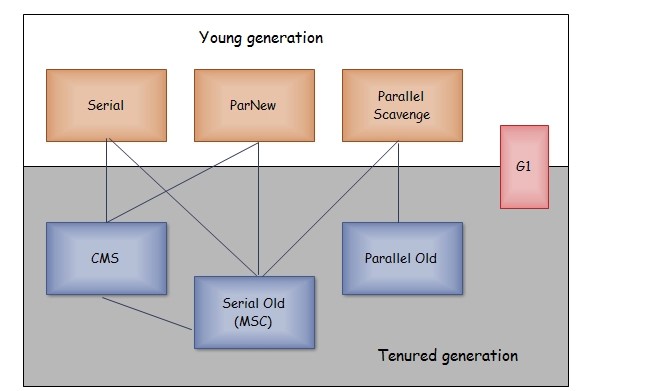
以上是 HotSpot 虚拟机中的 7 个垃圾收集器,连线表示垃圾收集器可以配合使用。 @@ -293,7 +352,7 @@ HotSpot 虚拟机的 Eden 和 Survivor 大小比例默认为 8:1,保证了内 #### 1. Serial 收集器 -

+

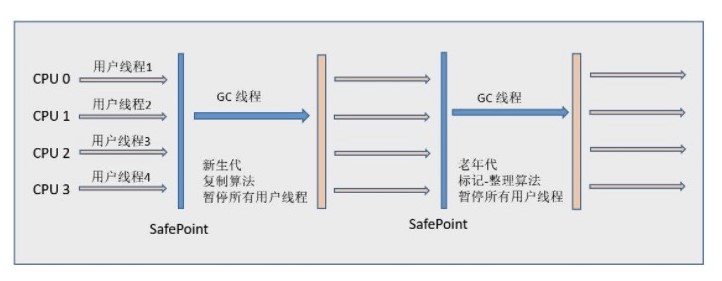
Serial 翻译为串行,也就是说它以串行的方式执行。 @@ -305,7 +364,7 @@ Serial 翻译为串行,也就是说它以串行的方式执行。 #### 2. ParNew 收集器 -

+

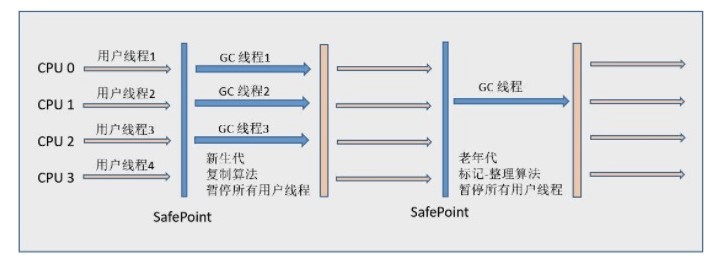
它是 Serial 收集器的多线程版本。 @@ -325,7 +384,7 @@ Serial 翻译为串行,也就是说它以串行的方式执行。 #### 4. Serial Old 收集器 -

+

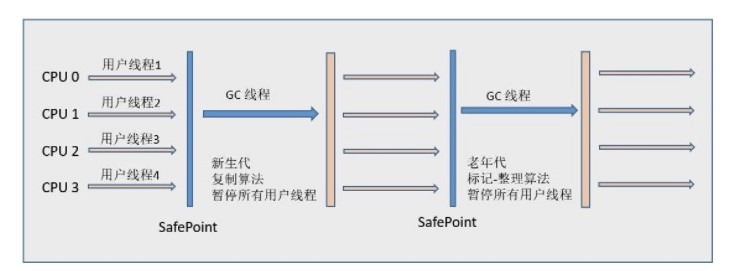
是 Serial 收集器的老年代版本,也是给 Client 场景下的虚拟机使用。如果用在 Server 场景下,它有两大用途: @@ -334,7 +393,7 @@ Serial 翻译为串行,也就是说它以串行的方式执行。 #### 5. Parallel Old 收集器 -

+

是 Parallel Scavenge 收集器的老年代版本。 @@ -342,7 +401,7 @@ Serial 翻译为串行,也就是说它以串行的方式执行。 #### 6. CMS 收集器 -

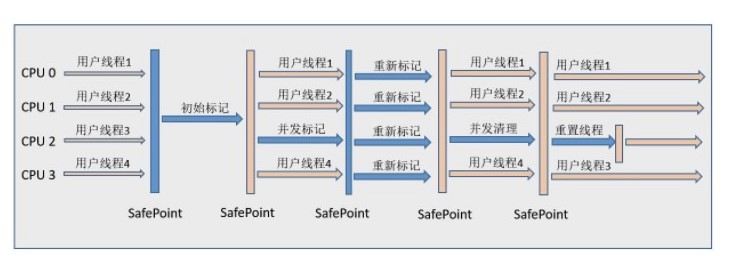
+

CMS(Concurrent Mark Sweep),Mark Sweep 指的是标记 - 清除算法。 @@ -367,30 +426,60 @@ G1(Garbage-First),它是一款面向服务端应用的垃圾收集器, 堆被分为新生代和老年代,其它收集器进行收集的范围都是整个新生代或者老年代,而 G1 可以直接对新生代和老年代一起回收。 -

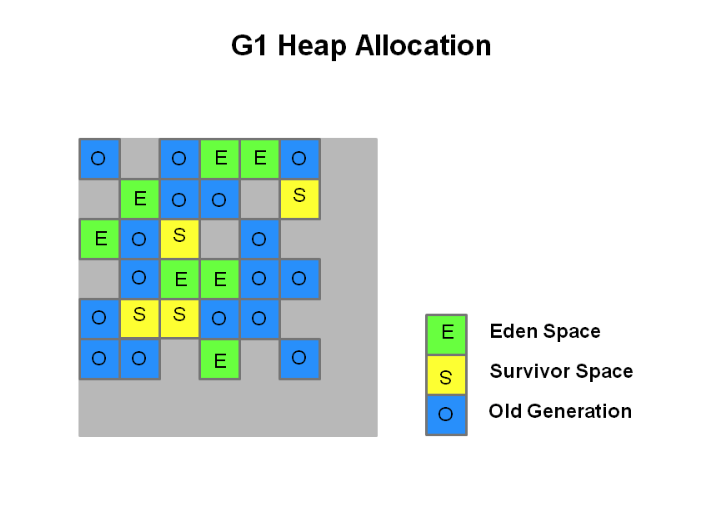
+

G1 把堆划分成多个大小相等的独立区域(Region),新生代和老年代不再物理隔离。 -

+

通过引入 Region 的概念,从而将原来的一整块内存空间划分成多个的小空间,使得每个小空间可以单独进行垃圾回收。这种划分方法带来了很大的灵活性,使得可预测的停顿时间模型成为可能。通过记录每个 Region 垃圾回收时间以及回收所获得的空间(这两个值是通过过去回收的经验获得),并维护一个优先列表,每次根据允许的收集时间,优先回收价值最大的 Region。 每个 Region 都有一个 Remembered Set,用来记录该 Region 对象的引用对象所在的 Region。通过使用 Remembered Set,在做可达性分析的时候就可以避免全堆扫描。 -

+

如果不计算维护 Remembered Set 的操作,G1 收集器的运作大致可划分为以下几个步骤: -- 初始标记 -- 并发标记 -- 最终标记:为了修正在并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,虚拟机将这段时间对象变化记录在线程的 Remembered Set Logs 里面,最终标记阶段需要把 Remembered Set Logs 的数据合并到 Remembered Set 中。这阶段需要停顿线程,但是可并行执行。 -- 筛选回收:首先对各个 Region 中的回收价值和成本进行排序,根据用户所期望的 GC 停顿时间来制定回收计划。此阶段其实也可以做到与用户程序一起并发执行,但是因为只回收一部分 Region,时间是用户可控制的,而且停顿用户线程将大幅度提高收集效率。 +- 初始标记:在一次年轻代回收中顺带完成(Concurrent Start),标记 GC Roots 直接关联的对象,需要停顿; +- 并发标记:与用户线程同时运行,找出老年代中所有存活的对象,期间年轻代回收照常进行; +- 最终标记(Remark):短暂停顿,处理并发标记期间用户线程修改引用留下的记录,完成标记,并直接回收完全空的 Region; +- 清理与混合回收:清理(Cleanup)停顿根据各 Region 的回收价值决定是否进入回收阶段;之后的多次混合回收(Mixed)除了年轻代,再挑选一部分垃圾最多的老年代 Region,把其中存活的对象复制出去,每次回收的数量受停顿时间目标(MaxGCPauseMillis,默认 200 ms)限制。 具备如下特点: - 空间整合:整体来看是基于“标记 - 整理”算法实现的收集器,从局部(两个 Region 之间)上来看是基于“复制”算法实现的,这意味着运行期间不会产生内存空间碎片。 - 可预测的停顿:能让使用者明确指定在一个长度为 M 毫秒的时间片段内,消耗在 GC 上的时间不得超过 N 毫秒。 +同一个程序(不断分配 1~5 KB 的数组,其中四分之一存活较久)在本机用 JDK 21、128 MB 的堆分别运行,停顿情况如下: + +| 收集器 | 停顿次数 | 停顿总时长 | 最长停顿 | +| --- | --- | --- | --- | +| Serial | 39 | 121.6 ms | 12.13 ms | +| Parallel | 75 | 117.7 ms | 6.18 ms | +| G1 | 88 | 49.1 ms | 2.38 ms | + +G1 停顿的次数更多,但每次都很短,适合对响应时间敏感的服务。 + +#### 8. ZGC 收集器 + +ZGC 的目标是让停顿时间不随堆的大小增长,JDK 15 起可以用于生产(JEP 377),JDK 21 加入了分代模式(JEP 439),JDK 23 起分代成为默认模式(JEP 474),JDK 24 移除了不分代的模式(JEP 490)。 + +G1 的年轻代回收和混合回收都要在停顿中把存活对象复制到新的 Region,存活对象越多,停顿越长。ZGC 把标记和复制都放到与用户线程并发执行的阶段,停顿中只做扫描 GC Roots 这类少量工作,所以停顿很短,而且与堆的大小无关。 + +并发复制的难点在于,对象被移走时,用户线程手里可能还拿着指向旧地址的引用。ZGC 用着色指针和读屏障解决这个问题: + +- 着色指针:ZGC 的对象引用固定为 64 位,除了对象的地址,还用其中几位元数据记录状态,例如对象是否已被标记、引用中的地址是否已经更新,看一眼引用就知道它是否可能指向旧地址; +- 读屏障:JIT 在每次从堆中读取引用的地方插入一小段检查,发现引用还指向旧地址,就查转发表换成新地址,并把字段中的引用一起改掉,下次再读就不需要修正了。分代 ZGC 还在写入引用的地方加了写屏障,用来记录老年代对象指向年轻代对象的引用。 + +同一个程序在本机用 JDK 21 的分代 ZGC 运行: + +| 堆大小 | 停顿次数 | 停顿总时长 | 最长停顿 | 分配停顿(Allocation Stall) | +| --- | --- | --- | --- | --- | +| 128 MB | 125 | 0.60 ms | 0.016 ms | 46 次,共 108.6 ms,最长 16.5 ms | +| 512 MB | 43 | 0.27 ms | 0.012 ms | 0 次 | + +ZGC 的停顿都在 0.03 ms 以内,比 G1 短两个数量级。但堆只有 128 MB 时,程序分配内存的速度超过了并发回收的速度,没有空闲的内存可用,分配内存的线程只能等待回收完成,日志中记为 Allocation Stall,对用户来说与停顿无异。所以使用 ZGC 要给堆留出足够的余量,代价是占用更多的内存,读屏障也会让吞吐量略有下降。 + ## 三、内存分配与回收策略 ### Minor GC 和 Full GC @@ -505,7 +594,7 @@ G1 把堆划分成多个大小相等的独立区域(Region),新生代和 #### 3. 准备 -类变量是被 static 修饰的变量,准备阶段为类变量分配内存并设置初始值,使用的是方法区的内存。 +类变量是被 static 修饰的变量,准备阶段为类变量分配内存并设置初始值。在 JDK 7 之前类变量放在方法区(永久代)中,JDK 7 起随 Class 对象一起放在堆中。 实例变量不会在这阶段分配内存,它会在对象实例化时随着对象一起被分配在堆中。应该注意到,实例化不是类加载的一个过程,类加载发生在所有实例化操作之前,并且类加载只进行一次,实例化可以进行多次。 @@ -563,7 +652,7 @@ public static void main(String[] args) { } ``` -接口中不可以使用静态语句块,但仍然有类变量初始化的赋值操作,因此接口与类一样都会生成 <clinit\>() 方法。但接口与类不同的是,执行接口的 <clinit\>() 方法不需要先执行父接口的 <clinit\>() 方法。只有当父接口中定义的变量使用时,父接口才会初始化。另外,接口的实现类在初始化时也一样不会执行接口的 <clinit\>() 方法。 +接口中不可以使用静态语句块,但仍然有类变量初始化的赋值操作,因此接口与类一样都会生成 <clinit\>() 方法。但接口与类不同的是,执行接口的 <clinit\>() 方法不需要先执行父接口的 <clinit\>() 方法。只有当父接口中定义的变量使用时,父接口才会初始化。另外,接口的实现类在初始化时一般也不会执行接口的 <clinit\>() 方法,例外是接口中定义了 default 方法时,实现类初始化之前要先初始化这个接口。 虚拟机会保证一个类的 <clinit\>() 方法在多线程环境下被正确的加锁和同步,如果多个线程同时初始化一个类,只会有一个线程执行这个类的 <clinit\>() 方法,其它线程都会阻塞等待,直到活动线程执行 <clinit\>() 方法完毕。如果在一个类的 <clinit\>() 方法中有耗时的操作,就可能造成多个线程阻塞,在实际过程中此种阻塞很隐蔽。 @@ -571,7 +660,7 @@ public static void main(String[] args) { #### 1. 主动引用 -虚拟机规范中并没有强制约束何时进行加载,但是规范严格规定了有且只有下列五种情况必须对类进行初始化(加载、验证、准备都会随之发生): +虚拟机规范中并没有强制约束何时进行加载,但是规范严格规定了有且只有下列六种情况必须对类进行初始化(加载、验证、准备都会随之发生): - 遇到 new、getstatic、putstatic、invokestatic 这四条字节码指令时,如果类没有进行过初始化,则必须先触发其初始化。最常见的生成这 4 条指令的场景是:使用 new 关键字实例化对象的时候;读取或设置一个类的静态字段(被 final 修饰、已在编译期把结果放入常量池的静态字段除外)的时候;以及调用一个类的静态方法的时候。 @@ -583,9 +672,11 @@ public static void main(String[] args) { - 当使用 JDK 1.7 的动态语言支持时,如果一个 java.lang.invoke.MethodHandle 实例最后的解析结果为 REF_getStatic, REF_putStatic, REF_invokeStatic 的方法句柄,并且这个方法句柄所对应的类没有进行过初始化,则需要先触发其初始化; +- 当一个接口定义了 default 方法时,如果它的实现类发生了初始化,要先初始化这个接口。例如 Impl 同时实现了带 default 方法的 WithDefault 和不带 default 方法的 NoDefault,new Impl() 时在 JDK 21 上依次输出“WithDefault 初始化”“Impl 初始化”,NoDefault 没有被初始化。 + #### 2. 被动引用 -以上 5 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。被动引用的常见例子包括: +以上 6 种场景中的行为称为对一个类进行主动引用。除此之外,所有引用类的方式都不会触发初始化,称为被动引用。被动引用的常见例子包括: - 通过子类引用父类的静态字段,不会导致子类初始化。 @@ -627,6 +718,16 @@ System.out.println(ConstClass.HELLOWORLD); - 应用程序类加载器(Application ClassLoader)这个类加载器是由 AppClassLoader(sun.misc.Launcher$AppClassLoader)实现的。由于这个类加载器是 ClassLoader 中的 getSystemClassLoader() 方法的返回值,因此一般称为系统类加载器。它负责加载用户类路径(ClassPath)上所指定的类库,开发者可以直接使用这个类加载器,如果应用程序中没有自定义过自己的类加载器,一般情况下这个就是程序中默认的类加载器。 +以上是 JDK 8 的情况。JDK 9 引入模块系统后,rt.jar 和 lib/ext 目录都被移除,扩展类加载器被平台类加载器(Platform ClassLoader)取代,负责加载 java.sql 等部分平台模块。三层加载器的父子关系不变,只是加载命名模块中的类时,会直接交给定义该模块的加载器。在 JDK 21 上打印: + +```text +Loaders 的类加载器: jdk.internal.loader.ClassLoaders$AppClassLoader +它的父加载器: jdk.internal.loader.ClassLoaders$PlatformClassLoader +再上一层: null(启动类加载器,在 Java 中用 null 表示) +java.sql.Driver: jdk.internal.loader.ClassLoaders$PlatformClassLoader +String: null +``` + ### 双亲委派模型 应用程序是由三种类加载器互相配合从而实现类加载,除此之外还可以加入自己定义的类加载器。 @@ -744,6 +845,39 @@ public class FileSystemClassLoader extends ClassLoader { ## 五、线上问题排查 +### JVM 调优 + +调优之前先明确目标:在线服务关心最长停顿时间,批处理任务关心吞吐量。大多数情况下先使用默认的 G1,开启 GC 日志观察,确实有问题再调整参数;线上的 GC 问题大多是代码造成的,例如内存泄漏、一次查询加载了太多数据,只调参数解决不了。 + +常用的参数: + +| 参数 | 作用 | +| --- | --- | +| -Xms、-Xmx | 堆的初始大小和最大值,线上通常设为相同,避免运行中扩容和收缩 | +| -XX:MaxRAMPercentage | 不指定 -Xmx 时,最大堆占物理内存(容器中为容器的内存限制)的比例,默认 25% | +| -Xss | 每个线程的栈大小 | +| -XX:MaxMetaspaceSize | 元空间的上限,默认不限制 | +| -XX:+UseG1GC、-XX:+UseZGC | 选择垃圾收集器,JDK 9 起默认 G1 | +| -XX:MaxGCPauseMillis | G1 的停顿时间目标,默认 200 ms | +| -Xlog:gc*:file=gc.log | 输出 GC 日志(JDK 9 起;JDK 8 使用 -XX:+PrintGCDetails -Xloggc:gc.log) | +| -XX:+HeapDumpOnOutOfMemoryError | 内存溢出时保存堆转储 | + +例如一个程序长期持有约 60 MB 的对象,同时不断创建短命的对象。在本机用 JDK 21 和 G1 分别以 72 MB 和 256 MB 的堆运行: + +| 堆大小 | 年轻代回收 | Full GC | 停顿总时长 | 最长停顿 | 运行时间 | +| --- | --- | --- | --- | --- | --- | +| 72 MB | 449 次 | 6 次 | 195.4 ms | 7.34 ms | 460 ms | +| 256 MB | 43 次 | 0 次 | 48.1 ms | 1.34 ms | 318 ms | + +堆太小时,存活的对象几乎占满了老年代,日志中反复出现 Pause Full (G1 Compaction Pause) 70M->28M(72M):每次 Full GC 后仍有一半以上的空间被占用,很快又满了。 + +线上频繁 Full GC 的排查思路: + +1. 用 jstat -gcutil 观察老年代使用率(O 列)和 Full GC 次数(FGC 列); +2. Full GC 之后老年代使用率仍然很高,并且越来越高,说明对象一直无法回收,导出堆转储查找内存泄漏; +3. Full GC 之后老年代能降下来,说明堆对于正常的负载偏小,或者有大对象、大量对象过早进入老年代,可以增大堆、调整新生代大小,或者从代码上减少一次创建的数据量; +4. 元空间不足也会触发 Full GC,日志中的原因为 Metadata GC Threshold,检查是否在动态生成大量的类。 + ### 内存溢出与内存泄漏 OutOfMemoryError 的详细信息指明了是哪一块内存不足,常见的有: @@ -831,10 +965,14 @@ Found one Java-level deadlock: - [JNI Part1: Java Native Interface Introduction and “Hello World” application](http://electrofriends.com/articles/jni/jni-part1-java-native-interface/) - [Memory Architecture Of JVM(Runtime Data Areas)](https://hackthejava.wordpress.com/2015/01/09/memory-architecture-by-jvmruntime-data-areas/) - [JVM Run-Time Data Areas](https://www.programcreek.com/2013/04/jvm-run-time-data-areas/) -- [Android on x86: Java Native Interface and the Android Native Development Kit](http://www.drdobbs.com/architecture-and-design/android-on-x86-java-native-interface-and/240166271) -- [深入理解 JVM(2)——GC 算法与内存分配策略](https://crowhawk.github.io/2017/08/10/jvm_2/) -- [深入理解 JVM(3)——7 种垃圾收集器](https://crowhawk.github.io/2017/08/15/jvm_3/) +- [Android on x86: Java Native Interface and the Android Native Development Kit](https://web.archive.org/web/20240706002000/https://www.drdobbs.com/architecture-and-design/android-on-x86-java-native-interface-and/240166271) +- [深入理解 JVM(2)——GC 算法与内存分配策略](https://web.archive.org/web/20201120232823/https://crowhawk.github.io/2017/08/10/jvm_2/) +- [深入理解 JVM(3)——7 种垃圾收集器](https://web.archive.org/web/20201120232823/https://crowhawk.github.io/2017/08/15/jvm_3/) - [JVM Internals](http://blog.jamesdbloom.com/JVMInternals.html) - [深入探讨 Java 类加载器](https://www.ibm.com/developerworks/cn/java/j-lo-classloader/index.html#code6) - [Guide to WeakHashMap in Java](http://www.baeldung.com/java-weakhashmap) - [Tomcat example source code file (ConcurrentCache.java)](https://alvinalexander.com/java/jwarehouse/apache-tomcat-6.0.16/java/org/apache/el/util/ConcurrentCache.java.shtml) +- [Garbage-First (G1) Garbage Collector | Java SE 17 GC Tuning Guide](https://docs.oracle.com/en/java/javase/17/gctuning/garbage-first-g1-garbage-collector1.html) +- [The Z Garbage Collector | Java SE 21 GC Tuning Guide](https://docs.oracle.com/en/java/javase/21/gctuning/z-garbage-collector.html) +- [JEP 439: Generational ZGC](https://openjdk.org/jeps/439) +- [JEP 490: ZGC: Remove the Non-Generational Mode](https://openjdk.org/jeps/490) diff --git a/notes/Linux.md b/notes/Linux.md index 63e9835c3..2ed8dcd77 100644 --- a/notes/Linux.md +++ b/notes/Linux.md @@ -66,6 +66,11 @@ * [waitpid()](#waitpid) * [孤儿进程](#孤儿进程) * [僵尸进程](#僵尸进程) + * [十一、线上问题排查](#十一线上问题排查) + * [CPU 占用高](#cpu-占用高) + * [内存占用高](#内存占用高) + * [端口与磁盘](#端口与磁盘) + * [日志分析](#日志分析) * [参考资料](#参考资料) @@ -203,25 +208,21 @@ GNU 计划,译为革奴计划,它的目标是创建一套完全自由的操 IDE(Integrated Drive Electronics)通常也称为 ATA(Advanced Technology Attachment),接口速度最大为 133MB/s,因为并口线的抗干扰性太差,且排线占用空间较大,不利电脑内部散热,已逐渐被 SATA 所取代。 -

- #### 2. SATA SATA 全称 Serial ATA,也就是使用串口的 ATA 接口,抗干扰性强,且对数据线的长度要求比 ATA 低很多,支持热插拔等功能。SATA-II 的接口速度为 300MB/s,而 SATA-III 标准可达到 600MB/s 的传输速度。SATA 的数据线也比 ATA 的细得多,有利于机箱内的空气流通,整理线材也比较方便。 -

- #### 3. SCSI SCSI 全称是 Small Computer System Interface(小型机系统接口),SCSI 硬盘广为工作站以及个人电脑以及服务器所使用,因此会使用较为先进的技术,如碟片转速 15000rpm 的高转速,且传输时 CPU 占用率较低,但是单价也比相同容量的 ATA 及 SATA 硬盘更加昂贵。 -

- #### 4. SAS -SAS(Serial Attached SCSI)是新一代的 SCSI 技术,和 SATA 硬盘相同,都是采取序列式技术以获得更高的传输速度,可达到 6Gb/s。此外也通过缩小连接线改善系统内部空间等。 +SAS(Serial Attached SCSI)是新一代的 SCSI 技术,和 SATA 硬盘相同,都是采取序列式技术以获得更高的传输速度,SAS-3 为 12Gb/s。此外也通过缩小连接线改善系统内部空间等。 -

+#### 5. NVMe + +固态硬盘的速度已经超过了 SATA 接口的上限,NVMe(Non-Volatile Memory Express)让固态硬盘直接通过 PCIe 总线与 CPU 通信,PCIe 4.0 x4 的带宽约为 8 GB/s,远高于 SATA III 的 600 MB/s,并且支持大量并行的队列。Linux 中 NVMe 磁盘的文件名为 /dev/nvme0n1,分区为 /dev/nvme0n1p1。 ### 磁盘的文件名 @@ -229,6 +230,7 @@ Linux 中每个硬件都被当做一个文件,包括磁盘。磁盘以磁盘 - IDE 磁盘:/dev/hd[a-d] - SATA/SCSI/SAS 磁盘:/dev/sd[a-p] +- NVMe 磁盘:/dev/nvme0n1、/dev/nvme1n1 其中文件名后面的序号的确定与系统检测到磁盘的顺序有关,而与磁盘所插入的插槽位置无关。 @@ -256,7 +258,7 @@ GPT 没有扩展分区概念,都是主分区,每个 LBA 可以分 4 个分 MBR 不支持 2.2 TB 以上的硬盘,GPT 则最多支持到 233 TB = 8 ZB。 -

+

### 开机检测程序 @@ -264,15 +266,13 @@ MBR 不支持 2.2 TB 以上的硬盘,GPT 则最多支持到 233 TB BIOS(Basic Input/Output System,基本输入输出系统),它是一个固件(嵌入在硬件中的软件),BIOS 程序存放在断电后内容不会丢失的只读内存中。 -

- BIOS 是开机的时候计算机执行的第一个程序,这个程序知道可以开机的磁盘,并读取磁盘第一个扇区的主要开机记录(MBR),由主要开机记录(MBR)执行其中的开机管理程序,这个开机管理程序会加载操作系统的核心文件。 主要开机记录(MBR)中的开机管理程序提供以下功能:选单、载入核心文件以及转交其它开机管理程序。转交这个功能可以用来实现多重引导,只需要将另一个操作系统的开机管理程序安装在其它分区的启动扇区上,在启动开机管理程序时,就可以通过选单选择启动当前的操作系统或者转交给其它开机管理程序从而启动另一个操作系统。 下图中,第一扇区的主要开机记录(MBR)中的开机管理程序提供了两个选单:M1、M2,M1 指向了 Windows 操作系统,而 M2 指向其它分区的启动扇区,里面包含了另外一个开机管理程序,提供了一个指向 Linux 的选单。 -

+

安装多重引导,最好先安装 Windows 再安装 Linux。因为安装 Windows 时会覆盖掉主要开机记录(MBR),而 Linux 可以选择将开机管理程序安装在主要开机记录(MBR)或者其它分区的启动扇区,并且可以设置开机管理程序的选单。 @@ -298,7 +298,7 @@ BIOS 不可以读取 GPT 分区表,而 UEFI 可以。 - superblock:记录文件系统的整体信息,包括 inode 和 block 的总量、使用量、剩余量,以及文件系统的格式与相关信息等; - block bitmap:记录 block 是否被使用的位图。 -

+

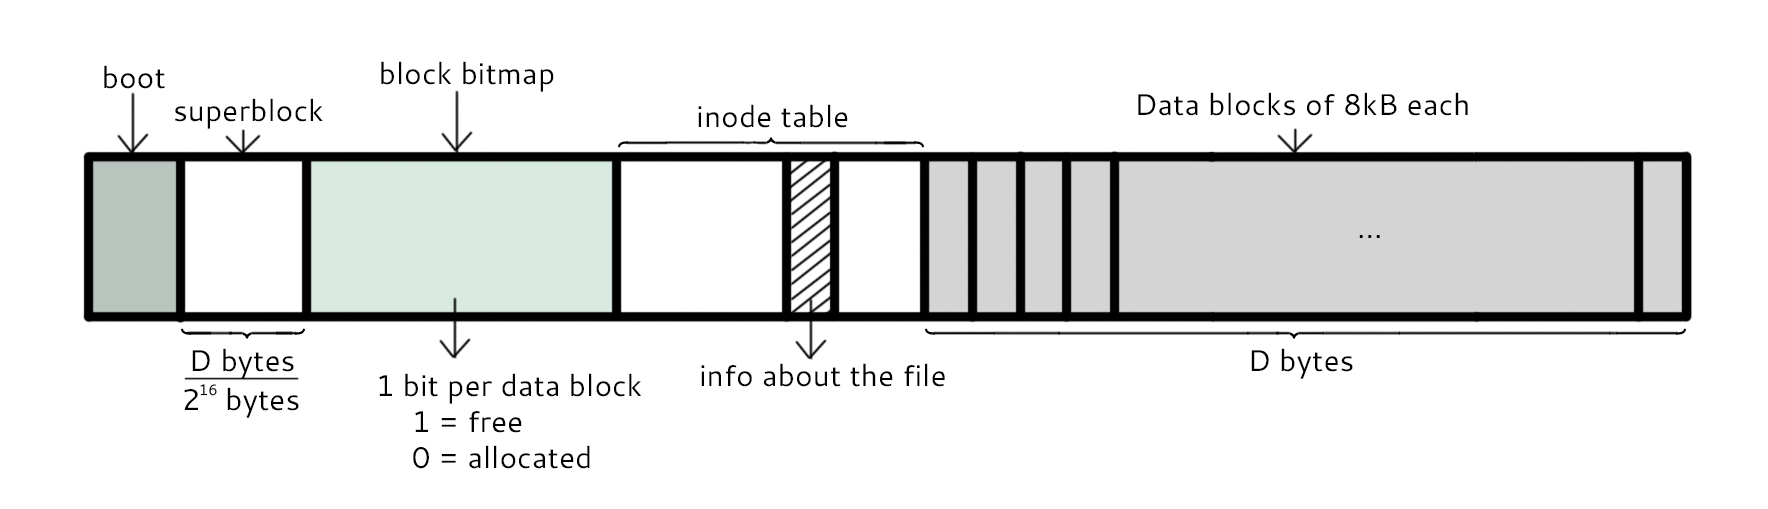
### 文件读取 @@ -340,12 +340,12 @@ inode 具体包含以下信息: inode 具有以下特点: -- 每个 inode 大小均固定为 128 bytes (新的 ext4 与 xfs 可设定到 256 bytes); +- 每个 inode 的大小在格式化时确定,早期的 ext2/ext3 为 128 bytes,现在 mke2fs 默认为 256 bytes; - 每个文件都仅会占用一个 inode。 inode 中记录了文件内容所在的 block 编号,但是每个 block 非常小,一个大文件随便都需要几十万的 block。而一个 inode 大小有限,无法直接引用这么多 block 编号。因此引入了间接、双间接、三间接引用。间接引用让 inode 记录的引用 block 块记录引用信息。 -

+

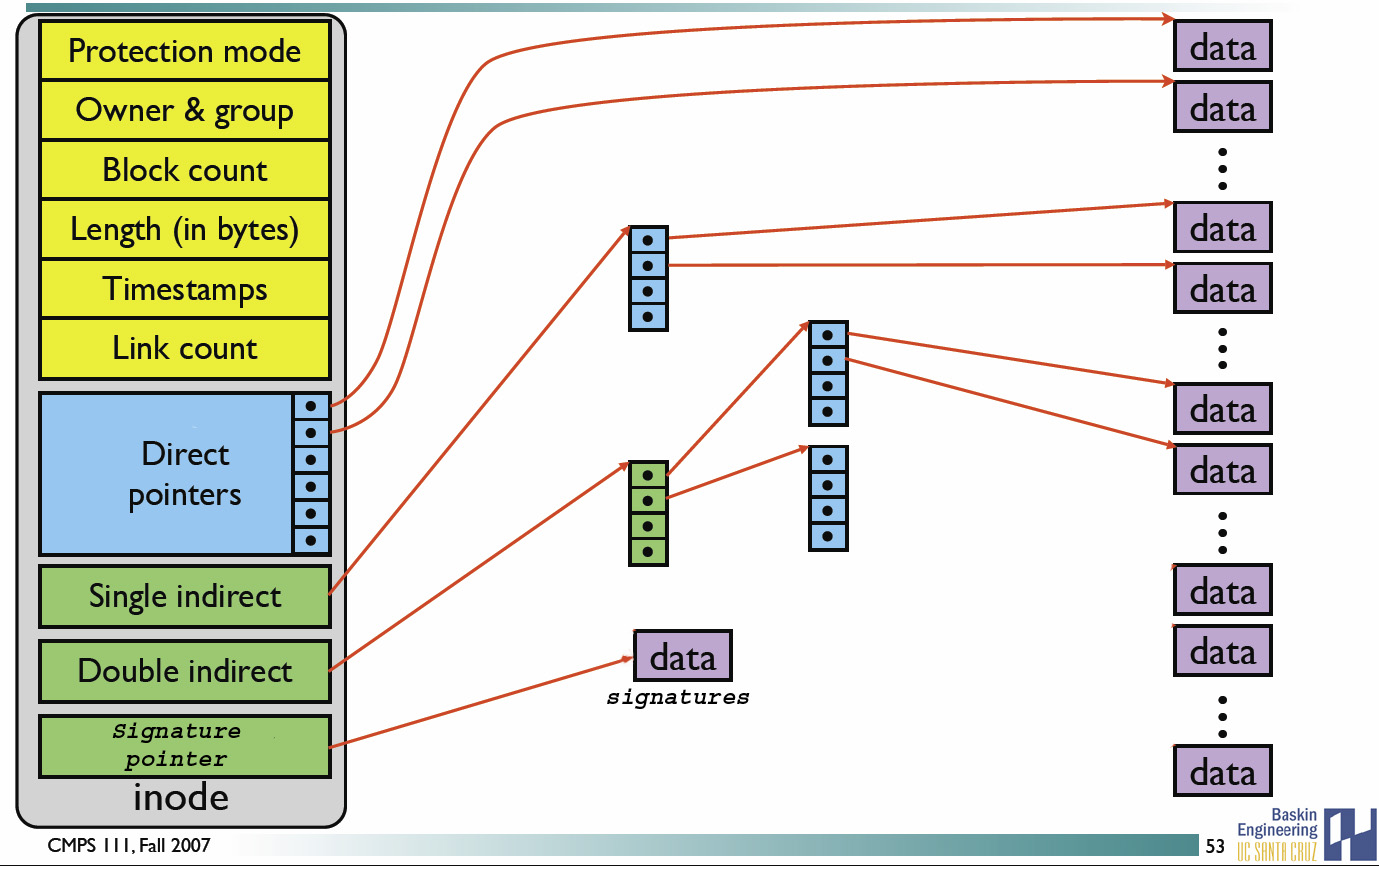
### 目录 @@ -1242,6 +1242,97 @@ options 参数主要有 WNOHANG 和 WUNTRACED 两个选项,WNOHANG 可以使 w 要消灭系统中大量的僵尸进程,只需要将其父进程杀死,此时僵尸进程就会变成孤儿进程,从而被 init 进程所收养,这样 init 进程就会释放所有的僵尸进程所占有的资源,从而结束僵尸进程。 +## 十一、线上问题排查 + +以下输出来自一个 Debian 12 容器,其中运行着一个故意写了死循环、并占用了 200 MB 堆内存的 Java 程序(OpenJDK 17),省略了部分内容。 + +### CPU 占用高 + +先用 top 找到占用 CPU 最多的进程,再用 top -H 查看这个进程中的线程: + +```sh +$ top -b -n 1 -o %CPU + PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND + 911 root 20 0 4021284 471124 20616 S 100.0 5.9 0:04.30 java + +$ top -b -n 2 -d 1 -H -p 911 + PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND + 931 root 20 0 4088924 471252 20616 R 99.9 5.9 0:31.17 order-calc +``` + +线程 931 一直占用一个 CPU。jstack 输出的线程栈中,nid 是线程 ID 的十六进制,931 即 0x3a3: + +```sh +$ printf "%x\n" 931 +3a3 +$ jstack 911 | grep -A3 "nid=0x3a3" +"order-calc" #14 prio=5 os_prio=0 cpu=46406.68ms elapsed=46.46s tid=0x0000ffff80120ad0 nid=0x3a3 runnable + java.lang.Thread.State: RUNNABLE + at Busy.lambda$main$0(Busy.java:11) +``` + +这样就定位到了 Busy.java 第 11 行的死循环。如果是多个 GC 线程占满 CPU,说明在频繁 GC,转而检查内存。Java 进程的排查方法详见 [Java 虚拟机 - 线上问题排查](Java%20虚拟机.md#五线上问题排查)。 + +### 内存占用高 + +```sh +$ free -h + total used free shared buff/cache available +Mem: 7.7Gi 1.1Gi 5.8Gi 564Ki 920Mi 6.5Gi +``` + +需要注意的是,free 列很小不代表内存不足。Linux 会用空闲内存缓存磁盘文件(buff/cache),需要时可以回收,应该看 available 列,它估算的是不使用交换分区还能分配给新程序的内存。 + +Java 进程用 jstat 查看各区的使用率和 GC 次数,用 jmap 统计堆中哪类对象最多: + +```sh +$ jstat -gcutil 911 1000 2 + S0 S1 E O M CCS YGC YGCT FGC FGCT CGC CGCT GCT + 0.00 13.69 0.00 88.90 37.54 3.98 9 0.008 0 0.000 16 0.005 0.014 + +$ jmap -histo:live 911 | head -4 + num #instances #bytes class name (module) + 1: 7529 210056264 [B (java.base@17.0.21) +``` + +老年代(O)已经用了 88.90%,堆中约 200 MB 是 byte 数组,与程序中缓存的 200 个 1 MB 数组对应。老年代使用率持续上升、Full GC 后也降不下来,通常就是内存泄漏,可以用 jmap -dump 导出堆快照分析。需要注意的是,-histo:live 会先触发一次 Full GC,生产环境要谨慎使用。 + +### 端口与磁盘 + +```sh +$ ss -lntp +State Recv-Q Send-Q Local Address:Port Peer Address:Port Process +LISTEN 0 50 *:8080 *:* users:(("java",pid=911,fd=4)) + +$ lsof -i :8080 +COMMAND PID USER FD TYPE DEVICE SIZE/OFF NODE NAME +java 911 root 4u IPv6 5594 0t0 TCP *:http-alt (LISTEN) + +$ df -h / +Filesystem Size Used Avail Use% Mounted on +overlay 453G 24G 406G 6% / +``` + +ss 是 netstat 的替代,速度更快,-l 只看监听的套接字,-n 不解析端口名,-t 只看 TCP,-p 显示进程。磁盘满时先用 df -h 找到满的分区,再用 du -sh * 逐级查找大目录。 + +### 日志分析 + +```sh +$ tail -f app.log # 持续输出新写入的日志 +$ grep -c " 500 " access.log # 统计 500 的行数 +214 +$ awk '{print $9}' access.log | sort | uniq -c | sort -rn # 按状态码统计 + 9510 200 + 276 404 + 214 500 +$ awk '{print $1}' access.log | sort | uniq -c | sort -rn | head -3 # 访问最多的 IP + 2306 10.0.0.3 + 2290 10.0.0.2 + 2280 10.0.0.1 +``` + +以上统计基于一个 1 万行的示例访问日志,第 1 列是 IP,第 9 列是状态码。grep -C 5 可以同时显示匹配行前后各 5 行,查看异常前后发生了什么。 + ## 参考资料 - 鸟哥. 鸟哥的 Linux 私房菜:基础篇 第三版 [M]. 2009. @@ -1250,15 +1341,15 @@ options 参数主要有 WNOHANG 和 WUNTRACED 两个选项,WNOHANG 可以使 w - [What is the difference between a symbolic link and a hard link?](https://stackoverflow.com/questions/185899/what-is-the-difference-between-a-symbolic-link-and-a-hard-link) - [Linux process states](https://idea.popcount.org/2012-12-11-linux-process-states/) - [GUID Partition Table](https://en.wikipedia.org/wiki/GUID_Partition_Table) -- [详解 wait 和 waitpid 函数](https://blog.csdn.net/kevinhg/article/details/7001719) -- [IDE、SATA、SCSI、SAS、FC、SSD 硬盘类型介绍](https://blog.csdn.net/tianlesoftware/article/details/6009110) -- [Akai IB-301S SCSI Interface for S2800,S3000](http://www.mpchunter.com/s3000/akai-ib-301s-scsi-interface-for-s2800s3000/) +- [详解 wait 和 waitpid 函数](https://web.archive.org/web/20251119085359/https://blog.csdn.net/kevinhg/article/details/7001719) +- [IDE、SATA、SCSI、SAS、FC、SSD 硬盘类型介绍](https://web.archive.org/web/20251209102916/https://blog.csdn.net/tianlesoftware/article/details/6009110) +- [Akai IB-301S SCSI Interface for S2800,S3000](https://web.archive.org/web/20100906064755/http://www.mpchunter.com:80/s3000/akai-ib-301s-scsi-interface-for-s2800s3000/) - [Parallel ATA](https://en.wikipedia.org/wiki/Parallel_ATA) - [ADATA XPG SX900 256GB SATA 3 SSD Review – Expanded Capacity and SandForce Driven Speed](http://www.thessdreview.com/our-reviews/adata-xpg-sx900-256gb-sata-3-ssd-review-expanded-capacity-and-sandforce-driven-speed/4/) - [Decoding UCS Invicta – Part 1](https://blogs.cisco.com/datacenter/decoding-ucs-invicta-part-1) - [硬盘](https://zh.wikipedia.org/wiki/%E7%A1%AC%E7%9B%98) - [Difference between SAS and SATA](http://www.differencebetween.info/difference-between-sas-and-sata) - [BIOS](https://zh.wikipedia.org/wiki/BIOS) -- [File system design case studies](https://www.cs.rutgers.edu/\~pxk/416/notes/13-fs-studies.html) +- [File system design case studies](https://web.archive.org/web/20210126111620/https://www.cs.rutgers.edu/~pxk/416/notes/13-fs-studies.html) - [Programming Project #4](https://classes.soe.ucsc.edu/cmps111/Fall08/proj4.shtml) - [FILE SYSTEM DESIGN](http://web.cs.ucla.edu/classes/fall14/cs111/scribe/11a/index.html) diff --git a/notes/MySQL.md b/notes/MySQL.md index abc817580..5b7f27809 100644 --- a/notes/MySQL.md +++ b/notes/MySQL.md @@ -9,6 +9,7 @@ * [索引的优点](#索引的优点) * [索引的使用条件](#索引的使用条件) * [二、查询性能优化](#二查询性能优化) + * [一条 SQL 的执行过程](#一条-sql-的执行过程) * [使用 Explain 进行分析](#使用-explain-进行分析) * [优化数据访问](#优化数据访问) * [重构查询方式](#重构查询方式) @@ -44,7 +45,7 @@ #### 1. 数据结构 -B Tree 指的是 Balance Tree,也就是平衡树。平衡树是一棵查找树,并且所有叶子节点位于同一层。 +B Tree 是一种多路平衡查找树,每个节点可以有多个子节点,并且所有叶子节点位于同一层。 B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具有 B Tree 的平衡性,并且通过顺序访问指针来提高区间查询的性能。 @@ -56,7 +57,7 @@ B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具 进行查找操作时,首先在根节点进行二分查找,找到一个 key 所在的指针,然后递归地在指针所指向的节点进行查找。直到查找到叶子节点,然后在叶子节点上进行二分查找,找出 key 所对应的 data。 -插入删除操作会破坏平衡树的平衡性,因此在进行插入删除操作之后,需要对树进行分裂、合并、旋转等操作来维护平衡性。 +插入删除操作会破坏平衡树的平衡性,因此在进行插入删除操作之后,需要对节点进行分裂、合并或者从相邻节点借用 key 来维护平衡性。 #### 3. 与红黑树的比较 @@ -66,6 +67,8 @@ B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具 平衡树的树高 O(h)=O(logdN),其中 d 为每个节点的出度。红黑树的出度为 2,而 B+ Tree 的出度一般都非常大,所以红黑树的树高 h 很明显比 B+ Tree 大非常多。 +例如本机 MySQL 8.0 中一张 200 万行的 orders 表(平均每行约 200 字节),从 .ibd 文件中读取主键索引根页的 PAGE_LEVEL,值为 2,也就是树高为 3:根页中有 27 条记录,指向 27 个中间页,叶子页约 2.5 万个,每页约 80 行。查找任意一行只需要读 3 个页,而且根页和中间页通常常驻在缓冲池中,实际最多 1 次磁盘 I/O;换成二叉树,200 万个节点的高度约为 21。 + (二)磁盘访问原理 操作系统一般将内存和磁盘分割成固定大小的块,每一块称为一页,内存与磁盘以页为单位交换数据。数据库系统将索引的一个节点的大小设置为页的大小,使得一次 I/O 就能完全载入一个节点。 @@ -76,6 +79,12 @@ B+ Tree 是基于 B Tree 和叶子节点顺序访问指针进行实现,它具 为了减少磁盘 I/O 操作,磁盘往往不是严格按需读取,而是每次都会预读。预读过程中,磁盘进行顺序读取,顺序读取不需要进行磁盘寻道,并且只需要很短的磁盘旋转时间,速度会非常快。并且可以利用预读特性,相邻的节点也能够被预先载入。 +#### 4. 与 B Tree 的比较 + +- B Tree 的每个节点都存放数据,B+ Tree 只有叶子节点存放数据,内部节点只存放 key 和指针,同样大小的页能放下更多的 key,树更矮; +- B+ Tree 的叶子节点按 key 的顺序用指针连接,范围查询找到起点后顺序扫描叶子节点即可,B Tree 则要在不同层的节点之间来回遍历; +- B+ Tree 的每次查找都要走到叶子节点,查询的磁盘 I/O 次数稳定。 + ### MySQL 索引 索引是在存储引擎层实现的,而不是在服务器层实现的,所以不同存储引擎具有不同的索引类型和实现。 @@ -214,6 +223,8 @@ WHERE user_id = 5 AND status > 0 AND create_time > '2025-01-05' -- key_len = 5 不过第二条语句的 Extra 为 Using index condition,也就是索引下推:create_time 虽然不能缩小扫描范围,但仍然在索引上过滤,不满足条件的行不需要回表,所以范围条件之后的列并不是完全没有作用。 +例如 `user_id = 1001 AND create_time >= '2025-01-20'` 跳过了 status,只能用 user_id 定位(key_len = 4),user_id 为 1001 的 20 行中只有 3 行满足时间条件。开启索引下推时 Handler_read_next 为 3,用 `SET optimizer_switch='index_condition_pushdown=off'` 关闭后为 20,也就是多回表了 17 次。 + 需要注意的是,是否使用索引是优化器按成本估算决定的。走二级索引的每一行都要回表,匹配的行越多回表越多,超过一定比例后全表扫描反而更快:`create_time > '2025-01-23'` 匹配 9.9 万行,走 idx_create_time;`create_time > '2025-01-02'` 匹配 191 万行,就选择了全表扫描。IN 也一样,`user_id IN` 5 个值时走索引,3 万多个值时全表扫描。因此同一种写法有时走索引有时不走,可能是因为匹配的数据量不同。 ### 索引的优点 @@ -238,6 +249,18 @@ WHERE user_id = 5 AND status > 0 AND create_time > '2025-01-05' -- key_len = 5 ## 二、查询性能优化 +### 一条 SQL 的执行过程 + +MySQL 分为 Server 层和存储引擎层:Server 层负责连接、解析、优化和执行,存储引擎负责数据的存储和读取,例如 InnoDB。 + +

+ +图中的数据来自本机 MySQL 8.0 上 200 万行的 orders 表。优化器并不是“有索引就用”:idx_create_time 也能用于这个查询,但估算要扫描 98 万行、再回表 98 万次,代价比全表扫描还高;联合索引 idx_user_status_time 的第一列就是 user_id,只需要扫描 20 行。用 EXPLAIN 可以看到最终的选择(key: idx_user_status_time,rows: 20),开启 optimizer_trace 可以看到每种方案的估算代价。 + +需要注意的是,MySQL 5.7 及以前在解析之前还会查询缓存,表一有修改相关的缓存就全部失效,命中率很低,8.0 已经移除了查询缓存。 + +更新语句的执行过程与查询相同,只是在执行器调用 InnoDB 修改数据时,还要写 undo log、redo log 和 binlog,见下文的 [日志](#七日志)。 + ### 使用 Explain 进行分析 Explain 用来分析 SELECT 查询语句,开发人员可以通过分析 Explain 结果来优化查询语句。 @@ -395,7 +418,7 @@ LIMIT 10; - 崩溃恢复:MyISAM 崩溃后发生损坏的概率比 InnoDB 高很多,而且恢复的速度也更慢。 -- 其它特性:MyISAM 支持压缩表和空间数据索引。 +- 其它特性:MyISAM 支持压缩表,空间数据索引 InnoDB 从 MySQL 5.7 起也支持。 ## 四、数据类型 @@ -403,13 +426,13 @@ LIMIT 10; TINYINT, SMALLINT, MEDIUMINT, INT, BIGINT 分别使用 8, 16, 24, 32, 64 位存储空间,一般情况下越小的列越好。 -INT(11) 中的数字只是规定了交互工具显示字符的个数,对于存储和计算来说是没有意义的。 +INT(11) 中的数字只是规定了交互工具显示字符的个数,对于存储和计算来说是没有意义的。MySQL 8.0.17 起这种写法已被废弃,建表时会给出警告 Integer display width is deprecated,SHOW CREATE TABLE 中也只显示 int。 ### 浮点数 FLOAT 和 DOUBLE 为浮点类型,DECIMAL 为高精度小数类型。CPU 原生支持浮点运算,但是不支持 DECIMAL 类型的计算,因此 DECIMAL 的计算比浮点类型需要更高的代价。 -FLOAT、DOUBLE 和 DECIMAL 都可以指定列宽,例如 DECIMAL(18, 9) 表示总共 18 位,取 9 位存储小数部分,剩下 9 位存储整数部分。 +DECIMAL 可以指定精度,例如 DECIMAL(18, 9) 表示总共 18 位,取 9 位存储小数部分,剩下 9 位存储整数部分。FLOAT 和 DOUBLE 也能写成 FLOAT(7, 4) 这种形式,但 MySQL 8.0.17 起已被废弃。金额等需要精确计算的数据应该使用 DECIMAL。 ### 字符串 @@ -425,7 +448,7 @@ MySQL 提供了两种相似的日期时间类型:DATETIME 和 TIMESTAMP。 #### 1. DATETIME -能够保存从 1000 年到 9999 年的日期和时间,精度为秒,使用 5 字节的存储空间(MySQL 5.6.4 之前为 8 字节)。 +能够保存从 1000 年到 9999 年的日期和时间,精度默认为秒,可以用 DATETIME(6) 精确到微秒,使用 5 字节的存储空间(MySQL 5.6.4 之前为 8 字节),小数部分另外占用 0~3 字节。 它与时区无关。 @@ -451,7 +474,7 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需 当一个表的数据不断增多时,Sharding 是必然的选择,它可以将数据分布到集群的不同节点上,从而缓解单个数据库的压力。 -

+

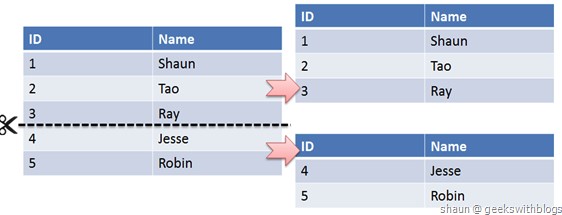
### 垂直切分 @@ -459,7 +482,7 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需 在数据库的层面使用垂直切分将按数据库中表的密集程度部署到不同的库中,例如将原来的电商数据库垂直切分成商品数据库、用户数据库等。 -

+

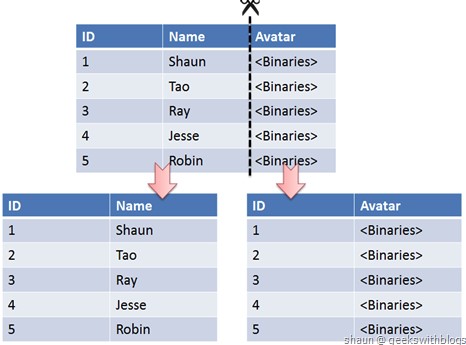
### Sharding 策略 @@ -493,7 +516,7 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需 - **I/O 线程** :负责从主服务器上读取二进制日志,并写入从服务器的中继日志(Relay log)。 - **SQL 线程** :负责读取中继日志,解析出主服务器已经执行的数据更改并在从服务器中重放(Replay)。 -

+

### 读写分离 @@ -502,12 +525,11 @@ TIMESTAMP 比 DATETIME 少占用 1 字节,但是只能表示到 2038 年,需 读写分离能提高性能的原因在于: - 主从服务器负责各自的读和写,极大程度缓解了锁的争用; -- 从服务器可以使用 MyISAM,提升查询性能以及节约系统开销; - 增加冗余,提高可用性。 读写分离常用代理方式来实现,代理服务器接收应用层传来的读写请求,然后决定转发到哪个服务器。 -

+

## 七、日志 @@ -588,3 +610,4 @@ innodb_flush_log_at_trx_commit 和 sync_binlog 的默认值都是 1,也就是 - [MySQL 8.0: Type Conversion in Expression Evaluation](https://dev.mysql.com/doc/refman/8.0/en/type-conversion.html) - [MySQL 8.0: Redo Log](https://dev.mysql.com/doc/refman/8.0/en/innodb-redo-log.html) - [MySQL 8.0: The Binary Log](https://dev.mysql.com/doc/refman/8.0/en/binary-log.html) +- [Replication Implementation | MySQL 8.0 Reference Manual](https://dev.mysql.com/doc/refman/8.0/en/replication-implementation.html) diff --git a/notes/Redis.md b/notes/Redis.md index c26eaa725..c669b03c0 100644 --- a/notes/Redis.md +++ b/notes/Redis.md @@ -2,6 +2,7 @@ * [Redis](#redis) * [一、概述](#一概述) + * [与 MySQL 的区别](#与-mysql-的区别) * [二、数据类型](#二数据类型) * [STRING](#string) * [LIST](#list) @@ -19,6 +20,7 @@ * [消息队列](#消息队列) * [会话缓存](#会话缓存) * [分布式锁实现](#分布式锁实现) + * [排行榜](#排行榜) * [其它](#其它) * [五、Redis 与 Memcached](#五redis-与-memcached) * [数据类型](#数据类型) @@ -31,10 +33,12 @@ * [RDB 持久化](#rdb-持久化) * [AOF 持久化](#aof-持久化) * [九、事务](#九事务) + * [Lua 脚本](#lua-脚本) * [十、事件](#十事件) * [文件事件](#文件事件) * [时间事件](#时间事件) * [事件的调度与执行](#事件的调度与执行) + * [单线程为什么快](#单线程为什么快) * [十一、复制](#十一复制) * [连接过程](#连接过程) * [主从链](#主从链) @@ -57,6 +61,15 @@ Redis 是速度非常快的非关系型(NoSQL)内存键值数据库,可以 Redis 支持很多特性,例如将内存中的数据持久化到硬盘中,使用复制来扩展读性能,使用分片来扩展写性能。 +### 与 MySQL 的区别 + +- 数据位置:Redis 的数据全部在内存中,容量受内存大小限制;MySQL 的数据在磁盘上,内存中的缓冲池只缓存经常访问的页; +- 查询方式:Redis 只能按键访问,值是字符串、哈希、有序集合等数据结构;MySQL 用 SQL 按任意条件查询、联表和聚合,靠索引加速; +- 事务:MySQL 的事务满足 ACID,出错可以回滚;Redis 的事务只保证一组命令依次执行、不被其它客户端的命令插入,其中一条命令执行出错时,其它命令不会回滚,见 [九、事务](#九事务); +- 持久性:MySQL 默认在事务提交时把 redo log 刷到磁盘,提交成功的数据不会因为宕机丢失;Redis 即使开启 AOF 并设置为 everysec,宕机时也可能丢失最近一秒左右的写入。 + +数据都在内存中时,MySQL 按主键查询也很快。在本机用 50 个连接分别压测同一条主键查询和同一个键的 GET,各执行 20 万次:MySQL 每秒约 16 万次,用了约 6 个 CPU 核心,每次查询消耗约 36 微秒的 CPU 时间;Redis 每秒约 11 万次,只用了 1 个核心,每次约 8.7 微秒。Redis 的优势在于开销小、延迟稳定,以及计数器、排行榜这类 MySQL 不擅长的数据结构;需要持久保存、按多种条件查询的业务数据仍然放在 MySQL 中。两者通常一起使用,Redis 作为缓存,见 [缓存与数据库的一致性](缓存.md#缓存一致性)。 + ## 二、数据类型 | 数据类型 | 可以存储的值 | 操作 | @@ -67,146 +80,125 @@ Redis 支持很多特性,例如将内存中的数据持久化到硬盘中, | HASH | 包含键值对的无序散列表 | 添加、获取、移除单个键值对\ 获取所有键值对\ 检查某个键是否存在| | ZSET | 有序集合 | 添加、获取、删除元素\ 根据分值范围或者成员来获取元素\ 计算一个键的排名 | -> [What Redis data structures look like](https://redislabs.com/ebook/part-1-getting-started/chapter-1-getting-to-know-redis/1-2-what-redis-data-structures-look-like/) +> [What Redis data structures look like](https://redis.io/ebook/part-1-getting-started/chapter-1-getting-to-know-redis/1-2-what-redis-data-structures-look-like/) ### STRING -

+

-```html -> set hello world +```text +> set user:1001:name alice OK -> get hello -"world" -> del hello +> get user:1001:name +"alice" +> set page:views 41 +OK +> incr page:views +(integer) 42 +> del user:1001:name (integer) 1 -> get hello +> get user:1001:name (nil) ``` ### LIST -

+

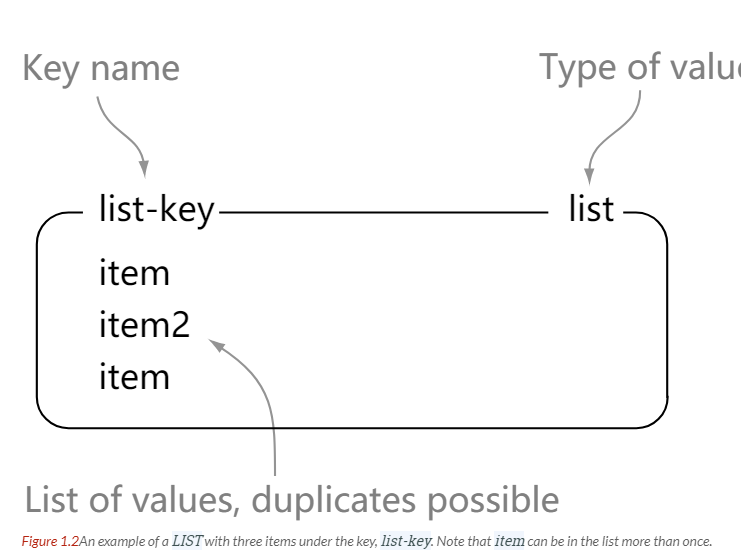
-```html -> rpush list-key item -(integer) 1 -> rpush list-key item2 -(integer) 2 -> rpush list-key item +```text +> rpush orders:queue 1024 1025 1026 (integer) 3 - -> lrange list-key 0 -1 -1) "item" -2) "item2" -3) "item" - -> lindex list-key 1 -"item2" - -> lpop list-key -"item" - -> lrange list-key 0 -1 -1) "item2" -2) "item" +> lpush orders:queue 1023 +(integer) 4 +> lrange orders:queue 0 -1 +1) "1023" +2) "1024" +3) "1025" +4) "1026" +> lindex orders:queue -1 +"1026" +> lpop orders:queue +"1023" +> lrange orders:queue 0 -1 +1) "1024" +2) "1025" +3) "1026" ``` ### SET -

+

-```html -> sadd set-key item -(integer) 1 -> sadd set-key item2 -(integer) 1 -> sadd set-key item3 -(integer) 1 -> sadd set-key item -(integer) 0 - -> smembers set-key -1) "item" -2) "item2" -3) "item3" - -> sismember set-key item4 +```text +> sadd article:7:tags redis cache nosql redis +(integer) 3 +> smembers article:7:tags +1) "redis" +2) "cache" +3) "nosql" +> sismember article:7:tags mysql (integer) 0 -> sismember set-key item +> sismember article:7:tags redis (integer) 1 - -> srem set-key item2 +> srem article:7:tags nosql (integer) 1 -> srem set-key item2 -(integer) 0 - -> smembers set-key -1) "item" -2) "item3" +> sadd article:8:tags redis mysql +(integer) 2 +> sinter article:7:tags article:8:tags +1) "redis" ``` ### HASH -

- -```html -> hset hash-key sub-key1 value1 -(integer) 1 -> hset hash-key sub-key2 value2 -(integer) 1 -> hset hash-key sub-key1 value1 -(integer) 0 - -> hgetall hash-key -1) "sub-key1" -2) "value1" -3) "sub-key2" -4) "value2" +

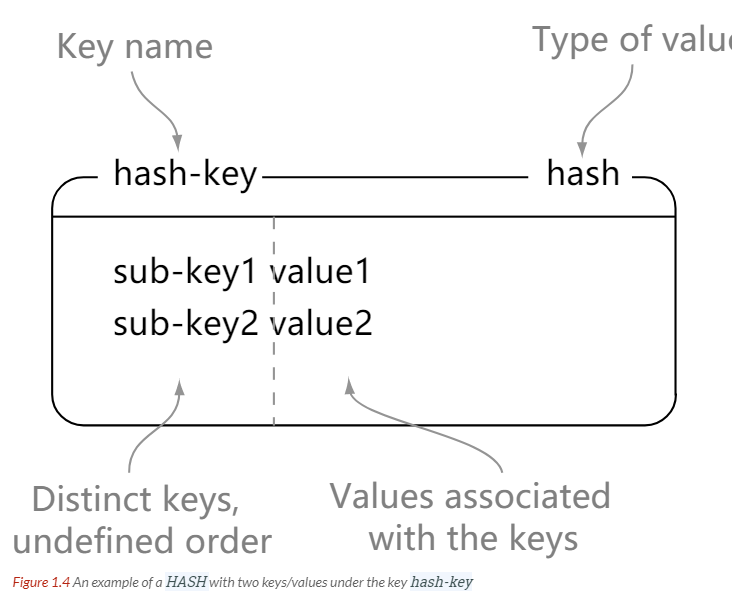
-> hdel hash-key sub-key2 +```text +> hset user:1001 name alice age 25 city hangzhou +(integer) 3 +> hget user:1001 name +"alice" +> hincrby user:1001 age 1 +(integer) 26 +> hdel user:1001 city (integer) 1 -> hdel hash-key sub-key2 -(integer) 0 - -> hget hash-key sub-key1 -"value1" - -> hgetall hash-key -1) "sub-key1" -2) "value1" +> hgetall user:1001 +1) "name" +2) "alice" +3) "age" +4) "26" ``` ### ZSET -

- -```html -> zadd zset-key 728 member1 -(integer) 1 -> zadd zset-key 982 member0 -(integer) 1 -> zadd zset-key 982 member0 -(integer) 0 - -> zrange zset-key 0 -1 withscores -1) "member1" -2) "728" -3) "member0" -4) "982" - -> zrangebyscore zset-key 0 800 withscores -1) "member1" -2) "728" - -> zrem zset-key member1 -(integer) 1 -> zrem zset-key member1 -(integer) 0 +

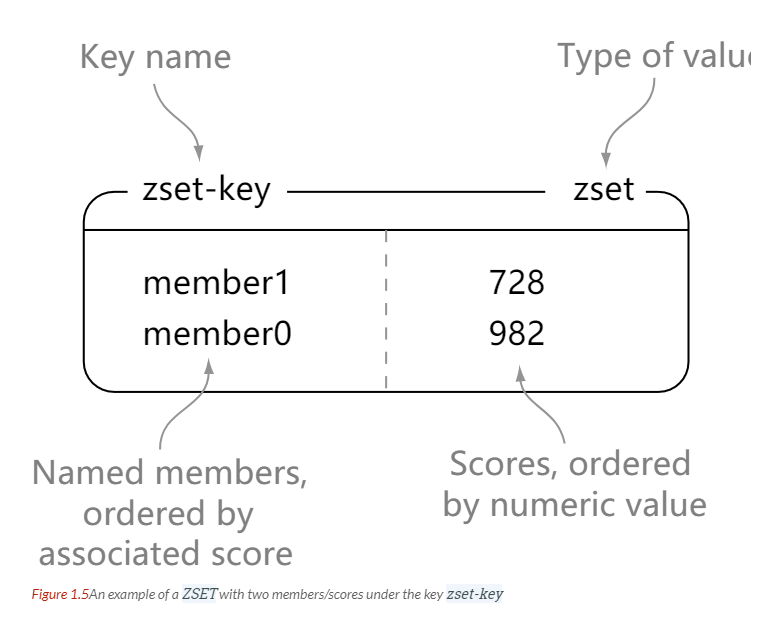
-> zrange zset-key 0 -1 withscores -1) "member0" -2) "982" +```text +> zadd rank:score 92 alice 85 bob 97 carol +(integer) 3 +> zrange rank:score 0 -1 withscores +1) "bob" +2) "85" +3) "alice" +4) "92" +5) "carol" +6) "97" +> zrange rank:score 0 1 rev withscores +1) "carol" +2) "97" +3) "alice" +4) "92" +> zrangebyscore rank:score 90 100 +1) "alice" +2) "carol" +> zincrby rank:score 10 bob +"95" +> zrange rank:score 0 -1 rev withscores +1) "carol" +2) "97" +3) "bob" +4) "95" +5) "alice" +6) "92" ``` ## 三、数据结构 @@ -335,11 +327,9 @@ int dictRehash(dict *d, int n) { 跳跃表是基于多指针有序链表实现的,可以看成多个有序链表。 -

- -在查找时,从上层指针开始查找,找到对应的区间之后再到下一层去查找。下图演示了查找 22 的过程。 +在查找时,从上层指针开始查找,找到对应的区间之后再到下一层去查找。下图演示了查找 26 的过程。 -

+

与红黑树等平衡树相比,跳跃表具有以下优点: @@ -383,6 +373,22 @@ List 是一个双向链表,可以通过 lpush 和 rpop 写入和读取消息 可以使用 SET 命令的 NX 和 PX 选项实现单实例的分布式锁,除此之外,还可以使用官方提出的 RedLock 算法在多个独立实例上实现分布式锁,详见 [分布式](分布式.md)。 +### 排行榜 + +有序集合按分值排序,正好用来实现排行榜:成员是文章或用户的 ID,分值是点赞数或销量。 + +```text +ZINCRBY rank:likes 1 article:1001 -- 点赞一次,分值加 1 +ZREVRANGE rank:likes 0 9 WITHSCORES -- 前 10 名 +ZREVRANK rank:likes article:1001 -- 第几名,从 0 开始 +``` + +在本机向一个有序集合写入 100 万个成员,占用约 105 MB 内存;查前 10 名、查某个成员的排名和加分都是 O(logN) 的操作,SLOWLOG 记录的服务器执行时间大多在 4~10 微秒之间。 + +分值相同时,Redis 按成员名的字典序排列,而业务上通常要求先达到这个分数的排在前面。可以把时间编进分值:分值 = 点赞数 × 1010 + (1010 − 达到这个点赞数的秒级时间戳)。例如 article:1001 和 article:1002 都是 520 个赞,时间戳分别为 1793000000 和 1793000300,分值为 5208207000000 和 5208206999700,先达到的 article:1001 排在前面。需要注意的是,分值是双精度浮点数,只能精确表示 253 以内的整数,这种写法下点赞数不能超过约 90 万,更大时要缩短时间部分的位数。 + +排行榜被大量用户同时查看时,前 10 名这个键会成为热点。前几名的变化不需要实时反映给每个用户,可以在应用的本地缓存中保存 1 秒,大部分请求不再访问 Redis,见 [多级缓存](缓存.md#多级缓存)。 + ### 其它 Set 可以实现交集、并集等操作,从而实现共同好友等功能。 @@ -450,6 +456,8 @@ Redis 是内存型数据库,为了保证数据在断电后不会丢失,需 将某个时间点的所有数据都存放到硬盘上。 +执行 BGSAVE 或满足 save 配置的条件时,Redis fork 一个子进程把内存中的数据写入 RDB 文件,主进程继续处理命令。fork 之后父子进程共享同一份内存页,主进程修改某一页时操作系统才复制这一页(写时复制),所以生成快照期间写入越多,额外占用的内存越多。 + 可以将快照复制到其它服务器从而创建具有相同数据的服务器副本。 如果系统发生故障,将会丢失最后一次创建快照之后的数据。 @@ -474,6 +482,12 @@ Redis 是内存型数据库,为了保证数据在断电后不会丢失,需 随着服务器写请求的增多,AOF 文件会越来越大。Redis 提供了一种将 AOF 重写的特性,能够去除 AOF 文件中的冗余写命令。 +重写同样由子进程完成,它不读取旧的 AOF 文件,而是按内存中的当前数据生成最少的命令。Redis 7.0 起 AOF 由多个文件组成:重写生成的基础文件,以及之后追加写命令的增量文件。 + +

+ +配置项 aof-use-rdb-preamble 默认开启,重写生成的基础文件使用 RDB 格式,称为混合持久化:重启时先载入 RDB 部分,再重放增量文件中的命令,兼顾了 RDB 恢复快和 AOF 丢失数据少的优点。两种持久化都开启时,重启后使用 AOF 恢复,因为它的数据通常更完整。 + ## 九、事务 一个事务包含了多个命令,服务器在执行事务期间,不会改去执行其它客户端的命令请求。 @@ -482,6 +496,54 @@ Redis 是内存型数据库,为了保证数据在断电后不会丢失,需 Redis 最简单的事务实现方式是使用 MULTI 和 EXEC 命令将事务操作包围起来。 +Redis 的事务不支持回滚:EXEC 时某条命令执行出错,其它命令照常执行。例如 name 的值是字符串 alice,对它执行 INCR 会出错,但同一事务中的两条 SET 都生效: + +```text +> multi +OK +> set city hangzhou +QUEUED +> incr name +QUEUED +> set age 25 +QUEUED +> exec +1) OK +2) (error) ERR value is not an integer or out of range +3) OK +``` + +命令入队时就能发现的错误(例如命令不存在),EXEC 会放弃整个事务,返回 EXECABORT。 + +WATCH 可以实现乐观锁:EXEC 之前被 WATCH 的键被其它客户端修改,EXEC 返回 nil,事务中的命令都不执行,由客户端决定是否重试。 + +### Lua 脚本 + +事务中的命令在 EXEC 时才一起执行,不能根据前一条命令的结果决定下一条做什么。Lua 脚本可以做到这一点,并且整个脚本原子执行,执行期间不会插入其它客户端的命令。 + +例如每个用户每天最多领 3 张券,键为 coupon:1001,有效期一天: + +```lua +local n = tonumber(redis.call('GET', KEYS[1]) or '0') +if n >= tonumber(ARGV[1]) then + return 0 +end +redis.call('INCR', KEYS[1]) +if n == 0 then + redis.call('EXPIRE', KEYS[1], ARGV[2]) +end +return n + 1 +``` + +用 redis-cli --eval coupon.lua coupon:1001 , 3 86400 连续执行 4 次,返回值依次为 1、2、3、0。如果在客户端先 GET 再 INCR,两个请求可能同时读到 2,都领到第 3 张。 + +需要注意的是: + +- 脚本中途出错时,之前执行的写命令不会回滚,之后的命令不再执行; +- 脚本执行期间服务器不处理其它命令,脚本要短,不要在其中遍历大集合; +- 脚本用到的键要通过 KEYS 传入,集群模式下这些键必须在同一个槽中; +- 可以先用 SCRIPT LOAD 把脚本缓存在服务器上,之后用 EVALSHA 加脚本的 SHA1 调用,不用每次发送脚本内容。 + ## 十、事件 Redis 服务器是一个事件驱动程序。 @@ -492,7 +554,7 @@ Redis 服务器是一个事件驱动程序。 Redis 基于 Reactor 模式开发了自己的网络事件处理器,使用 I/O 多路复用程序来同时监听多个套接字,并将到达的事件传送给文件事件分派器,分派器会根据套接字产生的事件类型调用相应的事件处理器。 -

+

### 时间事件 @@ -525,7 +587,7 @@ def aeProcessEvents(): # 阻塞并等待文件事件产生,最大阻塞时间由传入的 timeval 决定 aeApiPoll(timeval) # 处理所有已产生的文件事件 - procesFileEvents() + processFileEvents() # 处理所有已到达的时间事件 processTimeEvents() ``` @@ -545,7 +607,20 @@ def main(): 从事件处理的角度来看,服务器运行流程如下: -

+

+ +### 单线程为什么快 + +Redis 用一个线程执行所有命令,仍然很快,原因主要有以下几点: + +- 数据在内存中,一条 GET 只需要查一次哈希表; +- 单线程执行命令,不需要加锁,也没有线程切换的开销; +- I/O 多路复用让一个线程同时处理大量连接; +- 按数据的大小选择不同的编码,例如元素少时用紧凑的 listpack。 + +在本机(Apple M1 Pro,Redis 7.4)用 redis-benchmark 测试,50 个连接逐条发送 GET,每秒约 13 万次;每次连续发送 16 条命令(流水线)时,每秒约 140 万次。逐条发送 100 万次 GET 时,服务器消耗的 CPU 时间中内核态 6.35 秒、用户态 1.18 秒:大部分时间花在网络读写的系统调用上,解析和执行一条命令只需要 1 微秒左右。 + +所以 Redis 的瓶颈通常是网络和内存,而不是 CPU。Redis 6.0 加入了 I/O 多线程(io-threads,默认关闭),只用多个线程读写套接字,命令仍由主线程逐个执行,单条命令的原子性不变。此外,关闭文件、AOF 刷盘和 UNLINK 释放大键的内存这些耗时操作由后台线程完成。 ## 十一、复制 @@ -561,16 +636,34 @@ def main(): 3. 主服务器每执行一次写命令,就向从服务器发送相同的写命令。 +Redis 7.0 起默认不把快照写入磁盘,而是直接通过网络发送给从服务器(repl-diskless-sync yes)。 + +以上是第一次连接时的全量复制。从服务器断线重连后,会带上复制 ID 和自己已经复制到的偏移量发送 PSYNC 命令:如果主服务器的复制积压缓冲区(默认 1 MB)中还保存着之后的写命令,就只发送缺少的部分,称为部分重同步;否则重新进行全量复制。写入量大、断线时间长时,可以调大 repl-backlog-size,避免频繁全量复制。 + ### 主从链 随着负载不断上升,主服务器可能无法很快地更新所有从服务器,或者重新连接和重新同步从服务器将导致系统超载。为了解决这个问题,可以创建一个中间层来分担主服务器的复制工作。中间层的服务器是最上层服务器的从服务器,又是最下层服务器的主服务器。 -

+

## 十二、Sentinel Sentinel(哨兵)可以监听集群中的服务器,并在主服务器进入下线状态时,自动从从服务器中选举出新的主服务器。 +通常部署 3 个或以上的哨兵,故障转移的过程如下: + +1. 主观下线:某个哨兵在 down-after-milliseconds 内没有收到主服务器的有效回复,认为它下线; +2. 客观下线:认为主服务器下线的哨兵数达到配置的 quorum,确认它下线; +3. 选出领头哨兵:哨兵之间投票,得到多数哨兵投票的一个负责这次故障转移,避免多个哨兵同时操作; +4. 选择新的主服务器:排除断线太久的从服务器,再依次比较优先级(replica-priority,越小越优先)、复制偏移量(数据越新越好)和运行 ID; +5. 切换:让选中的从服务器执行 REPLICAOF NO ONE,其它从服务器改为复制它,客户端从哨兵查询到新的地址;原来的主服务器恢复后成为从服务器。 + +

+ +实验中另一个从服务器 6401 改为复制 6402 时,6402 的日志为 Partial resynchronization request from 127.0.0.1:6401 accepted,只发送了 156 字节的积压数据;而重启的 6400 复制 ID 不匹配,只能全量复制。 + +需要注意的是,主从之间是异步复制,切换时还没有复制到从服务器的写入会丢失。网络分区时,旧的主服务器还可能继续接受写入(脑裂),恢复后它变为从服务器,这段时间的写入也会丢失。可以配置 min-replicas-to-write 1 和 min-replicas-max-lag 10:延迟不超过 10 秒的从服务器少于 1 个时,主服务器拒绝写入并返回 NOREPLICAS,把丢失的范围限制在 10 秒左右。 + ## 十三、分片 分片是将数据划分为多个部分的方法,可以将数据存储到多台机器里面,这种方法在解决某些问题时可以获得线性级别的性能提升。 @@ -616,9 +709,9 @@ Redis Cluster 把键空间分为 16384 个哈希槽,每个主节点负责一 文章包括标题、作者、赞数等信息,在关系型数据库中很容易构建一张表来存储这些信息,在 Redis 中可以使用 HASH 来存储每种信息以及其对应的值的映射。 -Redis 没有关系型数据库中的表这一概念来将同种类型的数据存放在一起,而是使用命名空间的方式来实现这一功能。键名的前面部分存储命名空间,后面部分的内容存储 ID,通常使用 : 来进行分隔。例如下面的 HASH 的键名为 article:92617,其中 article 为命名空间,ID 为 92617。 +Redis 没有关系型数据库中的表这一概念来将同种类型的数据存放在一起,而是使用命名空间的方式来实现这一功能。键名的前面部分存储命名空间,后面部分的内容存储 ID,通常使用 : 来进行分隔。例如下面的 HASH 的键名为 article:1001,其中 article 为命名空间,ID 为 1001。 -

+

### 点赞功能 @@ -626,22 +719,27 @@ Redis 没有关系型数据库中的表这一概念来将同种类型的数据 为了节约内存,规定一篇文章发布满一周之后,就不能再对它进行投票,而文章的已投票集合也会被删除,可以为文章的已投票集合设置一个一周的过期时间就能实现这个规定。 -

+

### 对文章进行排序 -为了按发布时间和点赞数进行排序,可以建立一个文章发布时间的有序集合和一个文章点赞数的有序集合。(下图中的 score 就是这里所说的点赞数;下面所示的有序集合分值并不直接是时间和点赞数,而是根据时间和点赞数间接计算出来的) +为了按发布时间和点赞数进行排序,可以建立一个文章发布时间的有序集合和一个文章点赞数的有序集合。两个有序集合的成员都是文章 ID,分值分别是发布时间和点赞数,按分值倒序取前 10 个就是首页要显示的文章。 -

+

## 参考资料 - Carlson J L. Redis in Action[J]. Media.johnwiley.com.au, 2013. - [黄健宏. Redis 设计与实现 [M]. 机械工业出版社, 2014.](http://redisbook.com/index.html) -- [REDIS IN ACTION](https://redislabs.com/ebook/foreword/) +- [REDIS IN ACTION](https://web.archive.org/web/20210421115011/https://redislabs.com/ebook/foreword/) - [Skip Lists: Done Right](http://ticki.github.io/blog/skip-lists-done-right/) - [论述 Redis 和 Memcached 的差异](http://www.cnblogs.com/loveincode/p/7411911.html) - [Redis 3.0 中文版- 分片](http://wiki.jikexueyuan.com/project/redis-guide) - [Redis 应用场景](http://www.scienjus.com/redis-use-case/) - [Using Redis as an LRU cache](https://redis.io/topics/lru-cache) - [Redis: Scale with Redis Cluster](https://redis.io/docs/latest/operate/oss_and_stack/management/scaling/) +- [High availability with Redis Sentinel](https://redis.io/docs/latest/operate/oss_and_stack/management/sentinel/) +- [Redis replication](https://redis.io/docs/latest/operate/oss_and_stack/management/replication/) +- [Redis persistence](https://redis.io/docs/latest/operate/oss_and_stack/management/persistence/) +- [Transactions | Redis](https://redis.io/docs/latest/develop/interact/transactions/) +- [Scripting with Lua | Redis](https://redis.io/docs/latest/develop/interact/programmability/eval-intro/) diff --git "a/notes/SQL \350\257\255\346\263\225.md" "b/notes/SQL \350\257\255\346\263\225.md" index 0d29fe331..8ed88d2b8 100644 --- "a/notes/SQL \350\257\255\346\263\225.md" +++ "b/notes/SQL \350\257\255\346\263\225.md" @@ -701,7 +701,7 @@ COMMIT ```sql CREATE TABLE mytable -(col VARCHAR(10) CHARACTER SET latin COLLATE latin1_general_ci ) +(col VARCHAR(10) CHARACTER SET latin1 COLLATE latin1_general_ci ) DEFAULT CHARACTER SET hebrew COLLATE hebrew_general_ci; ``` diff --git a/notes/Socket.md b/notes/Socket.md index 56cbad756..d179b3873 100644 --- a/notes/Socket.md +++ b/notes/Socket.md @@ -48,15 +48,15 @@ Unix 有五种 I/O 模型: ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags, struct sockaddr *src_addr, socklen_t *addrlen); ``` -

+

### 非阻塞式 I/O -应用进程执行系统调用之后,内核返回一个错误码。应用进程可以继续执行,但是需要不断的执行系统调用来获知 I/O 是否完成,这种方式称为轮询(polling)。 +应用进程执行系统调用之后,如果数据还没有准备好,内核立即返回错误码 EAGAIN(也写作 EWOULDBLOCK)。应用进程可以继续执行,但是需要不断的执行系统调用来获知 I/O 是否完成,这种方式称为轮询(polling)。 由于 CPU 要处理更多的系统调用,因此这种模型的 CPU 利用率比较低。 -

+

### I/O 复用 @@ -66,7 +66,7 @@ ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags, struct sockaddr * 如果一个 Web 服务器没有 I/O 复用,那么每一个 Socket 连接都需要创建一个线程去处理。如果同时有几万个连接,那么就需要创建相同数量的线程。相比于多进程和多线程技术,I/O 复用不需要进程线程创建和切换的开销,系统开销更小。 -

+

### 信号驱动 I/O @@ -74,7 +74,7 @@ ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags, struct sockaddr * 相比于非阻塞式 I/O 的轮询方式,信号驱动 I/O 的 CPU 利用率更高。 -

+

### 异步 I/O @@ -82,7 +82,7 @@ ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags, struct sockaddr * 异步 I/O 与信号驱动 I/O 的区别在于,异步 I/O 的信号是通知应用进程 I/O 完成,而信号驱动 I/O 的信号是通知应用进程可以开始 I/O。 -

+

### 五大 I/O 模型比较 @@ -93,7 +93,7 @@ ssize_t recvfrom(int sockfd, void *buf, size_t len, int flags, struct sockaddr * 非阻塞式 I/O 、信号驱动 I/O 和异步 I/O 在第一阶段不会阻塞。 -

+

## 二、I/O 复用 @@ -138,17 +138,21 @@ tv.tv_usec = 0; int ret = select( largest_sock + 1, &fd_in, &fd_out, NULL, &tv ); // Check if select actually succeed -if ( ret == -1 ) +if ( ret == -1 ) { // report error and abort -else if ( ret == 0 ) +} +else if ( ret == 0 ) { // timeout; no event detected +} else { - if ( FD_ISSET( sock1, &fd_in ) ) + if ( FD_ISSET( sock1, &fd_in ) ) { // input event on sock1 + } - if ( FD_ISSET( sock2, &fd_out ) ) + if ( FD_ISSET( sock2, &fd_out ) ) { // output event on sock2 + } } ``` @@ -184,12 +188,14 @@ fds[1].fd = sock2; fds[1].events = POLLOUT; // Wait 10 seconds -int ret = poll( &fds, 2, 10000 ); +int ret = poll( fds, 2, 10000 ); // Check if poll actually succeed -if ( ret == -1 ) +if ( ret == -1 ) { // report error and abort -else if ( ret == 0 ) +} +else if ( ret == 0 ) { // timeout; no event detected +} else { // If we detect the event, zero it out so we can reuse the structure @@ -234,7 +240,7 @@ epoll_ctl() 用于向内核注册新的描述符或者是改变某个文件描 从上面的描述可以看出,epoll 只需要将描述符从进程缓冲区向内核缓冲区拷贝一次,并且进程不需要通过轮询来获得事件完成的描述符。 -

+

epoll 仅适用于 Linux OS。 @@ -247,8 +253,9 @@ epoll 对多线程编程更加友好,一个线程调用了 epoll_wait() 另一 // The function argument is ignored (it was not before, but now it is), so put your favorite number here int pollingfd = epoll_create( 0xCAFE ); -if ( pollingfd < 0 ) - // report error +if ( pollingfd < 0 ) { + // report error +} // Initialize the epoll structure in case more members are added in future struct epoll_event ev = { 0 }; @@ -261,8 +268,9 @@ ev.data.ptr = pConnection1; ev.events = EPOLLIN | EPOLLONESHOT; // Add the descriptor into the monitoring list. We can do it even if another thread is // waiting in epoll_wait - the descriptor will be properly added -if ( epoll_ctl( epollfd, EPOLL_CTL_ADD, pConnection1->getSocket(), &ev ) != 0 ) +if ( epoll_ctl( pollingfd, EPOLL_CTL_ADD, pConnection1->getSocket(), &ev ) != 0 ) { // report error +} // Wait for up to 20 events (assuming we have added maybe 200 sockets before that it may happen) struct epoll_event pevents[ 20 ]; @@ -270,10 +278,12 @@ struct epoll_event pevents[ 20 ]; // Wait for 10 seconds, and retrieve less than 20 epoll_event and store them into epoll_event array int ready = epoll_wait( pollingfd, pevents, 20, 10000 ); // Check if epoll actually succeed -if ( ret == -1 ) +if ( ready == -1 ) { // report error and abort -else if ( ret == 0 ) +} +else if ( ready == 0 ) { // timeout; no event detected +} else { // Check if any events detected @@ -337,3 +347,4 @@ poll 没有最大描述符数量的限制,如果平台支持并且对实时性 - [poll vs select vs event-based](https://daniel.haxx.se/docs/poll-vs-select.html) - [select / poll / epoll: practical difference for system architects](http://www.ulduzsoft.com/2014/01/select-poll-epoll-practical-difference-for-system-architects/) - [Browse the source code of userspace/glibc/sysdeps/unix/sysv/linux/ online](https://code.woboq.org/userspace/glibc/sysdeps/unix/sysv/linux/) +- [epoll(7) — Linux manual page](https://man7.org/linux/man-pages/man7/epoll.7.html) diff --git a/notes/Spring.md b/notes/Spring.md index f40ca956e..fb75c678a 100644 --- a/notes/Spring.md +++ b/notes/Spring.md @@ -4,6 +4,7 @@ * [一、IoC 与 Bean](#一ioc-与-bean) * [IoC 与依赖注入](#ioc-与依赖注入) * [Bean 的生命周期](#bean-的生命周期) + * [Bean 的作用域与线程安全](#bean-的作用域与线程安全) * [循环依赖](#循环依赖) * [二、AOP](#二aop) * [动态代理](#动态代理) @@ -13,6 +14,14 @@ * [传播行为](#传播行为) * [事务失效](#事务失效) * [四、Spring Boot 自动配置](#四spring-boot-自动配置) + * [五、Spring MVC](#五spring-mvc) + * [请求的处理过程](#请求的处理过程) + * [六、MyBatis](#六mybatis) + * [#{} 和 ${} 的区别](#-和--的区别) + * [Mapper 接口为什么不需要实现类](#mapper-接口为什么不需要实现类) + * [动态 SQL](#动态-sql) + * [缓存](#缓存) + * [七、Spring 中的设计模式](#七spring-中的设计模式) * [参考资料](#参考资料) @@ -41,6 +50,21 @@ public class OrderService { 依赖注入有构造器注入、Setter 注入和字段注入(把 @Autowired 加在字段上)三种方式。Spring 官方推荐构造器注入:依赖可以声明为 final,对象创建出来就是完整可用的,缺少依赖时启动就会失败。 +@Autowired 和 @Resource 都能注入依赖,区别在于查找的顺序: + +- @Autowired 是 Spring 的注解,先按类型查找,找到多个时再按字段名或参数名匹配,仍然无法确定就报错,可以用 @Qualifier 指定 Bean 的名称,或者给其中一个 Bean 加 @Primary; +- @Resource 是 Jakarta EE(原 JSR-250)的注解,指定了 name 时按名称查找,否则先按字段名查找,找不到再按类型查找。 + +例如容器中有两个 PayService 类型的 Bean,名称分别是 alipay 和 wechat: + +```java +@Resource PayService wechat; // 注入名称为 wechat 的 Bean +@Autowired PayService alipay; // 按类型找到两个,再按字段名匹配到 alipay +@Autowired PayService payService; // 字段名匹配不上,启动失败 +``` + +第三行启动时报错 NoUniqueBeanDefinitionException: expected single matching bean but found 2: alipay,wechat。 + ### Bean 的生命周期 一个单例 Bean 从创建到销毁会经过以下步骤: @@ -68,6 +92,29 @@ public class OrderService { 10 DisposableBean.destroy ``` +### Bean 的作用域与线程安全 + +Bean 默认是单例(singleton)的,整个容器中只有一个对象,所有请求共用它。其它常用的作用域: + +- prototype:每次从容器获取都创建一个新对象,容器创建之后就不再管理它,不会调用它的销毁方法; +- request、session:每个 HTTP 请求或会话一个对象,只能在 Web 应用中使用。 + +多个线程同时使用一个单例 Bean 时,Spring 不做任何同步,它是否线程安全取决于有没有可变的成员变量。Controller、Service 通常只持有其他 Bean 的引用,不保存与请求有关的数据,所以是安全的;一旦把请求中的数据存到成员变量里,不同请求就会互相覆盖。例如: + +```java +@RestController +public class CounterController { + private int count = 0; // 所有请求共享 + + @GetMapping("/count") + public int count() { return ++count; } // ++ 不是原子操作 +} +``` + +在本机用 64 个线程并发请求 1 万次,计数只增加了 9975,丢失了 25 次更新。解决方法是不在单例中保存状态,把数据放在方法的局部变量中;确实需要共享时使用 AtomicInteger 等线程安全的类,每个线程各自的数据放在 ThreadLocal 中。 + +需要注意的是,把 prototype 的 Bean 注入到单例中,只会在创建单例时注入一次,之后每次使用的都是同一个对象。需要每次得到新对象时,注入 ObjectProvider 并在使用时调用 getObject()。 + ### 循环依赖 循环依赖指的是两个 Bean 互相依赖,例如 A 依赖 B,B 又依赖 A。 @@ -183,6 +230,8 @@ REQUIRED 有一个常见的问题:内层方法抛出异常后,即使外层 Spring Boot 在 Spring 的基础上提供了自动配置和 starter:starter 把一组常用的依赖打包在一起,例如 spring-boot-starter-web 引入了 Spring MVC、内嵌的 Tomcat 和 JSON 库;自动配置则根据引入的依赖自动创建所需的 Bean,不需要手动配置就能启动一个 Web 应用。 +Spring Boot 并不是新的框架,容器、AOP、事务仍然是 Spring 提供的。除了 starter 和自动配置,它还能把应用连同内嵌的服务器打包成一个 jar,用 java -jar 直接运行,不再需要把 war 包部署到单独安装的 Tomcat 中。 + 自动配置的过程: 1. 启动类上的 @SpringBootApplication 包含了 @EnableAutoConfiguration; @@ -191,6 +240,115 @@ Spring Boot 在 Spring 的基础上提供了自动配置和 starter:starter 例如引入 spring-boot-starter-jdbc 和数据库驱动后,数据源的自动配置类就会生效,按配置文件中的地址创建一个 DataSource;如果用户自己定义了 DataSource,由于 @ConditionalOnMissingBean,自动配置不再创建。因此用户的配置总是优先于自动配置。 +## 五、Spring MVC + +### 请求的处理过程 + +所有请求都先交给一个 DispatcherServlet,由它的 doDispatch 方法完成分发: + +1. 通过 HandlerMapping 找到处理这个请求的方法(Handler),以及要经过的拦截器,组成 HandlerExecutionChain; +2. 依次执行拦截器的 preHandle,任何一个返回 false 就不再继续; +3. 通过 HandlerAdapter 调用 Controller 的方法,调用前把请求参数转换为方法参数,调用后把返回值转换为响应,例如用 Jackson 把对象写成 JSON; +4. 倒序执行拦截器的 postHandle; +5. 返回的是视图名时,由 ViewResolver 找到视图并渲染;@RestController 直接把返回值写入响应体,没有这一步; +6. 倒序执行拦截器的 afterCompletion,即使前面发生了异常也会执行,常用于清理资源。 + +在 Spring Boot 3.3(Spring MVC 6.1)中注册一个打印日志的拦截器,请求 GET /orders?userId=1024 时依次输出: + +```text +[interceptor] preHandle /orders handler=demo.App$OrderController#list(int) +[controller] OrderController.list(1024) +[interceptor] postHandle +[interceptor] afterCompletion status=200 +``` + +拦截器与过滤器(Filter)的区别:过滤器是 Servlet 规范定义的,在请求进入 DispatcherServlet 之前执行,拿不到要调用哪个 Controller 方法;拦截器由 Spring MVC 调用,可以拿到 Handler,并且能使用 Spring 容器中的 Bean。 + +## 六、MyBatis + +### #{} 和 ${} 的区别 + +MyBatis 中 #{} 会被替换为占位符 ?,参数通过 PreparedStatement 单独传给数据库;${} 则是把参数直接拼接到 SQL 字符串中。用 ${} 时,传入的参数会改变 SQL 的结构,造成 SQL 注入: + +```java +@Select("SELECT id, user_id AS userId, status FROM orders WHERE user_id = #{userId} ORDER BY id LIMIT 3") +List byUser(@Param("userId") int userId); + +@Select("SELECT id, user_id AS userId, status FROM orders WHERE user_id = ${userId} ORDER BY id LIMIT 3") +List byUserUnsafe(@Param("userId") String userId); +``` + +参数传入 1024 OR 1=1 时,MyBatis 输出的 SQL 分别为: + +```text +==> Preparing: SELECT ... WHERE user_id = ? ORDER BY id LIMIT 3 +==> Parameters: 1024(Integer) + +==> Preparing: SELECT ... WHERE user_id = 1024 OR 1=1 ORDER BY id LIMIT 3 +==> Parameters: +``` + +第二条语句的条件恒为真,返回了其他用户的订单。${} 只用于表名、列名、ORDER BY 的字段这类不能使用占位符的地方,并且要用白名单校验参数。 + +### Mapper 接口为什么不需要实现类 + +MyBatis 在启动时为每个 Mapper 接口生成 JDK 动态代理,例如上面的 OrderMapper 注入的对象类型是 jdk.proxy2.$Proxy63,调用处理器是 MapperProxy。调用接口方法时,MapperProxy 按“接口全名 + 方法名”找到对应的 SQL,绑定参数后交给 SqlSession 执行,再把结果映射成返回类型。 + +### 动态 SQL + +XML 中可以用 if、where、foreach 等标签按参数拼接 SQL: + +```xml + +``` + +只传 status 时生成 WHERE status = ?,两个都传时生成 WHERE user_id = ? AND status = ?,where 标签会去掉开头多余的 AND。 + +### 缓存 + +- 一级缓存:默认开启,作用范围是一个 SqlSession,同一个会话中相同的查询只执行一次,执行增删改或提交后清空。与 Spring 集成时,不在事务中的每次调用都会使用新的 SqlSession,一级缓存基本不起作用; +- 二级缓存:需要在 Mapper 中配置 cache 才开启,多个会话共享,但缓存在单个应用的内存中,多个实例之间不一致,实际项目中很少使用,通常用 Redis 等缓存代替。 + +## 七、Spring 中的设计模式 + +| 模式 | Spring 中的例子 | 解决的问题 | +| --- | --- | --- | +| [工厂](设计模式%20-%20工厂方法.md) | BeanFactory、FactoryBean | 使用者只按名称或类型获取对象,不关心对象怎样创建 | +| [单例](设计模式%20%20-%20单例.md) | 默认的 singleton 作用域,由 DefaultSingletonBeanRegistry 保存 | 每个 Bean 在容器中只有一个对象,不是通过私有构造函数实现的 | +| [代理](设计模式%20-%20代理.md) | AOP 的 JdkDynamicAopProxy、CglibAopProxy | 在不修改原类的情况下加入事务、日志等逻辑,见 [动态代理](#动态代理) | +| [模板方法](设计模式%20-%20模板方法.md) | JdbcTemplate、TransactionTemplate、AbstractApplicationContext 的 refresh() | 固定的步骤(获取连接、执行、释放、处理异常)由框架完成,变化的部分由使用者传入 | +| [观察者](设计模式%20-%20观察者.md) | ApplicationEvent、ApplicationListener、@EventListener | 发布方不需要知道有哪些接收方 | +| [适配器](设计模式%20-%20适配器.md) | Spring MVC 的 HandlerAdapter | DispatcherServlet 用同一个接口调用不同形式的处理器,见 [请求的处理过程](#请求的处理过程) | +| [责任链](设计模式%20-%20责任链.md) | HandlerExecutionChain 中的拦截器、AOP 的 ReflectiveMethodInvocation | 多个拦截器或通知依次处理同一个请求 | +| [策略](设计模式%20-%20策略.md) | InstantiationStrategy、Resource 的多种实现 | 同一件事有多种做法,运行时选择其中一种 | + +以观察者模式为例,订单支付成功后需要加积分、发短信,用事件解耦后,订单服务只负责发布事件: + +```java +public record OrderPaidEvent(long orderId) {} + +publisher.publishEvent(new OrderPaidEvent(1024)); // 订单服务,publisher 是注入的 ApplicationEventPublisher + +@EventListener +public void on(OrderPaidEvent e) { ... } // 积分服务、短信服务各写一个监听方法 +``` + +需要注意的是,监听方法默认在发布事件的线程中同步执行。在 Spring Boot 3.3 中让短信服务的监听方法抛出异常,输出如下: + +```text +[main] 订单 1024 支付成功,发布事件 +[main] 短信服务:发送失败 +[main] 发布方收到异常:短信网关超时 +``` + +两个监听方法都在 main 线程中执行;短信服务先执行并抛出异常后,积分服务的监听方法没有被调用,异常还传回了订单服务。监听方法之间的顺序默认不确定,可以用 @Order 指定;不希望互相影响时,加上 @Async 让监听方法在线程池中异步执行,或者用 @TransactionalEventListener 在订单的事务提交之后再处理。 + ## 参考资料 - [Spring Framework: Dependency Injection](https://docs.spring.io/spring-framework/reference/core/beans/dependencies/factory-collaborators.html) @@ -203,3 +361,5 @@ Spring Boot 在 Spring 的基础上提供了自动配置和 starter:starter - [Spring Boot: Creating Your Own Auto-configuration](https://docs.spring.io/spring-boot/reference/features/developing-auto-configuration.html) - [Spring Boot 2.6 Release Notes](https://github.com/spring-projects/spring-boot/wiki/Spring-Boot-2.6-Release-Notes) - [Spring Boot 2.7 Release Notes](https://github.com/spring-projects/spring-boot/wiki/Spring-Boot-2.7-Release-Notes) +- [MyBatis 3 文档](https://mybatis.org/mybatis-3/zh_CN/index.html) +- [DispatcherServlet | Spring Framework 文档](https://docs.spring.io/spring-framework/reference/web/webmvc/mvc-servlet.html) diff --git a/notes/pics/acid.png b/notes/pics/acid.png new file mode 100644 index 000000000..0cfcef06f Binary files /dev/null and b/notes/pics/acid.png differ diff --git a/notes/pics/adapter-turkey.png b/notes/pics/adapter-turkey.png new file mode 100644 index 000000000..dcc5f8b86 Binary files /dev/null and b/notes/pics/adapter-turkey.png differ diff --git a/notes/pics/cdn.png b/notes/pics/cdn.png new file mode 100644 index 000000000..e29eac630 Binary files /dev/null and b/notes/pics/cdn.png differ diff --git a/notes/pics/cert-chain.png b/notes/pics/cert-chain.png new file mode 100644 index 000000000..33a000977 Binary files /dev/null and b/notes/pics/cert-chain.png differ diff --git a/notes/pics/clock.png b/notes/pics/clock.png new file mode 100644 index 000000000..ea355824b Binary files /dev/null and b/notes/pics/clock.png differ diff --git a/notes/pics/coding-agent.png b/notes/pics/coding-agent.png new file mode 100644 index 000000000..74a9ebb90 Binary files /dev/null and b/notes/pics/coding-agent.png differ diff --git a/notes/pics/command-remote.png b/notes/pics/command-remote.png new file mode 100644 index 000000000..b3693b6aa Binary files /dev/null and b/notes/pics/command-remote.png differ diff --git a/notes/pics/compile-pipeline.png b/notes/pics/compile-pipeline.png new file mode 100644 index 000000000..2af854c6a Binary files /dev/null and b/notes/pics/compile-pipeline.png differ diff --git a/notes/pics/consistent-hash.png b/notes/pics/consistent-hash.png new file mode 100644 index 000000000..b3dad47a6 Binary files /dev/null and b/notes/pics/consistent-hash.png differ diff --git a/notes/pics/crypto-asymmetric.png b/notes/pics/crypto-asymmetric.png new file mode 100644 index 000000000..a3bc2a15b Binary files /dev/null and b/notes/pics/crypto-asymmetric.png differ diff --git a/notes/pics/crypto-symmetric.png b/notes/pics/crypto-symmetric.png new file mode 100644 index 000000000..cc138e6d0 Binary files /dev/null and b/notes/pics/crypto-symmetric.png differ diff --git a/notes/pics/deadlock-banker-multi.png b/notes/pics/deadlock-banker-multi.png new file mode 100644 index 000000000..95c57b6d9 Binary files /dev/null and b/notes/pics/deadlock-banker-multi.png differ diff --git a/notes/pics/deadlock-banker-single.png b/notes/pics/deadlock-banker-single.png new file mode 100644 index 000000000..f11d25fb1 Binary files /dev/null and b/notes/pics/deadlock-banker-single.png differ diff --git a/notes/pics/deadlock-detect-graph.png b/notes/pics/deadlock-detect-graph.png new file mode 100644 index 000000000..4fc166d7e Binary files /dev/null and b/notes/pics/deadlock-detect-graph.png differ diff --git a/notes/pics/deadlock-detect-matrix.png b/notes/pics/deadlock-detect-matrix.png new file mode 100644 index 000000000..643e29074 Binary files /dev/null and b/notes/pics/deadlock-detect-matrix.png differ diff --git a/notes/pics/deadlock-safe-state.png b/notes/pics/deadlock-safe-state.png new file mode 100644 index 000000000..bb8da3850 Binary files /dev/null and b/notes/pics/deadlock-safe-state.png differ diff --git a/notes/pics/deadlock-transfer.png b/notes/pics/deadlock-transfer.png new file mode 100644 index 000000000..f6deebb33 Binary files /dev/null and b/notes/pics/deadlock-transfer.png differ diff --git a/notes/pics/decorator-cost.png b/notes/pics/decorator-cost.png new file mode 100644 index 000000000..e85670ba6 Binary files /dev/null and b/notes/pics/decorator-cost.png differ diff --git a/notes/pics/dhcp.png b/notes/pics/dhcp.png new file mode 100644 index 000000000..08932a449 Binary files /dev/null and b/notes/pics/dhcp.png differ diff --git a/notes/pics/disk-scan.png b/notes/pics/disk-scan.png new file mode 100644 index 000000000..1f0012fb3 Binary files /dev/null and b/notes/pics/disk-scan.png differ diff --git a/notes/pics/disk-sstf.png b/notes/pics/disk-sstf.png new file mode 100644 index 000000000..abbfeabf2 Binary files /dev/null and b/notes/pics/disk-sstf.png differ diff --git a/notes/pics/dns-resolve.png b/notes/pics/dns-resolve.png new file mode 100644 index 000000000..89ffbfbd6 Binary files /dev/null and b/notes/pics/dns-resolve.png differ diff --git a/notes/pics/docker-layers.png b/notes/pics/docker-layers.png new file mode 100644 index 000000000..a16025c8d Binary files /dev/null and b/notes/pics/docker-layers.png differ diff --git a/notes/pics/docker-vs-vm.png b/notes/pics/docker-vs-vm.png new file mode 100644 index 000000000..09f3f8a00 Binary files /dev/null and b/notes/pics/docker-vs-vm.png differ diff --git a/notes/pics/docker-why.png b/notes/pics/docker-why.png new file mode 100644 index 000000000..e0399ad68 Binary files /dev/null and b/notes/pics/docker-why.png differ diff --git a/notes/pics/dynamic-link.png b/notes/pics/dynamic-link.png new file mode 100644 index 000000000..f0cf19c8a Binary files /dev/null and b/notes/pics/dynamic-link.png differ diff --git a/notes/pics/email-flow.png b/notes/pics/email-flow.png new file mode 100644 index 000000000..f2b88cd11 Binary files /dev/null and b/notes/pics/email-flow.png differ diff --git a/notes/pics/ext-layout.png b/notes/pics/ext-layout.png new file mode 100644 index 000000000..9e3acb10e Binary files /dev/null and b/notes/pics/ext-layout.png differ diff --git a/notes/pics/facade-movie.png b/notes/pics/facade-movie.png new file mode 100644 index 000000000..226c68200 Binary files /dev/null and b/notes/pics/facade-movie.png differ diff --git a/notes/pics/feed-push-pull.png b/notes/pics/feed-push-pull.png new file mode 100644 index 000000000..54a8cc736 Binary files /dev/null and b/notes/pics/feed-push-pull.png differ diff --git a/notes/pics/fifo.png b/notes/pics/fifo.png new file mode 100644 index 000000000..6422dba64 Binary files /dev/null and b/notes/pics/fifo.png differ diff --git a/notes/pics/ftp-modes.png b/notes/pics/ftp-modes.png new file mode 100644 index 000000000..430e19c22 Binary files /dev/null and b/notes/pics/ftp-modes.png differ diff --git a/notes/pics/gc-cms.png b/notes/pics/gc-cms.png new file mode 100644 index 000000000..8df701cc5 Binary files /dev/null and b/notes/pics/gc-cms.png differ diff --git a/notes/pics/gc-collectors.png b/notes/pics/gc-collectors.png new file mode 100644 index 000000000..a5cc6143f Binary files /dev/null and b/notes/pics/gc-collectors.png differ diff --git a/notes/pics/gc-g1-cycle.png b/notes/pics/gc-g1-cycle.png new file mode 100644 index 000000000..bc22faca3 Binary files /dev/null and b/notes/pics/gc-g1-cycle.png differ diff --git a/notes/pics/gc-g1-regions.png b/notes/pics/gc-g1-regions.png new file mode 100644 index 000000000..41733ed77 Binary files /dev/null and b/notes/pics/gc-g1-regions.png differ diff --git a/notes/pics/gc-generations.png b/notes/pics/gc-generations.png new file mode 100644 index 000000000..4ff636bec Binary files /dev/null and b/notes/pics/gc-generations.png differ diff --git a/notes/pics/gc-parallel.png b/notes/pics/gc-parallel.png new file mode 100644 index 000000000..c98615f23 Binary files /dev/null and b/notes/pics/gc-parallel.png differ diff --git a/notes/pics/gc-parnew.png b/notes/pics/gc-parnew.png new file mode 100644 index 000000000..7f8466b83 Binary files /dev/null and b/notes/pics/gc-parnew.png differ diff --git a/notes/pics/gc-serial.png b/notes/pics/gc-serial.png new file mode 100644 index 000000000..209606776 Binary files /dev/null and b/notes/pics/gc-serial.png differ diff --git a/notes/pics/gpt-layout.png b/notes/pics/gpt-layout.png new file mode 100644 index 000000000..468a281cb Binary files /dev/null and b/notes/pics/gpt-layout.png differ diff --git a/notes/pics/h2-frames.png b/notes/pics/h2-frames.png new file mode 100644 index 000000000..b98a7ff2e Binary files /dev/null and b/notes/pics/h2-frames.png differ diff --git a/notes/pics/h2-push.png b/notes/pics/h2-push.png new file mode 100644 index 000000000..c78899327 Binary files /dev/null and b/notes/pics/h2-push.png differ diff --git a/notes/pics/h2-streams.png b/notes/pics/h2-streams.png new file mode 100644 index 000000000..b8064e402 Binary files /dev/null and b/notes/pics/h2-streams.png differ diff --git a/notes/pics/harness-loop.png b/notes/pics/harness-loop.png new file mode 100644 index 000000000..ef8af9d54 Binary files /dev/null and b/notes/pics/harness-loop.png differ diff --git a/notes/pics/hpack.png b/notes/pics/hpack.png new file mode 100644 index 000000000..bc0e928bb Binary files /dev/null and b/notes/pics/hpack.png differ diff --git a/notes/pics/http-connect.png b/notes/pics/http-connect.png new file mode 100644 index 000000000..0ab53eaa8 Binary files /dev/null and b/notes/pics/http-connect.png differ diff --git a/notes/pics/http-connections.png b/notes/pics/http-connections.png new file mode 100644 index 000000000..b255b9f2c Binary files /dev/null and b/notes/pics/http-connections.png differ diff --git a/notes/pics/http-proxy.png b/notes/pics/http-proxy.png new file mode 100644 index 000000000..aea75d78a Binary files /dev/null and b/notes/pics/http-proxy.png differ diff --git a/notes/pics/https-hybrid.png b/notes/pics/https-hybrid.png new file mode 100644 index 000000000..11c444278 Binary files /dev/null and b/notes/pics/https-hybrid.png differ diff --git a/notes/pics/https-layers.png b/notes/pics/https-layers.png new file mode 100644 index 000000000..dcbaf8fd9 Binary files /dev/null and b/notes/pics/https-layers.png differ diff --git a/notes/pics/inode-pointers.png b/notes/pics/inode-pointers.png new file mode 100644 index 000000000..d03a8854a Binary files /dev/null and b/notes/pics/inode-pointers.png differ diff --git a/notes/pics/io-async.png b/notes/pics/io-async.png new file mode 100644 index 000000000..728ab3a7c Binary files /dev/null and b/notes/pics/io-async.png differ diff --git a/notes/pics/io-blocking.png b/notes/pics/io-blocking.png new file mode 100644 index 000000000..d2d0f5035 Binary files /dev/null and b/notes/pics/io-blocking.png differ diff --git a/notes/pics/io-compare.png b/notes/pics/io-compare.png new file mode 100644 index 000000000..470432bc1 Binary files /dev/null and b/notes/pics/io-compare.png differ diff --git a/notes/pics/io-multiplex.png b/notes/pics/io-multiplex.png new file mode 100644 index 000000000..f00a310bd Binary files /dev/null and b/notes/pics/io-multiplex.png differ diff --git a/notes/pics/io-nonblocking.png b/notes/pics/io-nonblocking.png new file mode 100644 index 000000000..1c65449eb Binary files /dev/null and b/notes/pics/io-nonblocking.png differ diff --git a/notes/pics/io-signal.png b/notes/pics/io-signal.png new file mode 100644 index 000000000..b700a40b2 Binary files /dev/null and b/notes/pics/io-signal.png differ diff --git a/notes/pics/java-exceptions.png b/notes/pics/java-exceptions.png new file mode 100644 index 000000000..7645d8d57 Binary files /dev/null and b/notes/pics/java-exceptions.png differ diff --git a/notes/pics/jc-atomic-cas.png b/notes/pics/jc-atomic-cas.png new file mode 100644 index 000000000..5b68499a2 Binary files /dev/null and b/notes/pics/jc-atomic-cas.png differ diff --git a/notes/pics/jc-cnt-race.png b/notes/pics/jc-cnt-race.png new file mode 100644 index 000000000..d1e0f5482 Binary files /dev/null and b/notes/pics/jc-cnt-race.png differ diff --git a/notes/pics/jc-countdownlatch.png b/notes/pics/jc-countdownlatch.png new file mode 100644 index 000000000..42db01ffb Binary files /dev/null and b/notes/pics/jc-countdownlatch.png differ diff --git a/notes/pics/jc-cpu-cache.png b/notes/pics/jc-cpu-cache.png new file mode 100644 index 000000000..ab1707b5d Binary files /dev/null and b/notes/pics/jc-cpu-cache.png differ diff --git a/notes/pics/jc-cyclicbarrier.png b/notes/pics/jc-cyclicbarrier.png new file mode 100644 index 000000000..d648ece81 Binary files /dev/null and b/notes/pics/jc-cyclicbarrier.png differ diff --git a/notes/pics/jc-hb-join.png b/notes/pics/jc-hb-join.png new file mode 100644 index 000000000..7ac8279fa Binary files /dev/null and b/notes/pics/jc-hb-join.png differ diff --git a/notes/pics/jc-hb-monitor.png b/notes/pics/jc-hb-monitor.png new file mode 100644 index 000000000..8be8854a6 Binary files /dev/null and b/notes/pics/jc-hb-monitor.png differ diff --git a/notes/pics/jc-hb-program-order.png b/notes/pics/jc-hb-program-order.png new file mode 100644 index 000000000..40ae53343 Binary files /dev/null and b/notes/pics/jc-hb-program-order.png differ diff --git a/notes/pics/jc-hb-start.png b/notes/pics/jc-hb-start.png new file mode 100644 index 000000000..40f9421ae Binary files /dev/null and b/notes/pics/jc-hb-start.png differ diff --git a/notes/pics/jc-hb-volatile.png b/notes/pics/jc-hb-volatile.png new file mode 100644 index 000000000..9b36c6732 Binary files /dev/null and b/notes/pics/jc-hb-volatile.png differ diff --git a/notes/pics/jc-jmm-ops.png b/notes/pics/jc-jmm-ops.png new file mode 100644 index 000000000..decc984cf Binary files /dev/null and b/notes/pics/jc-jmm-ops.png differ diff --git a/notes/pics/jc-jmm.png b/notes/pics/jc-jmm.png new file mode 100644 index 000000000..9db572bef Binary files /dev/null and b/notes/pics/jc-jmm.png differ diff --git a/notes/pics/jc-threadlocal.png b/notes/pics/jc-threadlocal.png new file mode 100644 index 000000000..fab252695 Binary files /dev/null and b/notes/pics/jc-threadlocal.png differ diff --git a/notes/pics/jc-work-stealing.png b/notes/pics/jc-work-stealing.png new file mode 100644 index 000000000..9502efd56 Binary files /dev/null and b/notes/pics/jc-work-stealing.png differ diff --git a/notes/pics/kafka-topic.png b/notes/pics/kafka-topic.png new file mode 100644 index 000000000..127fa40b8 Binary files /dev/null and b/notes/pics/kafka-topic.png differ diff --git a/notes/pics/lb-dns.png b/notes/pics/lb-dns.png new file mode 100644 index 000000000..193456832 Binary files /dev/null and b/notes/pics/lb-dns.png differ diff --git a/notes/pics/lb-http-redirect.png b/notes/pics/lb-http-redirect.png new file mode 100644 index 000000000..da0c3fa94 Binary files /dev/null and b/notes/pics/lb-http-redirect.png differ diff --git a/notes/pics/lb-ip-hash.png b/notes/pics/lb-ip-hash.png new file mode 100644 index 000000000..c9cbe07d3 Binary files /dev/null and b/notes/pics/lb-ip-hash.png differ diff --git a/notes/pics/lb-least-conn-problem.png b/notes/pics/lb-least-conn-problem.png new file mode 100644 index 000000000..989050faa Binary files /dev/null and b/notes/pics/lb-least-conn-problem.png differ diff --git a/notes/pics/lb-least-conn.png b/notes/pics/lb-least-conn.png new file mode 100644 index 000000000..a18dbccd6 Binary files /dev/null and b/notes/pics/lb-least-conn.png differ diff --git a/notes/pics/lb-random.png b/notes/pics/lb-random.png new file mode 100644 index 000000000..78ec1e840 Binary files /dev/null and b/notes/pics/lb-random.png differ diff --git a/notes/pics/lb-round-robin-weak.png b/notes/pics/lb-round-robin-weak.png new file mode 100644 index 000000000..7a3250a4b Binary files /dev/null and b/notes/pics/lb-round-robin-weak.png differ diff --git a/notes/pics/lb-round-robin.png b/notes/pics/lb-round-robin.png new file mode 100644 index 000000000..b4d2f0085 Binary files /dev/null and b/notes/pics/lb-round-robin.png differ diff --git a/notes/pics/lb-weighted-round-robin.png b/notes/pics/lb-weighted-round-robin.png new file mode 100644 index 000000000..cbbbd79d9 Binary files /dev/null and b/notes/pics/lb-weighted-round-robin.png differ diff --git a/notes/pics/lock-level-1.png b/notes/pics/lock-level-1.png new file mode 100644 index 000000000..3001ced5b Binary files /dev/null and b/notes/pics/lock-level-1.png differ diff --git a/notes/pics/lock-level-2.png b/notes/pics/lock-level-2.png new file mode 100644 index 000000000..396a33d31 Binary files /dev/null and b/notes/pics/lock-level-2.png differ diff --git a/notes/pics/lock-level-3.png b/notes/pics/lock-level-3.png new file mode 100644 index 000000000..3ade520b0 Binary files /dev/null and b/notes/pics/lock-level-3.png differ diff --git a/notes/pics/lock-record.png b/notes/pics/lock-record.png new file mode 100644 index 000000000..b88a03fd1 Binary files /dev/null and b/notes/pics/lock-record.png differ diff --git a/notes/pics/lock-states.png b/notes/pics/lock-states.png new file mode 100644 index 000000000..b36faed0c Binary files /dev/null and b/notes/pics/lock-states.png differ diff --git a/notes/pics/lru-stack.png b/notes/pics/lru-stack.png new file mode 100644 index 000000000..b6c7c64cd Binary files /dev/null and b/notes/pics/lru-stack.png differ diff --git a/notes/pics/markword.png b/notes/pics/markword.png new file mode 100644 index 000000000..5d1d70872 Binary files /dev/null and b/notes/pics/markword.png differ diff --git a/notes/pics/mbr-multiboot.png b/notes/pics/mbr-multiboot.png new file mode 100644 index 000000000..707a31b5a Binary files /dev/null and b/notes/pics/mbr-multiboot.png differ diff --git a/notes/pics/mediator-after.png b/notes/pics/mediator-after.png new file mode 100644 index 000000000..ef5f90e31 Binary files /dev/null and b/notes/pics/mediator-after.png differ diff --git a/notes/pics/mediator-before.png b/notes/pics/mediator-before.png new file mode 100644 index 000000000..ecbf55343 Binary files /dev/null and b/notes/pics/mediator-before.png differ diff --git a/notes/pics/mime.png b/notes/pics/mime.png new file mode 100644 index 000000000..14b2e4650 Binary files /dev/null and b/notes/pics/mime.png differ diff --git a/notes/pics/modulation.png b/notes/pics/modulation.png new file mode 100644 index 000000000..5bdc389a5 Binary files /dev/null and b/notes/pics/modulation.png differ diff --git a/notes/pics/multilevel-cache.png b/notes/pics/multilevel-cache.png new file mode 100644 index 000000000..55e590d7f Binary files /dev/null and b/notes/pics/multilevel-cache.png differ diff --git a/notes/pics/mvcc-readview.png b/notes/pics/mvcc-readview.png new file mode 100644 index 000000000..d6037bae2 Binary files /dev/null and b/notes/pics/mvcc-readview.png differ diff --git a/notes/pics/mvcc-undo-chain.png b/notes/pics/mvcc-undo-chain.png new file mode 100644 index 000000000..1a3fb476d Binary files /dev/null and b/notes/pics/mvcc-undo-chain.png differ diff --git a/notes/pics/mysql-replication.png b/notes/pics/mysql-replication.png new file mode 100644 index 000000000..2424d7926 Binary files /dev/null and b/notes/pics/mysql-replication.png differ diff --git a/notes/pics/mysql-rw-split.png b/notes/pics/mysql-rw-split.png new file mode 100644 index 000000000..e75620680 Binary files /dev/null and b/notes/pics/mysql-rw-split.png differ diff --git a/notes/pics/network-of-networks.png b/notes/pics/network-of-networks.png new file mode 100644 index 000000000..4212a73b1 Binary files /dev/null and b/notes/pics/network-of-networks.png differ diff --git a/notes/pics/next-key-locks-v2.png b/notes/pics/next-key-locks-v2.png new file mode 100644 index 000000000..9044a2ce6 Binary files /dev/null and b/notes/pics/next-key-locks-v2.png differ diff --git a/notes/pics/oauth-code-flow.png b/notes/pics/oauth-code-flow.png new file mode 100644 index 000000000..e760d1d4d Binary files /dev/null and b/notes/pics/oauth-code-flow.png differ diff --git a/notes/pics/observer-intent.png b/notes/pics/observer-intent.png new file mode 100644 index 000000000..2e1234704 Binary files /dev/null and b/notes/pics/observer-intent.png differ diff --git a/notes/pics/observer-run.png b/notes/pics/observer-run.png new file mode 100644 index 000000000..5653ecdbd Binary files /dev/null and b/notes/pics/observer-run.png differ diff --git a/notes/pics/os-kernels.png b/notes/pics/os-kernels.png new file mode 100644 index 000000000..a350ac84d Binary files /dev/null and b/notes/pics/os-kernels.png differ diff --git a/notes/pics/os-syscall.png b/notes/pics/os-syscall.png new file mode 100644 index 000000000..324f57414 Binary files /dev/null and b/notes/pics/os-syscall.png differ diff --git a/notes/pics/page-translate.png b/notes/pics/page-translate.png new file mode 100644 index 000000000..0422bb507 Binary files /dev/null and b/notes/pics/page-translate.png differ diff --git a/notes/pics/paxos-roles.png b/notes/pics/paxos-roles.png new file mode 100644 index 000000000..58f62c8f3 Binary files /dev/null and b/notes/pics/paxos-roles.png differ diff --git a/notes/pics/philosophers.png b/notes/pics/philosophers.png new file mode 100644 index 000000000..cac076a6a Binary files /dev/null and b/notes/pics/philosophers.png differ diff --git a/notes/pics/pipe.png b/notes/pics/pipe.png new file mode 100644 index 000000000..5bc7d4575 Binary files /dev/null and b/notes/pics/pipe.png differ diff --git a/notes/pics/process-concurrent.png b/notes/pics/process-concurrent.png new file mode 100644 index 000000000..4ce4b747e Binary files /dev/null and b/notes/pics/process-concurrent.png differ diff --git a/notes/pics/process-mlfq.png b/notes/pics/process-mlfq.png new file mode 100644 index 000000000..ca8112ef1 Binary files /dev/null and b/notes/pics/process-mlfq.png differ diff --git a/notes/pics/process-rr.png b/notes/pics/process-rr.png new file mode 100644 index 000000000..aba55c692 Binary files /dev/null and b/notes/pics/process-rr.png differ diff --git a/notes/pics/process-states.png b/notes/pics/process-states.png new file mode 100644 index 000000000..2e589e471 Binary files /dev/null and b/notes/pics/process-states.png differ diff --git a/notes/pics/process-threads.png b/notes/pics/process-threads.png new file mode 100644 index 000000000..262660d68 Binary files /dev/null and b/notes/pics/process-threads.png differ diff --git a/notes/pics/raft-election.png b/notes/pics/raft-election.png new file mode 100644 index 000000000..76c947924 Binary files /dev/null and b/notes/pics/raft-election.png differ diff --git a/notes/pics/raft-log.png b/notes/pics/raft-log.png new file mode 100644 index 000000000..a4f6dc535 Binary files /dev/null and b/notes/pics/raft-log.png differ diff --git a/notes/pics/raft-split.png b/notes/pics/raft-split.png new file mode 100644 index 000000000..b5c2bdd0f Binary files /dev/null and b/notes/pics/raft-split.png differ diff --git a/notes/pics/redis-aof-rewrite.png b/notes/pics/redis-aof-rewrite.png new file mode 100644 index 000000000..7eb917a9f Binary files /dev/null and b/notes/pics/redis-aof-rewrite.png differ diff --git a/notes/pics/redis-article-hash.png b/notes/pics/redis-article-hash.png new file mode 100644 index 000000000..3cf4e5a8c Binary files /dev/null and b/notes/pics/redis-article-hash.png differ diff --git a/notes/pics/redis-article-vote.png b/notes/pics/redis-article-vote.png new file mode 100644 index 000000000..3bc27d25d Binary files /dev/null and b/notes/pics/redis-article-vote.png differ diff --git a/notes/pics/redis-article-zsets.png b/notes/pics/redis-article-zsets.png new file mode 100644 index 000000000..7b5f55396 Binary files /dev/null and b/notes/pics/redis-article-zsets.png differ diff --git a/notes/pics/redis-event-loop.png b/notes/pics/redis-event-loop.png new file mode 100644 index 000000000..fb9e789cf Binary files /dev/null and b/notes/pics/redis-event-loop.png differ diff --git a/notes/pics/redis-file-event.png b/notes/pics/redis-file-event.png new file mode 100644 index 000000000..50091b87e Binary files /dev/null and b/notes/pics/redis-file-event.png differ diff --git a/notes/pics/redis-hash.png b/notes/pics/redis-hash.png new file mode 100644 index 000000000..2d4f7deb3 Binary files /dev/null and b/notes/pics/redis-hash.png differ diff --git a/notes/pics/redis-list.png b/notes/pics/redis-list.png new file mode 100644 index 000000000..76e313fa1 Binary files /dev/null and b/notes/pics/redis-list.png differ diff --git a/notes/pics/redis-replica-chain.png b/notes/pics/redis-replica-chain.png new file mode 100644 index 000000000..2a836574e Binary files /dev/null and b/notes/pics/redis-replica-chain.png differ diff --git a/notes/pics/redis-sentinel-failover.png b/notes/pics/redis-sentinel-failover.png new file mode 100644 index 000000000..d634440ee Binary files /dev/null and b/notes/pics/redis-sentinel-failover.png differ diff --git a/notes/pics/redis-set.png b/notes/pics/redis-set.png new file mode 100644 index 000000000..fa68c55c3 Binary files /dev/null and b/notes/pics/redis-set.png differ diff --git a/notes/pics/redis-skiplist.png b/notes/pics/redis-skiplist.png new file mode 100644 index 000000000..d02bb99f4 Binary files /dev/null and b/notes/pics/redis-skiplist.png differ diff --git a/notes/pics/redis-string.png b/notes/pics/redis-string.png new file mode 100644 index 000000000..9260ae15b Binary files /dev/null and b/notes/pics/redis-string.png differ diff --git a/notes/pics/redis-zset.png b/notes/pics/redis-zset.png new file mode 100644 index 000000000..e10c26f57 Binary files /dev/null and b/notes/pics/redis-zset.png differ diff --git a/notes/pics/second-chance.png b/notes/pics/second-chance.png new file mode 100644 index 000000000..f3ee602f8 Binary files /dev/null and b/notes/pics/second-chance.png differ diff --git a/notes/pics/segments.png b/notes/pics/segments.png new file mode 100644 index 000000000..86ceb1f35 Binary files /dev/null and b/notes/pics/segments.png differ diff --git a/notes/pics/shard-horizontal.png b/notes/pics/shard-horizontal.png new file mode 100644 index 000000000..9789e3ce3 Binary files /dev/null and b/notes/pics/shard-horizontal.png differ diff --git a/notes/pics/shard-vertical.png b/notes/pics/shard-vertical.png new file mode 100644 index 000000000..c505cf326 Binary files /dev/null and b/notes/pics/shard-vertical.png differ diff --git a/notes/pics/short-url.png b/notes/pics/short-url.png new file mode 100644 index 000000000..3fe81ca30 Binary files /dev/null and b/notes/pics/short-url.png differ diff --git a/notes/pics/snowflake.png b/notes/pics/snowflake.png new file mode 100644 index 000000000..6ea1c76f1 Binary files /dev/null and b/notes/pics/snowflake.png differ diff --git a/notes/pics/sql-flow.png b/notes/pics/sql-flow.png new file mode 100644 index 000000000..37a4aae6e Binary files /dev/null and b/notes/pics/sql-flow.png differ diff --git a/notes/pics/state-gumball.png b/notes/pics/state-gumball.png new file mode 100644 index 000000000..efee450df Binary files /dev/null and b/notes/pics/state-gumball.png differ diff --git a/notes/pics/static-link.png b/notes/pics/static-link.png new file mode 100644 index 000000000..e264f3b72 Binary files /dev/null and b/notes/pics/static-link.png differ diff --git a/notes/pics/template-recipe.png b/notes/pics/template-recipe.png new file mode 100644 index 000000000..8ccd74edc Binary files /dev/null and b/notes/pics/template-recipe.png differ diff --git a/notes/pics/tls-handshake.png b/notes/pics/tls-handshake.png new file mode 100644 index 000000000..0fe3e216a Binary files /dev/null and b/notes/pics/tls-handshake.png differ diff --git a/notes/pics/tool-call-text.png b/notes/pics/tool-call-text.png new file mode 100644 index 000000000..996b08d24 Binary files /dev/null and b/notes/pics/tool-call-text.png differ diff --git a/notes/pics/txn-dirty-read.png b/notes/pics/txn-dirty-read.png new file mode 100644 index 000000000..b354456d6 Binary files /dev/null and b/notes/pics/txn-dirty-read.png differ diff --git a/notes/pics/txn-flow.png b/notes/pics/txn-flow.png new file mode 100644 index 000000000..0a1a474aa Binary files /dev/null and b/notes/pics/txn-flow.png differ diff --git a/notes/pics/txn-lost-update.png b/notes/pics/txn-lost-update.png new file mode 100644 index 000000000..98d99d204 Binary files /dev/null and b/notes/pics/txn-lost-update.png differ diff --git a/notes/pics/txn-non-repeatable.png b/notes/pics/txn-non-repeatable.png new file mode 100644 index 000000000..268a77d16 Binary files /dev/null and b/notes/pics/txn-non-repeatable.png differ diff --git a/notes/pics/txn-phantom.png b/notes/pics/txn-phantom.png new file mode 100644 index 000000000..c0b528922 Binary files /dev/null and b/notes/pics/txn-phantom.png differ diff --git a/notes/pics/url-timeline.png b/notes/pics/url-timeline.png new file mode 100644 index 000000000..56a91a5d4 Binary files /dev/null and b/notes/pics/url-timeline.png differ diff --git a/notes/pics/vm-mapping.png b/notes/pics/vm-mapping.png new file mode 100644 index 000000000..eb004621d Binary files /dev/null and b/notes/pics/vm-mapping.png differ diff --git a/notes/pics/zero-copy.png b/notes/pics/zero-copy.png new file mode 100644 index 000000000..e55ec79e3 Binary files /dev/null and b/notes/pics/zero-copy.png differ diff --git "a/notes/\344\273\243\347\240\201\345\217\257\350\257\273\346\200\247.md" "b/notes/\344\273\243\347\240\201\345\217\257\350\257\273\346\200\247.md" index 1b1458d92..9d9618d1c 100644 --- "a/notes/\344\273\243\347\240\201\345\217\257\350\257\273\346\200\247.md" +++ "b/notes/\344\273\243\347\240\201\345\217\257\350\257\273\346\200\247.md" @@ -272,17 +272,17 @@ var setFirstEmptyInput = function(new_value) { ```java int findClostElement(int[] arr) { - int clostIdx; - int clostDist = Interger.MAX_VALUE; + int clostIdx = -1; + int clostDist = Integer.MAX_VALUE; for (int i = 0; i < arr.length; i++) { int x = ...; int y = ...; int z = ...; int value = x * y * z; - int dist = Math.sqrt(Math.pow(value, 2), Math.pow(arr[i], 2)); + int dist = (int) Math.sqrt(Math.pow(value, 2) + Math.pow(arr[i], 2)); if (dist < clostDist) { clostIdx = i; - clostDist = value; + clostDist = dist; } } return clostIdx; @@ -293,13 +293,13 @@ int findClostElement(int[] arr) { ```java public int findClostElement(int[] arr) { - int clostIdx; - int clostDist = Interger.MAX_VALUE; + int clostIdx = -1; + int clostDist = Integer.MAX_VALUE; for (int i = 0; i < arr.length; i++) { int dist = computDist(arr, i); if (dist < clostDist) { clostIdx = i; - clostDist = value; + clostDist = dist; } } return clostIdx; diff --git "a/notes/\345\210\206\345\270\203\345\274\217.md" "b/notes/\345\210\206\345\270\203\345\274\217.md" index 1d8020829..9446dd4f4 100644 --- "a/notes/\345\210\206\345\270\203\345\274\217.md" +++ "b/notes/\345\210\206\345\270\203\345\274\217.md" @@ -33,6 +33,9 @@ * [服务发现](#服务发现) * [RPC 与 HTTP](#rpc-与-http) * [超时与重试](#超时与重试) + * [八、分布式 ID](#八分布式-id) + * [雪花算法](#雪花算法) + * [九、幂等](#九幂等) * [参考](#参考) @@ -94,7 +97,7 @@ Redis 8.4 新增了 `DELEX lock_key IFEQ unique_value` 指令,可以直接原 RedLock 依赖各个节点的时钟基本同步,并且无法应对进程暂停(例如 GC)导致锁过期后客户端仍然认为自己持有锁的情况,因此存在争议。更可靠的做法是让锁服务每次加锁时返回一个单调递增的栅栏令牌(Fencing Token),客户端访问资源时带上令牌,资源拒绝令牌比已处理过的更小的请求。 -

+

### Zookeeper 的有序节点 @@ -215,7 +218,7 @@ TCC(Try-Confirm-Cancel)是在业务层面实现的两阶段提交,每个 Saga 将一个分布式事务拆分为多个本地事务,每个本地事务直接提交,并且都有一个对应的补偿操作。依次执行各个本地事务,如果某一个失败,就逆序执行前面已经提交的本地事务的补偿操作。 -

+

Saga 没有预留资源的 Try 阶段,中间状态对其它事务可见,因此没有隔离性。它适合流程长、无法长时间锁定资源的业务,正向操作和补偿操作同样需要实现幂等。 @@ -233,7 +236,7 @@ Saga 没有预留资源的 Try 阶段,中间状态对其它事务可见,因 RocketMQ 的事务消息把本地消息表的工作交给了消息队列:生产者先发送一条对消费者不可见的半消息,再执行本地事务,然后根据执行结果通知 Broker 提交或者回滚这条消息。如果 Broker 长时间没有收到通知,会主动回查生产者的本地事务状态。 -

+

## 三、CAP @@ -306,7 +309,7 @@ ACID 要求强一致性,通常运用在传统的数据库系统上。而 BASE 一个节点可以同时担任多种角色。 -

+

### 执行过程 @@ -343,7 +346,7 @@ Acceptor 接受一个提议之后,会将该提议发送给所有的 Learner。 - A 发送 Prepare(2),X 和 Y 做出承诺并响应。A 得到大多数响应之后发送 Accept(2, 8),X 和 Y 接受该提议,此时值 8 已经被选定; - 之后 B 发送 Prepare(4),它收到的大多数响应中至少有一个来自 X 或 Y,响应中包含已经接受过的提议 [2, 8],因此 B 只能发送 Accept(4, 8),而不能使用自己的提议值,从而保证了选定的值不会改变。 -

+

### 约束条件 @@ -371,51 +374,32 @@ Raft 也是分布式共识算法,相比于 Paxos 更容易理解和实现。 Leader 会周期性的发送心跳包给 Follower。每个 Follower 都设置了一个随机的竞选超时时间,一般为 150ms\~300ms,如果在这个时间内没有收到 Leader 的心跳包,就会变成 Candidate,将任期号加 1 并给自己投一票,进入竞选阶段。 -- 下图展示一个分布式系统的最初阶段,此时只有 Follower 没有 Leader。Node A 等待一个随机的竞选超时时间之后,没收到 Leader 发来的心跳包,因此进入竞选阶段。 - -

- -- 此时 Node A 发送投票请求给其它所有节点。 - -

+- 系统刚启动时只有 Follower 没有 Leader。Node A 的随机竞选超时最短,到期时没收到 Leader 发来的心跳包,因此进入竞选阶段,发送投票请求给其它所有节点。 - 每个节点在一个任期内最多只能投一票,先到先得,并且只会投给日志至少和自己一样新的 Candidate,这保证了新的 Leader 一定包含所有已提交的日志。如果 Candidate 获得超过一半节点的选票,就会变成 Leader。 -

- - 之后 Leader 会周期性地发送心跳包给 Follower,Follower 接收到心跳包,会重新开始计时。 -

+

### 多个 Candidate 竞选 - 如果有多个 Follower 同时成为 Candidate,选票可能会被瓜分,导致没有 Candidate 获得超过一半的选票,那么等待竞选超时之后进入下一个任期重新开始投票。例如下图中 Node B 和 Node D 都获得两票,需要重新开始投票。 -

- - 由于每个节点设置的随机竞选超时时间不同,因此下一次再次出现多个 Candidate 并获得同样票数的概率很低。 -

+

- 如果 Candidate 在竞选过程中收到了任期号不小于自己的 Leader 发来的心跳包,就会承认该 Leader 并变回 Follower。 ### 日志复制 - 来自客户端的修改都会被传入 Leader。注意该修改还未被提交,只是写入日志中。 - -

- - Leader 会把修改复制到所有 Follower。 - -

- - Leader 会等待大多数的节点都写入了该日志,然后才将修改提交,并向客户端返回结果。 - -

- - 此时 Leader 会在之后的心跳包中通知所有 Follower 让它们也提交修改,此时所有节点的值达成一致。 -

+

如果 Follower 的日志和 Leader 不一致,Leader 会找到两者最后一致的位置,然后用自己的日志覆盖 Follower 在该位置之后的日志。 @@ -516,6 +500,71 @@ HTTP + JSON 的优势在于通用:浏览器和各种语言都能直接调用 - 因此只有幂等的接口才能自动重试,例如查询;扣库存这类写操作要带上请求 ID,由服务方去重,否则重试会扣减两次; - 调用链较长时,下游的超时时间应该比上游短。gRPC 会把截止时间(deadline)随请求传给服务方,超时后调用方收到 DEADLINE_EXCEEDED,服务方也可以检查调用是否已经超时,从而停止处理。 +## 八、分布式 ID + +单库时用数据库的自增主键就能生成 ID,分库分表之后,各个库的自增序列会重复,需要一个全局唯一的 ID。一般有以下要求: + +- 全局唯一; +- 大体按时间递增,作为 InnoDB 的主键时能顺序插入; +- 生成快、可用性高,不能成为瓶颈; +- 有时还要求不能从 ID 推测出业务量,例如订单号不能是连续的数字。 + +常用的方案如下: + +| 方案 | 做法 | 缺点 | +| --- | --- | --- | +| UUID | 本地生成 128 位随机数 | 无序,作主键时随机插入、页分裂多;36 个字符太长 | +| 数据库号段 | 用一张表记录当前最大 ID,每次取一段(例如 1000 个)放在内存中慢慢用 | 依赖数据库,服务重启会浪费没用完的号段 | +| Redis INCR | 用 INCR 得到递增的整数 | 依赖 Redis 的可用性和持久化,宕机后可能重复 | +| 雪花算法 | 本地用时间戳、机器 ID 和序号拼成 64 位整数 | 依赖时钟,需要分配机器 ID | + +在本机的 MySQL 8.0 上分别以自增整数和 UUID() 为主键插入 100 万行:自增主键用时 3.4 秒、数据 133 MB;UUID 主键用时 5.1 秒、数据 164 MB。这是因为 UUID 的值是无序的,每次都插入到 B+ 树中间的随机位置,频繁的页分裂让页的填充率变低,二级索引中保存的主键也更长。 + +### 雪花算法 + +雪花算法(Snowflake)把 64 位整数分成四部分: + +

+ +```java +public synchronized long nextId() { + long now = System.currentTimeMillis(); + if (now < lastTime) { // 时钟回拨 + throw new IllegalStateException("clock moved backwards"); + } + if (now == lastTime) { + seq = (seq + 1) & 4095; // 同一毫秒内序号加 1 + if (seq == 0) { // 4096 个用完,等到下一毫秒 + while ((now = System.currentTimeMillis()) <= lastTime) { } + } + } else { + seq = 0; + } + lastTime = now; + return ((now - EPOCH) << 22) | (workerId << 12) | seq; +} +``` + +在本机用 8 个线程共生成 400 万个 ID,耗时 1.2 秒,全部不重复,每个线程得到的 ID 都是递增的;去掉“序号用完就等到下一毫秒”这一步,400 万个 ID 中只有 241 万个不重复。 + +实际使用时还要解决两个问题: + +- 机器 ID:每个实例的机器 ID 不能相同,可以在启动时从 ZooKeeper、数据库或配置中心领取; +- 时钟回拨:服务器校时可能让时钟倒退,回拨较小时可以等待时钟追上,较大时报错,或者像美团的 Leaf 那样在启动时检查本机时间与其它节点是否一致。 + +## 九、幂等 + +幂等指的是同一个操作执行一次和执行多次的效果相同。分布式系统中重复的请求很常见:调用超时后重试、用户重复点击、消息队列重复投递,都会让同一个操作执行多次。查询和删除天然幂等,新增和扣减不是,例如支付回调被调用两次,订单就可能被处理两次。 + +实现方法: + +- 唯一索引:为每个请求生成唯一的请求 ID,在去重表的主键或唯一索引上插入,重复的请求插入失败(ERROR 1062 Duplicate entry)就直接返回之前的结果,去重表和业务数据在同一个本地事务中写入; +- 状态机:更新时带上前置状态,例如 UPDATE orders SET status = 'PAID' WHERE id = 1024 AND status = 'UNPAID',第一次影响 1 行,重复执行影响 0 行; +- 版本号:更新时带上读到的版本号,版本号不匹配就不更新,即乐观锁; +- Token:提交前先从服务端获取一个 Token 存入 Redis,提交时用 DEL 删除,返回 1 才处理,重复提交时返回 0。 + +需要注意的是,“先查询是否处理过、再处理”分成两步时,两个并发的重复请求可能同时查到“未处理”。判断和处理必须是原子的,要么依靠数据库的唯一索引或条件更新,要么把判断和写入放在同一个 Lua 脚本中。 + ## 参考 - [Apache Dubbo: Architecture](https://dubbo.apache.org/docs/v2.7/user/preface/architecture/) @@ -527,16 +576,16 @@ HTTP + JSON 的优势在于通用:浏览器和各种语言都能直接调用 - [Distributed locks with Redis](https://redis.io/topics/distlock) - [How to do distributed locking](https://martin.kleppmann.com/2016/02/08/how-to-do-distributed-locking.html) - [Locks and synchronizers - Redisson](https://redisson.pro/docs/data-and-services/locks-and-synchronizers/) -- [深度剖析 Seata TCC 模式](https://www.seata.io/zh-cn/blog/seata-tcc/) +- [深度剖析 Seata TCC 模式](https://seata.apache.org/zh-cn/blog/seata-tcc/) - [事务消息 | RocketMQ](https://rocketmq.apache.org/zh/docs/featureBehavior/04transactionmessage/) - [An Illustrated Proof of the CAP Theorem](https://mwhittaker.github.io/blog/an_illustrated_proof_of_the_cap_theorem/) - [浅谈分布式锁](http://www.linkedkeeper.com/detail/blog.action?bid=1023) -- [基于 Zookeeper 的分布式锁](http://www.dengshenyu.com/java/%E5%88%86%E5%B8%83%E5%BC%8F%E7%B3%BB%E7%BB%9F/2017/10/23/zookeeper-distributed-lock.html) +- [基于 Zookeeper 的分布式锁](https://web.archive.org/web/20221129202405/http://www.dengshenyu.com/java/%E5%88%86%E5%B8%83%E5%BC%8F%E7%B3%BB%E7%BB%9F/2017/10/23/zookeeper-distributed-lock.html) - [聊聊分布式事务,再说说解决方案](https://www.cnblogs.com/savorboard/p/distributed-system-transaction-consistency.html) - [分布式系统的事务处理](https://coolshell.cn/articles/10910.html) - [深入理解分布式事务](https://juejin.im/entry/577c6f220a2b5800573492be) -- [What is CAP theorem in distributed database system?](http://www.colooshiki.com/index.php/2017/04/20/what-is-cap-theorem-in-distributed-database-system/) +- [What is CAP theorem in distributed database system?](https://web.archive.org/web/20170428094507/http://www.colooshiki.com/index.php/2017/04/20/what-is-cap-theorem-in-distributed-database-system/) - [Paxos Made Simple](https://lamport.azurewebsites.net/pubs/paxos-simple.pdf) -- [NEAT ALGORITHMS - PAXOS](http://harry.me/blog/2014/12/27/neat-algorithms-paxos/) +- [NEAT ALGORITHMS - PAXOS](https://web.archive.org/web/20260307090655/http://harry.me/blog/2014/12/27/neat-algorithms-paxos/) - [In Search of an Understandable Consensus Algorithm](https://raft.github.io/raft.pdf) - +- [Leaf——美团点评分布式 ID 生成系统](https://tech.meituan.com/2017/04/21/mt-leaf.html) diff --git "a/notes/\345\244\247\346\250\241\345\236\213\345\272\224\347\224\250.md" "b/notes/\345\244\247\346\250\241\345\236\213\345\272\224\347\224\250.md" index 226b484bb..4b1540050 100644 --- "a/notes/\345\244\247\346\250\241\345\236\213\345\272\224\347\224\250.md" +++ "b/notes/\345\244\247\346\250\241\345\236\213\345\272\224\347\224\250.md" @@ -35,6 +35,8 @@ * [MCP](#mcp) * [Skills](#skills) * [多 Agent](#多-agent) + * [AI 编程助手](#ai-编程助手) + * [Harness](#harness) * [开发框架](#开发框架) * [可靠性与评测](#可靠性与评测) * [五、工程实践](#五工程实践) @@ -46,6 +48,13 @@ +本篇面向准备 AI 应用、Agent 开发岗位,但之前没有接触过大模型开发的程序员。建议的阅读顺序: + +1. 先读“Agent 是什么”和“工具调用”,理解两件最基本的事:模型只会输出文本,调用工具、读写数据都是应用代码做的;模型不保存状态,每次调用都要把需要的信息重新发过去; +2. 再读“Agent 循环”和“上下文工程”,看懂一个 Agent 每一步发送了什么、为什么步数越多越贵; +3. 然后按需要读检索增强生成、记忆、MCP、Skills 和多 Agent,它们都是在这两件基本事实之上解决具体问题; +4. 第一部分的模型原理(注意力、KV Cache、训练)在面试中常被追问,可以最后补。 + ## 一、大模型基础 ### Token 与分词 @@ -167,6 +176,24 @@ KV Cache 是用显存换计算。每个 Token 要在每一层缓存 K 和 V 两 SFT 之后还要做偏好对齐,是因为 SFT 只告诉模型“这个回答是对的”,偏好数据告诉模型“两个回答中哪个更好”。有用、安全这类目标很难写出标准答案,但比较两个回答的好坏要容易得多。 +偏好对齐常用的三种算法: + +- PPO(RLHF 中使用的强化学习算法):模型对提示词生成回答,奖励模型打分,再用打分更新模型。训练时要同时加载 4 个模型:正在训练的策略模型、估计每一步价值的价值模型(Critic)、打分的奖励模型,以及冻结的参考模型;参考模型用来计算 KL 散度,限制新模型偏离原模型太远,防止它找到奖励模型的漏洞,生成得分高但没有意义的回答; +- DPO:不训练奖励模型,也不在训练中生成回答,直接用标注好的偏好对 (提示词, 较好的回答, 较差的回答) 训练,只需要策略模型和参考模型; +- GRPO(DeepSeekMath 提出,DeepSeek-R1 使用):去掉了价值模型。对同一个问题生成一组回答,用组内的平均分作为基准:比平均分高的回答得到正的优势,低的得到负的优势,省去了训练价值模型的显存和计算。 + +DPO 的损失函数如下,其中 yw、yl 分别是较好和较差的回答,πref 是参考模型,β 控制偏离参考模型的程度: + +```text +loss = -log σ( β × [ (log π(y_w|x) - log π_ref(y_w|x)) - (log π(y_l|x) - log π_ref(y_l|x)) ] ) +``` + +训练开始时模型与参考模型相同,括号内为 0,损失是 log 2 ≈ 0.693。取 β = 0.1,如果训练后较好回答的对数概率比参考模型高了 2,较差回答的低了 1,括号内为 3,损失降为 -log σ(0.3) ≈ 0.554。也就是说,DPO 在拉高较好回答概率的同时压低较差回答的概率,是一个二分类问题。 + +GRPO 的优势计算举例:对一道数学题生成 4 个回答,答对得 1 分、答错得 0 分,得分为 [1, 0, 0, 1],平均分 0.5、标准差 0.5,每个回答的优势 (得分 - 平均分) / 标准差 为 [1, -1, -1, 1],答对的回答被强化,答错的被抑制。如果 4 个回答全对或全错,优势都是 0,这道题对训练没有贡献,所以题目的难度要适中。数学、代码这类能自动判断对错的任务可以直接用规则打分,不需要奖励模型。 + +三者的选择:DPO 实现简单、训练稳定,适合已有偏好数据的对齐;PPO 和 GRPO 在训练中生成新的回答,能探索出训练数据之外的更好回答,推理能力的训练通常使用 GRPO 这类强化学习方法。 + ### 微调 微调指的是用特定任务的数据继续训练模型。全量微调要更新所有参数,7B 模型的参数、梯度和优化器状态加起来需要上百 GB 显存。 @@ -291,6 +318,8 @@ RAG、微调和提示词解决的是不同的问题: 需要注意的是,截断历史时工具调用和它的结果要成对保留或者成对删除。只剩下结果而缺少对应的调用时,很多接口会直接报错。 +闲聊、客服这类前后轮关系不大的对话,用滑动窗口就够了,简单且不需要额外调用模型;Agent 执行长任务时,早期做出的决定和用户提出的约束一直有用,适合摘要加外置。压缩有没有丢掉关键信息,可以准备一组依赖早期对话才能回答的问题(例如“用户一开始要求的输出格式是什么”),分别用压缩前和压缩后的上下文回答,比较正确率。 + ## 三、检索增强生成 检索增强生成(Retrieval-Augmented Generation, RAG)指的是先从知识库中检索与问题相关的资料,再把资料和问题一起交给模型生成回答。它用于解决模型不了解私有数据和最新数据的问题,也能减少幻觉,回答还可以附上来源。 @@ -340,6 +369,8 @@ c = “今天股价上涨了” (0.6, -0.8) cos(a, c) = 0.48 - 0.48 = 0 a 和 b 几乎没有相同的字,相似度却很高,这正是向量检索相比关键词检索的优势。向量通常会归一化为长度 1,这时余弦相似度等于点积,计算更快。 +用真实的模型计算,结论相同但数值没有这么极端:用 bge-small-zh-v1.5(512 维)编码这三句话,“怎么申请年假”与“休假的流程是什么”的余弦相似度为 0.603,与“今天股价上涨了”为 0.194。实际系统中不同句子的相似度大多落在一个不太宽的区间里,判断是否相关要看排名和阈值,而不是期望不相关的结果接近 0。 + 检索时把问题也转为向量,找出与它最相似的 K 个切片,称为 Top-K 检索。问题和切片必须使用同一个 Embedding 模型,更换模型后所有切片都要重新计算向量。 ### 向量索引 @@ -367,6 +398,8 @@ a 和 b 几乎没有相同的字,相似度却很高,这正是向量检索相 Elasticsearch 中 BM25 的参数 k1 和 b 默认为 1.2 和 0.75,分别控制词频的饱和速度和文档长度的影响程度。 +用同一个例子对比两种检索。查询“错误码 E1024 是什么意思”,候选文档是“错误码 E1024:库存不足”和“错误码 E1025:支付超时”:bge-small-zh 给出的相似度分别为 0.813 和 0.795,几乎分不开;BM25 中“错误码”出现在每篇文档里,逆文档频率很低,E1024 只出现在一篇文档中,权重高得多。在这两篇加一篇“常见错误码说明”组成的小语料上,按 k1 = 1.2、b = 0.75 计算,第一篇得 1.114 分,第二篇只有 0.134 分。 + 因此通常两路同时召回,再合并结果。两路的分数不能直接相加,BM25 的分数没有上限,余弦相似度在 -1 到 1 之间。倒数排名融合(Reciprocal Rank Fusion, RRF)只看排名:文档的得分是它在各路结果中排名的倒数之和,即 Σ 1 / (k + rank),k 通常取 60。例如: | 文档 | 向量检索排名 | BM25 排名 | RRF 得分 | @@ -470,20 +503,20 @@ Agent(智能体)指的是让大模型通过调用工具来完成任务的系 可见工具调用本质上仍然是生成文本,所以模型可能写错参数、调用不存在的工具,应用必须先校验再执行。很多服务提供严格模式,用约束解码保证参数符合 Schema。 -以 OpenAI 兼容的接口为例,请求中这样描述工具: +以 OpenAI 兼容的接口为例,用户问“订单 1024 到哪了”,请求中这样描述查询订单的工具(省略了查询物流的 get_logistics): ```json "tools": [{ "type": "function", "function": { - "name": "get_weather", - "description": "查询城市当天的天气。用户询问天气、气温时使用", + "name": "get_order", + "description": "按订单号查询订单状态和运单号。用户询问订单、发货情况时使用", "parameters": { "type": "object", "properties": { - "city": {"type": "string", "description": "城市名,例如 杭州"} + "order_id": {"type": "string", "description": "订单号,例如 1024"} }, - "required": ["city"] + "required": ["order_id"] } } }] @@ -494,16 +527,22 @@ Agent(智能体)指的是让大模型通过调用工具来完成任务的系 ```json {"role": "assistant", "tool_calls": [{ "id": "call_1", "type": "function", - "function": {"name": "get_weather", "arguments": "{\"city\": \"杭州\"}"} + "function": {"name": "get_order", "arguments": "{\"order_id\": \"1024\"}"} }]} ``` 应用执行函数后,用 tool 角色的消息把结果发回。一次回复中可能包含多个调用,tool_call_id 用于对应是哪一次调用: ```json -{"role": "tool", "tool_call_id": "call_1", "content": "{\"weather\": \"晴\", \"temp\": 26}"} +{"role": "tool", "tool_call_id": "call_1", "content": "{\"status\": \"已发货\", \"tracking_no\": \"SF1234567\"}"} ``` +这些结构化的字段只存在于接口中。在本机用 Qwen2.5-7B-Instruct 和 Hugging Face Transformers 运行“订单 1024 到哪了”这个例子,可以直接看到模型收到和输出的原始文本: + +

+ +工具定义被拼进了系统消息,模型输出的是包在 <tool_call> 标签里的一段 JSON,应用用正则把它解析出来;工具结果则被包在 <tool_response> 中,作为下一条消息发回。不同模型的标签不同,但原理相同,OpenAI 兼容接口中的 tool_calls 字段就是推理服务从这段文本中解析出来的。 + 工具结果使用单独的角色,模型能区分这是工具返回的数据而不是用户的指令,但这并不能防止结果中藏有恶意指令,见下文的安全。 模型只能根据工具的名称、描述和参数说明来决定是否调用、怎么填参数,所以工具的设计直接影响调用的准确率: @@ -513,6 +552,8 @@ Agent(智能体)指的是让大模型通过调用工具来完成任务的系 - 返回结果要精简,只返回模型需要的字段,大段的原始数据会占用上下文; - 出错时返回能指导模型修正的信息,例如“日期格式应为 2026-01-01”,而不是只返回“参数错误”。 +描述写得是否清楚,对结果的影响很大。在上面的例子中,系统提示词只写“你是电商客服助手,回答要简短”时,7B 模型查到运单号就直接回答“已发货,运单号是 SF1234567”,没有继续查物流;采样运行 10 次,1 次也没有答出包裹的位置。在系统提示词中写明“用户问包裹到哪了时,先查订单拿到运单号,再查物流,告诉用户当前位置和预计送达时间”后,10 次全部依次调用了两个工具,回答“您的包裹目前位于杭州转运中心,预计明天送达”。同样的提示词换成 3B 模型,20 次都只调用了一个工具,可见模型能力不足时,提示词也弥补不了。 + 工具很多时,全部的工具定义会占用大量上下文,模型也更容易选错。可以只加载与当前任务相关的工具,例如先根据问题检索出最相关的十几个工具,或者把工具分组交给不同的子 Agent。 ### Agent 循环 @@ -599,6 +640,14 @@ ReAct 每一步都根据上一步的结果决定下一步,适合需要边做 - 写入:提取出的每条事实连同它的向量、用户 ID 和时间一起保存。新事实与已有的记忆冲突时,例如“用户住在杭州”和“用户搬到了上海”,先检索出相似的旧记忆,以时间较新的为准更新或者删除; - 读取:新的请求到来时,用当前问题检索这个用户最相关的几条记忆,放进系统提示词,而不是把所有记忆都放进去。 +长期记忆还需要遗忘,否则过时和无用的记忆越积越多,检索时会混入噪声: + +- 给每条记忆记录写入时间和最近被用到的时间,检索时把相似度和时间衰减结合起来排序,很久没用到的记忆排在后面; +- 定期清理长期没有被用到、或者已经被新事实覆盖的记忆; +- 可以设置有效期的信息(例如“用户这周在出差”)在写入时就带上过期时间。 + +短期记忆与上下文工程的关系:短期记忆决定保存哪些对话,上下文工程决定每次调用时从中取出哪些、怎样压缩后放进窗口。 + 需要注意的是,记忆中存放的是用户的个人信息,应该允许用户查看、修改和删除。 ### MCP @@ -643,7 +692,9 @@ MCP 与相关概念的区别: - 工具调用是模型这一侧的能力,模型根据工具描述给出调用;MCP 是应用与工具之间的协议,解决工具如何被发现和调用。两者配合使用:主机把从服务端获取的工具转换为工具定义交给模型,模型给出调用后,再通过 MCP 发给服务端执行; - 普通的 HTTP 接口也能封装成工具,但每个接口的认证方式、参数格式和文档各不相同,需要逐个适配;MCP 统一了发现和调用的方式,工具描述本身就是写给模型看的。 -MCP 也有代价:每个服务端的工具定义都会进入上下文,接入的服务端多了会占用大量 Token;第三方服务端的工具描述和返回结果可能包含恶意指令,应该像安装软件一样只使用可信的服务端。MCP 规范仍在快速演进,细节以官方最新版本为准。 +MCP 也有代价。每个服务端的工具定义都会进入上下文,Anthropic 的文档中举的例子是同时接入 GitHub、Slack、Sentry、Grafana、Splunk 五个服务端,工具定义就占约 5.5 万个 Token;可用的工具超过 30~50 个后,模型选对工具的能力也会明显下降。解决方法是按需加载:上下文中只放一个搜索工具和最常用的几个工具,模型先搜索,再把找到的工具的完整定义加入上下文;也可以由应用先根据问题检索出相关的工具,只把这几个交给模型。 + +另外,第三方服务端的工具描述和返回结果可能包含恶意指令,应该像安装软件一样只使用可信的服务端。MCP 规范仍在快速演进,细节以官方最新版本为准。 ### Skills @@ -665,6 +716,29 @@ Skill 的核心是渐进式加载: - MCP 是连接工具和数据的协议,解决工具怎么接入; - Skill 提供做事的方法,告诉 Agent 完成某类任务的步骤和规范,执行时仍然需要调用工具。 +例如一个生成周报的 Skill 的目录: + +```text +weekly-report/ +├── SKILL.md 名称、描述和操作步骤 +├── template.md 周报模板,按需读取 +└── scripts/ + └── collect.py 统计本周合入的 PR,Agent 运行它,只有输出进入上下文 +``` + +```markdown +--- +name: weekly-report +description: 按团队模板生成周报。用户要求写周报、总结本周工作时使用。 +--- + +1. 运行 scripts/collect.py,得到本周合入的 PR 列表; +2. 按 template.md 的格式,把 PR 归入“完成”“进行中”“风险”三部分; +3. 每条不超过一句话,链接放在末尾。 +``` + +name 只能包含小写字母、数字和连字符,最长 64 个字符;description 最长 1024 个字符,要同时写清楚做什么和什么时候用,Agent 就是根据它判断是否加载这个 Skill。需要接入外部系统、要求权限控制的能力(例如查询公司的工单系统)适合做成 MCP 服务端;告诉 Agent 怎样组合已有工具完成任务的流程和规范,适合写成 Skill。Skill 中可以包含脚本,等同于让 Agent 执行代码,只应该使用可信来源的 Skill。 + ### 多 Agent 复杂任务可以交给多个 Agent 协作完成。常用的结构是主从模式:主 Agent 负责拆分任务和汇总结果,把子任务分派给子 Agent 并行执行。 @@ -682,6 +756,57 @@ Skill 的核心是渐进式加载: 因此多 Agent 适合可以拆成多个独立部分、并行处理的任务,例如同时调研多个主题。子任务之间需要频繁共享上下文的任务,例如修改同一份代码,更适合由单个 Agent 完成。 +多个 Agent 同时修改共享资源时,与多线程的问题相同,处理方法也类似: + +- 隔离:每个 Agent 在自己的工作目录中修改代码,例如为每个 Agent 创建一个 git worktree,完成后再像合并分支一样合并,有冲突时由主 Agent 或人工解决; +- 分区:拆分任务时就划清每个 Agent 负责的文件或数据范围,互不重叠; +- 加锁或乐观并发:修改数据库时使用行锁或版本号,修改文件前检查文件自读取后是否被改过,被改过就重新读取再修改; +- 共享状态显式传递:Agent 之间不共享上下文,需要的信息由主 Agent 在分派任务时写进子任务的说明,子 Agent 的结论写入文件或数据库,而不是依赖对方“记得”。 + +### AI 编程助手 + +Claude Code、Cursor、Codex 这类 AI 编程助手是目前最常用的 Agent,原理与前面的 Agent 循环相同,只是工具换成了读写文件、搜索代码和执行命令: + +

+ +以 Claude Code 为例,官方文档把它的工作过程描述为收集上下文、执行操作、验证结果三个阶段,内置的工具分为文件操作、搜索、执行命令、网络访问和代码理解几类。几个关键的设计: + +- 项目约定:项目根目录的 CLAUDE.md 在每次会话开始时放入上下文,写入构建和测试命令、代码规范等每次都需要的信息,官方建议每个文件不超过 200 行,内容越长越占上下文,也越难被遵守; +- 上下文管理:接近上限时自动把对话压缩成摘要,早期对话中的细节可能丢失,所以重要的规则应该写进 CLAUDE.md,而不是只在对话中说一次;子 Agent 在自己的上下文中工作,只把结论返回; +- 安全:修改文件前保存快照,可以撤销;执行命令、修改文件前按权限模式决定是否请求确认。对数据库、线上接口这类外部系统的操作无法撤销,需要用权限加以限制。 + +用好这类工具的方法与带一个新同事类似: + +- 给出可以验证的目标,例如“让 OrderServiceTest 通过”,而不是“优化一下代码”,Agent 才能自己运行测试判断是否完成; +- 先让它阅读代码、给出方案,确认后再修改,避免方向一开始就错了; +- 任务拆小,一次只改一个功能,便于审查;生成的代码同样要做代码审查和测试,不能因为是 AI 写的就跳过; +- 把反复纠正的要求写进 CLAUDE.md 这类项目约定文件,而不是每次在对话中重复。 + +### Harness + +Agent 由模型和 Harness 两部分组成。Harness 指的是模型之外的所有代码、配置和执行逻辑:Agent 循环、系统提示词、工具及其描述、上下文压缩、记忆、沙箱与权限、子 Agent 的调度,以及在固定时机执行的钩子(例如每次修改文件后自动格式化)。前面不到二十行的 Agent 循环就是一个最简单的 Harness;Claude Code、Codex 是功能完整的 Harness,可以换用不同的模型。MCP 和 Skill 也是 Harness 的组成部分,前者负责接入工具,后者负责按需提供做事的方法。 + +模型决定了能力的上限,Harness 决定了实际能发挥出多少。前面的实验中,模型不变,只在系统提示词中写清楚查询的步骤,成功率就从 0/10 变成了 10/10。围绕 Agent 设计和改进 Harness 的工作称为 Harness 工程(Harness Engineering),这个说法在 2026 年初开始流行,核心是两类控制: + +- 引导:在 Agent 动手之前给出方向,例如 CLAUDE.md 中的规范、架构文档和 Skill; +- 反馈:在 Agent 动手之后检查结果,例如编译、测试、lint、架构检查,以及用另一个模型审查。 + +以“Controller 只能调用 Service”这条分层规范为例: + +

+ +这条规范只写在 CLAUDE.md 中时,模型大多数时候会遵守,但无法保证。再加一条用 ArchUnit 写的架构测试,违反时测试失败,错误信息写明了违反哪条规则、在哪一行,Agent 读到后就能自己修正,不需要人逐行审查。编译、测试这类确定的检查快、便宜、结果可靠,应该优先使用;模型审查能发现规则写不出来的问题,但更慢,结论也不稳定。同一个问题反复出现时,应该补一条规范或一个检查,而不是每次在对话中纠正。 + +任务大到一个上下文窗口装不下时,Harness 还要负责多次会话之间的交接。Anthropic 介绍过一种做法:第一次会话只做准备,把需求拆成功能清单写入 JSON 文件,每项带测试步骤和 passes 字段,初始全部为 false,同时写好启动脚本并提交到 git;之后的每次会话先读进度文件和 git log,启动应用做一次冒烟测试,然后只挑一个未通过的功能实现,端到端测试通过后才把 passes 改为 true,最后提交代码、更新进度文件。清单中的一项例如: + +```json +{"id": 12, "description": "订单列表可以按状态筛选", + "steps": ["打开 /orders", "选择状态“已发货”", "列表中只显示已发货的订单"], + "passes": false} +``` + +这些设计分别针对长任务中的常见问题:新会话不知道之前做了什么,靠进度文件和 git log 交接;一次做太多、上下文用完时留下半成品,靠每次只做一个功能;没有测试就宣布完成,靠功能清单和端到端测试。清单用 JSON 而不是 Markdown,是因为模型不容易随意改写 JSON 的结构;规定只能修改 passes 字段,是为了防止 Agent 删掉测试来“完成”任务。 + ### 开发框架 上面的循环、工具定义和消息管理在每个项目中都要重复编写,LangChain、LangGraph、Spring AI 等框架把它们封装了起来: @@ -695,6 +820,12 @@ LangGraph 把 Agent 表示为一张状态图:节点是一次模型调用或者 框架减少了重复代码,但也隐藏了细节,排查问题时仍然需要查看实际发送给模型的消息。 +选择时可以参考: + +- Java 项目优先考虑 Spring AI 或 LangChain4j,与现有的 Spring 体系集成;Python 项目常用 LangChain、LangGraph; +- 流程固定、需要暂停等待人工审批或者从中断处恢复时,LangGraph 这类状态图框架更合适; +- 逻辑简单时,直接调用模型的接口写一个循环往往更清楚,前面的 Agent 循环不到二十行。 + ### 可靠性与评测 Agent 的每一步都可能出错,需要在代码中兜底,而不是依赖模型自觉: @@ -722,6 +853,8 @@ tool 退款申请已提交,单号 R88 - 效率:完成任务所需的步数、耗时和 Token 消耗; - 线上指标:转人工率、用户满意度。 +由于采样的随机性,同一个任务运行多次,结果可能不同,只运行一次的成功率并不可靠。τ-bench 提出用 pass^k 衡量稳定性:同一个任务连续 k 次都成功的概率。它与常见的 pass@k(k 次中至少成功一次)正好相反,假设单次成功率为 90%,pass@8 接近 100%,pass^8 只有 0.98 ≈ 43%。面向用户的 Agent 每次都要做对,更应该关注 pass^k。该论文中 GPT-4o 在零售场景的任务上成功率不到 50%,pass^8 不到 25%。 + 每次修改提示词、工具或者模型,都在同一批任务上回归,并记录每次运行的完整轨迹,出错时才能复现和定位。 ## 五、工程实践 @@ -772,6 +905,7 @@ static void stream(HttpClient client, HttpRequest request, Consumer onDa - Nginx 等反向代理默认会缓冲上游的响应,流式输出变成了一次性输出,需要关闭缓冲,例如在响应头中加上 X-Accel-Buffering: no; - 网关和负载均衡的读超时要大于最长的生成时间; - 用户关闭页面后要及时取消对模型的请求,否则仍在消耗 Token; +- 网络抖动导致断线时,模型的生成无法从中途重新开始。需要续传时,让生成任务与连接解耦:生成的内容按会话和事件编号写入 Redis 等缓存,客户端带着 Last-Event-ID 重连后,先从缓存中补发之后的事件,再继续推送新的内容,超时没有重连再取消生成; - 工具调用的参数也是分片段流式返回的,需要按调用的序号拼接,生成结束后才能解析出完整的 JSON。 ### 延迟与成本 @@ -794,6 +928,18 @@ Agent 的成本会随步数快速增长,因为每一步都要把完整的历 自己部署模型时,vLLM 等推理框架通过连续批处理提高吞吐量:每生成一步就把已完成的请求移出批次、把新请求加入,而不是等整批请求全部生成结束。 +自己部署时,显存首先被模型权重占用。量化指的是用更少的位数存储权重,例如把 4 个 BF16 权重量化为 INT8,取绝对值最大的 1.20 除以 127 作为缩放系数 s ≈ 0.00945,每个权重除以 s 后取整: + +```text +原始权重 0.12 -0.53 0.97 -1.20 +INT8 13 -56 103 -127 +还原(× s) 0.1228 -0.5291 0.9732 -1.2000 +``` + +误差在 0.003 左右;同样的权重量化为 INT4(-7~7)时还原为 0.171、-0.514、1.029、-1.2,误差明显变大。GPTQ、AWQ 等方法在量化时用少量校准数据减小误差,例如 AWQ 根据激活值找出对结果影响大的那部分权重,保护它们的精度。 + +以 Qwen2.5-7B(7.61B 参数)为例,权重在 BF16 下约 15.2 GB,INT8 约 7.6 GB,INT4 约 3.8 GB。在一张 24 GB 的显卡上,BF16 时只剩约 8.8 GB 放 KV Cache,按每个 Token 56 KB 计算约 15 万个 Token;INT4 时剩约 20 GB,能放约 35 万个 Token,可以同时服务更多的请求。代价是精度下降,量化后要在自己的任务上重新评测。 + ### 稳定性 - 限流与重试:模型服务会限制请求频率和 Token 速率,超限时返回 429 状态码,需要按指数退避重试; @@ -826,6 +972,9 @@ Agent 的成本会随步数快速增长,因为每一步都要把完整的历 - [The Curious Case of Neural Text Degeneration](https://arxiv.org/abs/1904.09751) - [Training Language Models to Follow Instructions with Human Feedback](https://arxiv.org/abs/2203.02155) - [Direct Preference Optimization: Your Language Model is Secretly a Reward Model](https://arxiv.org/abs/2305.18290) +- [DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models](https://arxiv.org/abs/2402.03300) +- [AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration](https://arxiv.org/abs/2306.00978) +- [GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers](https://arxiv.org/abs/2210.17323) - [LoRA: Low-Rank Adaptation of Large Language Models](https://arxiv.org/abs/2106.09685) - [QLoRA: Efficient Finetuning of Quantized LLMs](https://arxiv.org/abs/2305.14314) - [DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning](https://arxiv.org/abs/2501.12948) @@ -845,6 +994,11 @@ Agent 的成本会随步数快速增长,因为每一步都要把完整的历 - [ReAct: Synergizing Reasoning and Acting in Language Models](https://arxiv.org/abs/2210.03629) - [LLM Powered Autonomous Agents](https://lilianweng.github.io/posts/2023-06-23-agent/) - [Building Effective Agents](https://www.anthropic.com/engineering/building-effective-agents) +- [Effective Harnesses for Long-Running Agents](https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents) +- [Harness Engineering for Coding Agent Users](https://martinfowler.com/articles/harness-engineering.html) +- [The Anatomy of an Agent Harness](https://www.langchain.com/blog/the-anatomy-of-an-agent-harness) +- [ArchUnit User Guide](https://www.archunit.org/userguide/html/000_Index.html) +- [Claude Docs: Tool Search Tool](https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool) - [How We Built Our Multi-Agent Research System](https://www.anthropic.com/engineering/multi-agent-research-system) - [DeepSeek API 文档:Tool Calls](https://api-docs.deepseek.com/zh-cn/guides/tool_calls) - [Qwen2.5-7B-Instruct 对话模板](https://huggingface.co/Qwen/Qwen2.5-7B-Instruct/blob/main/tokenizer_config.json) @@ -857,3 +1011,6 @@ Agent 的成本会随步数快速增长,因为每一步都要把完整的历 - [Nginx: proxy_buffering](https://nginx.org/en/docs/http/ngx_http_proxy_module.html#proxy_buffering) - [Orca: A Distributed Serving System for Transformer-Based Generative Models](https://www.usenix.org/conference/osdi22/presentation/yu) - [OWASP Top 10 for LLM Applications: Prompt Injection](https://genai.owasp.org/llmrisk/llm01-prompt-injection/) +- [τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains](https://arxiv.org/abs/2406.12045) +- [How Claude Code works](https://code.claude.com/docs/en/how-claude-code-works) +- [How Claude remembers your project](https://code.claude.com/docs/en/memory) diff --git "a/notes/\346\224\273\345\207\273\346\212\200\346\234\257.md" "b/notes/\346\224\273\345\207\273\346\212\200\346\234\257.md" index 9c56e27c9..ec3bfea87 100644 --- "a/notes/\346\224\273\345\207\273\346\212\200\346\234\257.md" +++ "b/notes/\346\224\273\345\207\273\346\212\200\346\234\257.md" @@ -194,6 +194,14 @@ stmt.setString(2, password); ResultSet rs = stmt.executeQuery(); ``` +需要注意的是,MySQL 的 JDBC 驱动(Connector/J)默认并不在服务器上预编译,而是在客户端把参数中的单引号等字符转义后,拼成完整的语句发送。在本机用 Connector/J 8.3 执行上面的查询,两个参数都传入 1' OR '1'='1,MySQL 通用查询日志中记录的是: + +```text +Query SELECT * FROM users WHERE name = '1'' OR ''1''=''1' AND pw = '1'' OR ''1''=''1' +``` + +参数仍然只是一个普通的字符串,查询结果为空。连接参数加上 useServerPrepStmts=true 后,驱动才会先发送 Prepare、再发送 Execute。两种方式都能防止注入,关键在于参数由驱动或数据库处理,而不是由开发者拼接。表名、列名和 ORDER BY 的字段不能使用占位符,只能用白名单校验,见 [MyBatis 的 #{} 和 ${}](Spring.md#-和--的区别)。 + #### 2. 单引号转换 将传入的参数中的单引号转换为连续两个单引号。PHP 的 Magic Quotes 曾经自动完成这个功能,但是因为不可靠已经被移除,应该使用数据库驱动提供的转义函数,并且只在无法使用参数化查询时使用。 diff --git "a/notes/\346\225\260\346\215\256\345\272\223\347\263\273\347\273\237\345\216\237\347\220\206.md" "b/notes/\346\225\260\346\215\256\345\272\223\347\263\273\347\273\237\345\216\237\347\220\206.md" index 59006f300..8192a1991 100644 --- "a/notes/\346\225\260\346\215\256\345\272\223\347\263\273\347\273\237\345\216\237\347\220\206.md" +++ "b/notes/\346\225\260\346\215\256\345\272\223\347\263\273\347\273\237\345\216\237\347\220\206.md" @@ -49,7 +49,7 @@ 事务指的是满足 ACID 特性的一组操作,可以通过 Commit 提交一个事务,也可以使用 Rollback 进行回滚。 -

+

### ACID @@ -61,7 +61,7 @@ #### 2. 一致性(Consistency) -数据库在事务执行前后都保持一致性状态。在一致性状态下,所有事务对同一个数据的读取结果都是相同的。 +数据库在事务执行前后都保持一致性状态,即满足所有的约束和业务规则。例如转账前后,两个账户的余额总和保持不变。 #### 3. 隔离性(Isolation) @@ -82,7 +82,14 @@ - 在并发的情况下,多个事务并行执行,事务不仅要满足原子性,还需要满足隔离性,才能满足一致性。 - 事务满足持久化是为了能应对系统崩溃的情况。 -

+在 InnoDB 中,这四个特性分别这样实现: + +- 原子性:undo log 记录每次修改之前的值,回滚时用它恢复; +- 持久性:修改数据页之前先写 redo log,默认配置下事务提交时把 redo log 刷到磁盘,崩溃后重放 redo log 恢复已提交的修改,见 [MySQL 的日志](MySQL.md#七日志); +- 隔离性:写操作加锁,普通的读操作通过 MVCC 读取快照,见 [多版本并发控制](#五多版本并发控制); +- 一致性:由以上三者和数据库的约束(主键、唯一索引、外键)共同保证,业务规则还需要应用自己维护。 + +

### AUTOCOMMIT @@ -90,31 +97,31 @@ MySQL 默认采用自动提交模式。也就是说,如果不显式使用`STAR ## 二、并发一致性问题 -在并发环境下,事务的隔离性很难保证,因此会出现很多并发一致性问题。 +在并发环境下,事务的隔离性很难保证,因此会出现很多并发一致性问题。以下例子都是在 MySQL 8.0 上用两个会话实际执行得到的,表 account 中原有 id 为 1、2 的两行,余额都是 100。 ### 丢失修改 -丢失修改指一个事务的更新操作被另外一个事务的更新操作替换。一般在现实生活中常会遇到,例如:T1 和 T2 两个事务都对一个数据进行修改,T1 先修改并提交生效,T2 随后修改,T2 的修改覆盖了 T1 的修改。 +丢失修改指一个事务的更新操作被另外一个事务的更新操作替换。例如:T1 和 T2 先后读到余额为 100,T1 取出 30 元,写回 70 并提交;T2 存入 50 元,在它读到的 100 的基础上写回 150,T1 的修改被覆盖了。 -

+

### 读脏数据 读脏数据指在不同的事务下,当前事务可以读到另外事务未提交的数据。例如:T1 修改一个数据但未提交,T2 随后读取这个数据。如果 T1 撤销了这次修改,那么 T2 读取的数据是脏数据。 -

+

### 不可重复读 不可重复读指在一个事务内多次读取同一数据集合。在这一事务还未结束前,另一事务也访问了该同一数据集合并做了修改,由于第二个事务的修改,第一次事务的两次读取的数据可能不一致。例如:T2 读取一个数据,T1 对该数据做了修改。如果 T2 再次读取这个数据,此时读取的结果和第一次读取的结果不同。 -

+

### 幻影读 -幻读本质上也属于不可重复读的情况,T1 读取某个范围的数据,T2 在这个范围内插入新的数据,T1 再次读取这个范围的数据,此时读取的结果和和第一次读取的结果不同。 +幻读本质上也属于不可重复读的情况,T2 读取某个范围的数据,T1 在这个范围内插入新的数据,T2 再次读取这个范围的数据,此时读取的结果和第一次读取的结果不同。 -

+

---- @@ -147,7 +154,10 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。 锁的兼容关系如下: -

+| | X | S | +| :---: | :---: | :---: | +| X | 冲突 | 冲突 | +| S | 冲突 | 兼容 | #### 2. 意向锁 @@ -164,7 +174,12 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。 各种锁的兼容关系如下: -

+| | X | IX | S | IS | +| :---: | :---: | :---: | :---: | :---: | +| X | 冲突 | 冲突 | 冲突 | 冲突 | +| IX | 冲突 | 兼容 | 冲突 | 兼容 | +| S | 冲突 | 冲突 | 兼容 | 兼容 | +| IS | 冲突 | 兼容 | 兼容 | 兼容 | 解释如下: @@ -181,7 +196,7 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。 可以解决丢失修改问题,因为不能同时有两个事务对同一个数据进行修改,那么事务的修改就不会被覆盖。 -

+

**二级封锁协议** @@ -189,7 +204,7 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。 可以解决读脏数据问题,因为如果一个事务在对数据 A 进行修改,根据 1 级封锁协议,会加 X 锁,那么就不能再加 S 锁了,也就是不会读入数据。 -

+

**三级封锁协议** @@ -197,7 +212,7 @@ MySQL 中提供了两种封锁粒度:行级锁以及表级锁。 可以解决不可重复读的问题,因为读 A 时,其它事务不能对 A 加 X 锁,从而避免了在读的期间数据发生改变。 -

+

#### 2. 两段锁协议 @@ -244,13 +259,22 @@ SELECT ... FOR UPDATE; ### 可串行化(SERIALIZABLE) -强制事务串行执行,这样多个事务互不干扰,不会出现并发一致性问题。 +保证并发执行的结果与某种串行执行的结果相同,不会出现并发一致性问题。 -该隔离级别需要加锁实现,因为要使用加锁机制保证同一时间只有一个事务执行,也就是保证事务串行执行。 +InnoDB 的实现方式是在关闭自动提交时,把普通的 SELECT 都变成加共享锁的 SELECT ... FOR SHARE,读和写会互相阻塞,并发度最低。实测在可串行化的事务中读取 id 为 1 的行之后,另一个事务修改这一行会一直等待,直到锁等待超时;同样的操作在可重复读下可以立即完成。 ---- -

+各个隔离级别能否避免并发一致性问题: + +| 隔离级别 | 脏读 | 不可重复读 | 幻影读 | +| :---: | :---: | :---: | :---: | +| 未提交读 | 可能 | 可能 | 可能 | +| 提交读 | 不可能 | 可能 | 可能 | +| 可重复读 | 不可能 | 不可能 | 可能 | +| 可串行化 | 不可能 | 不可能 | 不可能 | + +这是 SQL 标准的规定。MySQL 的 InnoDB 默认使用可重复读,并且用 MVCC 和 Next-Key Locks 在很大程度上避免了幻影读,见 [六、Next-Key Locks](#六next-key-locks);Oracle 和 PostgreSQL 默认使用提交读。 ## 五、多版本并发控制 @@ -266,14 +290,13 @@ SELECT ... FOR UPDATE; ### 版本号 -- 系统版本号 SYS_ID:是一个递增的数字,每开始一个新的事务,系统版本号就会自动递增。 -- 事务版本号 TRX_ID :事务开始时的系统版本号。 +InnoDB 为每个事务分配一个递增的事务 ID(TRX_ID),每个数据行都记录着最后修改它的事务 ID。需要注意的是,事务 ID 不是在 BEGIN 时分配的,而是在事务第一次修改数据时才分配;只读的事务不分配真正的事务 ID,也就不会出现在其它事务的 ReadView 中。在 MySQL 8.0 中实测:事务执行 SELECT 时 information_schema.innodb_trx 中显示的 trx_id 是一个很大的临时编号 281479674465408,执行 UPDATE 之后变为 3095。 ### Undo 日志 MVCC 的多版本指的是多个版本的快照,快照存储在 Undo 日志中,该日志通过回滚指针 ROLL_PTR 把一个数据行的所有快照连接起来。 -例如在 MySQL 创建一个表 t,包含主键 id 和一个字段 x。我们先插入一个数据行,然后对该数据行执行两次更新操作。 +例如在 MySQL 创建一个表 t,包含主键 id 和一个字段 x。先插入一个数据行,然后对该数据行执行两次更新操作。 ```sql INSERT INTO t(id, x) VALUES(1, "a"); @@ -281,9 +304,9 @@ UPDATE t SET x="b" WHERE id=1; UPDATE t SET x="c" WHERE id=1; ``` -因为没有使用 `START TRANSACTION` 将上面的操作当成一个事务来执行,根据 MySQL 的 AUTOCOMMIT 机制,每个操作都会被当成一个事务来执行,所以上面的操作总共涉及到三个事务。快照中除了记录事务版本号 TRX_ID 和操作之外,还记录了一个 bit 的 DEL 字段,用于标记是否被删除。 +因为没有使用 `START TRANSACTION` 将上面的操作当成一个事务来执行,根据 MySQL 的 AUTOCOMMIT 机制,每个操作都会被当成一个事务来执行,所以上面的操作总共涉及到三个事务,假设它们的 ID 依次为 101、102、103。快照中除了记录事务版本号 TRX_ID 和操作之外,还记录了一个 bit 的 DEL 字段,用于标记是否被删除。 -

+

INSERT、UPDATE、DELETE 操作会创建一个日志,并将事务版本号 TRX_ID 写入。DELETE 可以看成是一个特殊的 UPDATE,还会额外将 DEL 字段设置为 1。 @@ -291,7 +314,6 @@ INSERT、UPDATE、DELETE 操作会创建一个日志,并将事务版本号 TRX MVCC 维护了一个 ReadView 结构,主要包含了创建 ReadView 时系统中未提交的事务列表 TRX_IDs {TRX_ID_1, TRX_ID_2, ...},该列表的最小值 TRX_ID_MIN,以及下一个将要分配的事务 ID TRX_ID_MAX。 -

在进行 SELECT 操作时,根据数据行快照的 TRX_ID 与 TRX_ID_MIN 和 TRX_ID_MAX 之间的关系,从而判断数据行快照是否可以使用: @@ -301,7 +323,13 @@ MVCC 维护了一个 ReadView 结构,主要包含了创建 ReadView 时系统 提交读和可重复读的判断规则相同,区别在于 ReadView 的创建时机:提交读在每次 SELECT 时都创建新的 ReadView,因此能读到其它事务新提交的修改;可重复读只在事务第一次 SELECT 时创建 ReadView,之后一直复用,因此多次读取的结果相同。 -在数据行快照不可使用的情况下,需要沿着 Undo Log 的回滚指针 ROLL_PTR 找到下一个快照,再进行上面的判断。 +在数据行快照不可使用的情况下,需要沿着 Undo Log 的回滚指针 ROLL_PTR 找到下一个快照,再进行上面的判断。 + +接着上面的例子,假设事务 103 修改了 x 但还没有提交,另一个事务这时开始读取这一行: + +

+ +在 MySQL 8.0 上实际执行:事务 103 未提交时,可重复读的读事务读到 'b';103 提交之后,这个读事务再读仍然是 'b',而新开始的提交读事务读到 'c'。 ### 快照读与当前读 @@ -323,11 +351,11 @@ UPDATE; DELETE; ``` -在进行 SELECT 操作时,可以强制指定进行加锁操作。以下第一个语句需要加 S 锁,第二个需要加 X 锁。 +在进行 SELECT 操作时,可以强制指定进行加锁操作。以下第一个语句需要加 S 锁,第二个需要加 X 锁。MySQL 8.0 起推荐用 FOR SHARE 代替 LOCK IN SHARE MODE。 ```sql -SELECT * FROM table WHERE ? lock in share mode; -SELECT * FROM table WHERE ? for update; +SELECT * FROM table WHERE ? FOR SHARE; +SELECT * FROM table WHERE ? FOR UPDATE; ``` ## 六、Next-Key Locks @@ -336,6 +364,18 @@ Next-Key Locks 是 MySQL 的 InnoDB 存储引擎的一种锁实现。 在可重复读(REPEATABLE READ)隔离级别下,MVCC 使普通的 SELECT(快照读)不会读到其它事务新插入的行,但是 UPDATE、DELETE、SELECT ... FOR UPDATE 等当前读仍然可能出现幻读,Next-Key Locks 就是为了解决这个问题而存在的。InnoDB 使用 MVCC + Next-Key Locks 在可重复读隔离级别下解决了幻读问题。 +需要注意的是,这要求一个事务中的读取全部是快照读或者全部是当前读,两者混用时仍然会出现幻读。在 MySQL 8.0 中实测,表 acct 原有 id 为 1、2 的两行: + +```text +A:SELECT * FROM acct WHERE balance >= 100; -- id 1、2 +B:INSERT INTO acct VALUES (3, 100); -- 自动提交 +A:SELECT * FROM acct WHERE balance >= 100; -- 仍然是 id 1、2 +A:UPDATE acct SET balance = balance + 10 WHERE balance >= 100; -- Rows matched: 3 +A:SELECT * FROM acct WHERE balance >= 100; -- id 1、2、3 +``` + +事务 A 的 UPDATE 是当前读,看到了事务 B 新插入并已提交的第 3 行,并且修改了它;这一行最新版本的事务 ID 变成了 A 自己,所以之后的快照读也能看到它。如果 A 一开始就用 SELECT ... FOR UPDATE 加锁读取,B 的插入会被 Next-Key Locks 阻塞,直到锁等待超时(ERROR 1205 Lock wait timeout exceeded)。 + ### Record Locks 锁定一个记录上的索引,而不是记录本身。 @@ -362,7 +402,11 @@ SELECT c FROM t WHERE c BETWEEN 10 and 20 FOR UPDATE; (20, +∞) ``` -

+在 MySQL 8.0 中建表 t(id, c),c 上有普通索引,插入 c 为 10、11、13、20 的四行,然后在可重复读下执行两种加锁读,从 performance_schema.data_locks 中查看实际加的锁,并在另一个事务中尝试插入: + +

+ +按 c = 11 查询时,c 不是唯一索引,后面还可能有 c = 11 的记录,所以除了 (10, 11] 的 Next-Key Lock,还要锁住到下一条记录 13 之间的间隙;如果 c 是唯一索引,就只锁 c = 11 这一条记录。 ## 七、关系数据库设计理论 @@ -526,8 +570,11 @@ Entity-Relationship,有三个组成部分:实体、属性、联系。 - 施瓦茨. 高性能 MYSQL(第3版)[M]. 电子工业出版社, 2013. - 史嘉权. 数据库系统概论[M]. 清华大学出版社有限公司, 2006. - [The InnoDB Storage Engine](https://dev.mysql.com/doc/refman/5.7/en/innodb-storage-engine.html) +- [MySQL 8.0: Transaction Isolation Levels](https://dev.mysql.com/doc/refman/8.0/en/innodb-transaction-isolation-levels.html) +- [MySQL 8.0: InnoDB Locking](https://dev.mysql.com/doc/refman/8.0/en/innodb-locking.html) +- [MySQL 8.0: The data_locks Table](https://dev.mysql.com/doc/refman/8.0/en/performance-schema-data-locks-table.html) - [Transaction isolation levels](https://www.slideshare.net/ErnestoHernandezRodriguez/transaction-isolation-levels) -- [Concurrency Control](http://scanftree.com/dbms/2-phase-locking-protocol) +- [Concurrency Control](https://web.archive.org/web/20260614192237/https://scanftree.com/dbms/2-phase-locking-protocol) - [The Nightmare of Locking, Blocking and Isolation Levels!](https://www.slideshare.net/brshristov/the-nightmare-of-locking-blocking-and-isolation-levels-46391666) - [Database Normalization and Normal Forms with an Example](https://aksakalli.github.io/2012/03/12/database-normalization-and-normal-forms-with-an-example.html) - [The basics of the InnoDB undo logging and history system](https://blog.jcole.us/2014/04/16/the-basics-of-the-innodb-undo-logging-and-history-system/) diff --git "a/notes/\346\236\204\345\273\272\345\267\245\345\205\267.md" "b/notes/\346\236\204\345\273\272\345\267\245\345\205\267.md" index bda24a111..99cb232ea 100644 --- "a/notes/\346\236\204\345\273\272\345\267\245\345\205\267.md" +++ "b/notes/\346\236\204\345\273\272\345\267\245\345\205\267.md" @@ -49,12 +49,14 @@ Gradle 和 Maven 的区别是,它使用 Groovy 这种特定领域语言(DSL 而 Gradle 只需要几行代码: -```java +```groovy dependencies { - testCompile "junit:junit:4.10" + testImplementation "junit:junit:4.10" } ``` +早期版本中的 testCompile 在 Gradle 7 中已被移除,改用 testImplementation。Gradle 也可以用 Kotlin 编写构建脚本(build.gradle.kts),Gradle 8.2 起新建的项目默认使用 Kotlin。 + ## 三、Maven ### 概述 @@ -114,11 +116,16 @@ A -> C -> X(2.0) ### 解决依赖冲突 -找到 Maven 加载的 Jar 包版本,使用 `mvn dependency:tree` 查看依赖树,根据依赖原则来调整依赖在 POM 文件的声明顺序。 +先用 `mvn dependency:tree` 查看依赖树,找到冲突的版本分别是从哪条路径引入的,再用以下方法确定使用的版本: + +- 在 dependencyManagement 中声明版本,所有传递依赖都使用这个版本; +- 用 exclusions 排除某个依赖传递过来的版本; +- 在当前 POM 中直接声明需要的版本,它的路径最短。 ## 参考资料 - [POM Reference](http://maven.apache.org/pom.html#Dependency_Version_Requirement_Specification) +- [Introduction to the Dependency Mechanism](https://maven.apache.org/guides/introduction/introduction-to-dependency-mechanism.html) - [What is a build tool?](https://stackoverflow.com/questions/7249871/what-is-a-build-tool) - [Java Build Tools Comparisons: Ant vs Maven vs Gradle](https://programmingmitra.blogspot.com/2016/05/java-build-tools-comparisons-ant-vs.html) - [maven 2 gradle](http://sagioto.github.io/maven2gradle/) diff --git "a/notes/\346\266\210\346\201\257\351\230\237\345\210\227.md" "b/notes/\346\266\210\346\201\257\351\230\237\345\210\227.md" index 3c4e466d5..a2b2122a7 100644 --- "a/notes/\346\266\210\346\201\257\351\230\237\345\210\227.md" +++ "b/notes/\346\266\210\346\201\257\351\230\237\345\210\227.md" @@ -14,6 +14,14 @@ * [接收端的可靠性](#接收端的可靠性) * [四、顺序性](#四顺序性) * [五、消息堆积](#五消息堆积) + * [六、延迟消息与死信队列](#六延迟消息与死信队列) + * [延迟消息](#延迟消息) + * [死信队列](#死信队列) + * [七、Kafka](#七kafka) + * [分区与消费者组](#分区与消费者组) + * [存储](#存储) + * [为什么吞吐量高](#为什么吞吐量高) + * [副本与可靠性](#副本与可靠性) * [参考资料](#参考资料) @@ -104,8 +112,132 @@ Kafka、RocketMQ 等通过消费者组把两种模型结合起来:一条消息 解决方法是增加消费者数量来提高消费能力,但是消费者数量超过队列(分区)数量之后就不再有效,需要同时增加队列数量。 +## 六、延迟消息与死信队列 + +### 延迟消息 + +延迟消息指的是发送后不立即投递,等到指定时间才能被消费的消息。典型的场景是订单 30 分钟未支付自动取消:下单时发送一条 30 分钟后投递的消息,到时消费者检查订单,仍未支付就取消。相比定时任务扫描全表,延迟消息只处理到期的订单。 + +各消息队列的支持情况: + +- RocketMQ 4.x 只支持 18 个固定的延迟级别:1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h,消息先存入内部的定时主题,到期后再投递到目标主题; +- RocketMQ 5.x 支持指定任意的投递时间,默认最长 24 小时,精度为秒级; +- RabbitMQ 没有原生的延迟消息,常用的做法是给消息设置过期时间(TTL),过期后转入死信交换机,由死信队列的消费者处理,或者安装延迟消息插件; +- Kafka 不支持延迟消息,需要自己实现,例如按延迟时长分成几个主题,消费者读到未到期的消息就暂停等待。 + +不使用消息队列时,也可以用 Redis 的有序集合实现:分值为到期时间,后台线程定期取出分值不大于当前时间的成员。多个实例同时轮询时,用 ZREM 的返回值判断由谁处理,返回 1 的实例才处理: + +```text +> zadd delay:orders 1792997618 order:1024 1792999423 order:1025 +(integer) 2 +> zrangebyscore delay:orders 0 1792997623 limit 0 10 +1) "order:1024" +> zrem delay:orders order:1024 +(integer) 1 +> zrem delay:orders order:1024 +(integer) 0 +``` + +JDK 自带的 DelayQueue 也能实现延迟,但数据只在单个进程的内存中,服务重启就会丢失,多个实例之间也无法共享。 + +### 死信队列 + +消息多次消费失败后,不再重试,而是转入死信队列,避免一条有问题的消息反复重试、阻塞其它消息,之后由人工或专门的程序排查处理。 + +- RocketMQ 并发消费时默认重试 16 次,仍然失败就进入名为 %DLQ% 加消费者组名的死信主题; +- RabbitMQ 中消息被消费者拒绝且不重新入队、消息的 TTL 过期、队列长度超过上限时,消息会被转发到死信交换机。 + +事务消息用于保证本地事务和发送消息同时成功或失败,见 [分布式事务中的事务消息](分布式.md#本地消息表)。 + +## 七、Kafka + +### 分区与消费者组 + +Kafka 中的消息按主题(Topic)分类,每个主题分成多个分区(Partition)。分区是一个只能在末尾追加的日志,每条消息在分区内有一个递增的偏移量(Offset),消费者记录自己读到了哪个偏移量。 + +生产者发送消息时可以带一个 key,默认按 key 的哈希值对分区数取模选择分区,相同 key 的消息一定进入同一个分区,所以同一个订单的消息是有序的,不同分区之间则没有顺序。没有 key 时,生产者先把一批消息发往同一个分区,再换下一个分区,以便凑成批次。 + +

+ +消费者以消费者组为单位订阅主题:组内每个分区只分配给一个消费者,一个消费者可以负责多个分区。所以分区数决定了一个组最多有多少个消费者同时工作,多出来的消费者只能空闲。不同的组各自独立地消费全部消息,例如计费服务和物流服务各用一个组,都能收到每一条订单消息。 + +消费者加入、退出或者分区数变化时,组内会重新分配分区,称为重平衡(Rebalance)。重平衡期间被重新分配的分区暂停消费,还可能造成重复消费。一个常见的原因是处理一批消息的时间超过了 max.poll.interval.ms(默认 5 分钟),消费者被认为已经失效,它的分区被分给其他消费者。 + +### 存储 + +每个分区在磁盘上是一个目录,日志按大小切分成多个段(Segment),文件名是段中第一条消息的偏移量。本机把段的大小设为 1 MB(默认 1 GB),向一个只有一个分区的主题写入 3 万条 100 字节的消息后,目录中的文件和大小如下(省略了 .timeindex 等文件): + +```text +00000000000000000000.log 1041728 +00000000000000000000.index 504 +00000000000000009472.log 1041728 +00000000000000009472.index 504 +00000000000000018944.log 1041728 +00000000000000018944.index 504 +00000000000000028416.log 174207 +00000000000000028416.index 10485760 +``` + +.index 是稀疏索引,每写入一段数据(index.interval.bytes,默认 4 KB)记录一条“偏移量 → 在 .log 文件中的位置”。查找偏移量 20000 的消息: + +1. 按文件名二分查找,20000 落在 00000000000000018944 这个段中; +2. 在这个段的索引中二分查找,不大于 20000 的最近一条索引是 19979 → 97662; +3. 从 .log 文件的位置 97662 开始顺序读,下一个批次(偏移量 19980~20127)中就有 20000。 + +正在写入的段的索引文件预先分配了 10 MB,并用 mmap 映射到内存,段写满后才截断为实际大小。用 kafka-dump-log.sh 查看 .log 文件,可以看到消息是按批次存放的,这里每个批次有 148 条消息、16277 字节,接近生产者批次大小的默认值 16 KB。 + +旧数据按保留时间(默认 7 天)或总大小清理,每次删除一整个段,不需要修改文件内容;也可以配置为日志压缩,每个 key 只保留最新的一条消息。 + +### 为什么吞吐量高 + +顺序写和页缓存:消息只追加到日志的末尾,是顺序写,比随机写快得多。写入时只写到操作系统的页缓存,由操作系统决定何时刷盘,消费者读取刚写入不久的数据时也通常直接命中页缓存。可靠性不依靠每条消息都刷盘,而是依靠多个副本。 + +批量:生产者把发往同一个分区的消息攒成批次再发送,批次在网络传输、写入日志和副本复制时都作为一个整体处理,压缩也以批次为单位。在本机 3 个节点的集群上用 kafka-producer-perf-test.sh 发送 2 万条 100 字节的消息(acks=all),各运行 3 次:默认配置每秒约 5.7 万~6.8 万条,平均延迟 21~54 ms;设置 batch.size=0 关闭批量后,每秒只有约 6500~6800 条,发送的请求大量排队,平均延迟约 1.4 秒。 + +零拷贝:broker 把日志发给消费者时使用 sendfile 系统调用,数据不需要先读到用户空间再写回内核: + +

+ +分区并行:一个主题的多个分区分布在不同的 broker 上,读写由多台机器共同承担。 + +### 副本与可靠性 + +每个分区有多个副本,分布在不同的 broker 上,其中一个是 Leader,负责处理读写,其余的 Follower 不断从 Leader 拉取数据。与 Leader 保持同步的副本集合称为 ISR(In-Sync Replicas),Follower 超过 replica.lag.time.max.ms(默认 30 秒)没有追上 Leader 就会被移出 ISR。Kafka 4.0 起完全移除了 ZooKeeper,Leader 选举等元数据由内置的 KRaft 控制器管理,它基于 Raft 协议实现。 + +本机创建 3 个分区、3 个副本的主题,然后用 kill -9 停掉 broker 3: + +```text +停止前 +Partition: 0 Leader: 2 Replicas: 2,3,1 Isr: 2,3,1 +Partition: 1 Leader: 3 Replicas: 3,1,2 Isr: 3,1,2 +Partition: 2 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3 +停止后 +Partition: 0 Leader: 2 Replicas: 2,3,1 Isr: 2,1 +Partition: 1 Leader: 1 Replicas: 3,1,2 Isr: 1,2 +Partition: 2 Leader: 1 Replicas: 1,2,3 Isr: 1,2 +``` + +分区 1 的 Leader 从 broker 3 切换到了 ISR 中的 broker 1,其它分区只是 ISR 中少了 3。broker 3 重启并追上数据后,又回到了 ISR 中。 + +生产者的 acks 参数决定写入多少个副本才算成功: + +- acks=0:不等待确认,可能丢消息; +- acks=1:Leader 写入就返回,Leader 宕机而 Follower 还没同步时会丢消息; +- acks=all:ISR 中的副本都写入才返回,Kafka 3.0 起是默认值。 + +acks=all 要配合 min.insync.replicas 使用,否则 ISR 只剩 Leader 一个时,acks=all 就退化成了 acks=1。min.insync.replicas 设为 2 时,ISR 少于 2 个副本,broker 就拒绝 acks=all 的写入。上面停掉 broker 3 之后 ISR 还有 2 个副本,写入正常;把 min.insync.replicas 改为 3 再写入,生产者重试几次后报错 NotEnoughReplicasException,改用 acks=1 则仍然能写入。常用的配置是 3 个副本、min.insync.replicas=2、acks=all,一个副本故障时既不丢消息,也不停止写入。 + +生产者没有收到确认就会重试,这可能让同一条消息写入两次。Kafka 3.0 起默认开启幂等生产者:broker 给每个生产者分配一个 ID,生产者给发往每个分区的消息编上序号,broker 发现序号重复就丢弃。前面查看 .log 文件时,每个批次都带有 producerId: 1001 和 baseSequence 字段。幂等只保证单个分区内不重复;要让写入多个分区的消息同时成功或失败,需要使用事务,消费者设置 isolation.level=read_committed 后只读取已提交事务中的消息。 + +消费者处理完消息后提交偏移量,下次从提交的位置继续读取。默认每 5 秒自动提交一次,已经处理但还没提交时崩溃,重启后就会重复消费。本机实验中,消费者读到 3 条扣款消息后被 kill -9,这时组的偏移量仍然为空;它在 session.timeout.ms(默认 45 秒)之后被移出消费者组,重新启动的消费者又收到了这 3 条消息。因此接收端必须做到幂等,方法见 [接收端的可靠性](#接收端的可靠性)。反过来,如果先提交偏移量再处理,处理失败的消息就丢失了。 + ## 参考资料 - [Observer vs Pub-Sub](http://developers-club.com/posts/270339/) - [Designing Data-Intensive Applications 中文版](https://github.com/vonng/ddia) -- [消息队列中点对点与发布订阅区别](https://blog.csdn.net/lizhitao/article/details/47723105) +- [消息队列中点对点与发布订阅区别](https://web.archive.org/web/20250522024511/https://blog.csdn.net/lizhitao/article/details/47723105) +- [定时/延时消息 | RocketMQ](https://rocketmq.apache.org/zh/docs/featureBehavior/02delaymessage/) +- [Dead Letter Exchanges | RabbitMQ](https://www.rabbitmq.com/docs/dlx) +- [Apache Kafka Documentation: Design](https://kafka.apache.org/43/design/design/) +- [Apache Kafka Documentation: Configuration](https://kafka.apache.org/43/configuration/) +- [Apache Kafka Documentation: Upgrading](https://kafka.apache.org/43/getting-started/upgrade/) diff --git "a/notes/\347\263\273\347\273\237\350\256\276\350\256\241\345\237\272\347\241\200.md" "b/notes/\347\263\273\347\273\237\350\256\276\350\256\241\345\237\272\347\241\200.md" index 4e6cfce1d..fb0e68fde 100644 --- "a/notes/\347\263\273\347\273\237\350\256\276\350\256\241\345\237\272\347\241\200.md" +++ "b/notes/\347\263\273\347\273\237\350\256\276\350\256\241\345\237\272\347\241\200.md" @@ -8,6 +8,8 @@ * [五、安全性](#五安全性) * [六、秒杀系统](#六秒杀系统) * [七、海量数据处理](#七海量数据处理) + * [八、短链系统](#八短链系统) + * [九、Feed 流](#九feed-流) * [参考资料](#参考资料) @@ -208,8 +210,82 @@ UPDATE goods SET stock = stock - 1 WHERE id = 1001 AND stock > 0; 如果数据的取值范围很小,例如 1 亿个 10000 到 20000 之间的整数,一共只有 10001 种取值,用长度为 10001 的数组统计每个值出现的次数,一次扫描就能完成排序,也就是计数排序。 +## 八、短链系统 + +短链系统把很长的网址换成很短的网址,例如把 https://shop.example.com/item/1024?from=campaign 换成 https://s.example/6LAze,常用于短信和社交媒体。用户访问短链时,服务返回一个跳转,浏览器再去访问原来的长链接。 + +

+ +### 短码的生成 + +常见的方法有三种: + +- 哈希:对长链接计算哈希(例如 MurmurHash),再把结果转成 Base62。同一个长链接总是得到同一个短码,但不同的长链接也可能得到同一个短码,冲突时要加上后缀重新计算; +- 随机:随机生成 6 位字符,由唯一索引检查是否重复,重复就重新生成。已经用掉的短码越多越容易重复,例如已有 10 亿个短链时,新生成的短码约有 1.8% 的概率重复; +- 发号器:先取一个全局唯一的自增 ID,再转成 Base62。不会冲突,短码也最短。 + +Base62 指的是用 0~9、a~z、A~Z 共 62 个字符表示一个数。例如 ID 100000000 不断除以 62,依次得到余数 14、35、36、47、6,倒过来对应字符 6、L、A、z、e,短码就是 6LAze。6 位 Base62 能表示 626 ≈ 568 亿个短码,每天新增 1 亿个也能用一年半。 + +发号器通常用 [数据库号段](分布式.md#八分布式-id):每个实例一次领取 1000 个 ID 在内存中使用,用完再领。雪花算法生成的 ID 是 64 位的大整数,转成 Base62 也有 11 位,用在短链中太长。需要注意的是,自增 ID 得到的短码是连续的,100000001 对应 6LAzf,别人可以据此遍历出其他短链;对隐私敏感的链接可以改用随机的方法,或者加上有效期和访问权限。 + +### 跳转用 301 还是 302 + +301 表示永久跳转,响应默认可以被缓存,浏览器之后会直接跳到长链接;302 表示临时跳转,每次访问都会请求短链服务。在本机用 Edge 访问同一个短链两次:返回 301 时,第二次直接跳到了长链接,服务端只收到一次请求;返回 302 时,两次都请求了服务端。 + +需要统计点击量、允许修改目标地址或者设置有效期时用 302;只想减轻服务端的压力时可以用 301。 + +### 存储与缓存 + +```sql +CREATE TABLE short_url ( + code VARCHAR(8) PRIMARY KEY, + long_url VARCHAR(2048) NOT NULL, + url_hash BINARY(16) NOT NULL, -- 长链接的 MD5,用于查找同一个长链接是否已经生成过 + expire_at DATETIME, + KEY idx_url_hash (url_hash) +); +``` + +长链接最长可能有几千个字符,直接在 long_url 上建唯一索引会报错 Specified key was too long(InnoDB 索引最长 3072 字节),所以另存一列 16 字节的 MD5 建索引,查到后再比较完整的长链接。 + +短链读多写少,热门链接的访问又很集中,适合用 Redis 缓存短码到长链接的映射。不存在的短码会穿透到数据库,可以缓存空值或者使用布隆过滤器,见 [缓存穿透](缓存.md#缓存穿透)。点击统计不要在跳转时同步写数据库,而是把点击事件写入消息队列,异步汇总。 + +## 九、Feed 流 + +Feed 流指的是把关注的人发布的内容按时间倒序合并后展示,例如朋友圈和微博的首页。每个用户有一个发件箱,保存自己发的帖子;难点在于怎样把几百个人的发件箱合成一个首页。 + +

+ +### 拉模式与推模式 + +- 拉模式(读扩散):打开首页时,读取所有关注者的发件箱,合并后取最新的一页。发帖只写一次,但关注的人越多读得越慢; +- 推模式(写扩散):发帖时把帖子写入每个粉丝的收件箱,打开首页只需读自己的收件箱。读很快,但粉丝越多写得越多,而且每个粉丝都存一份帖子 ID。 + +在本机的 Redis 7.4 上用有序集合实验(分值为发布时间):一个帖子推给 10 万个粉丝,用流水线写入 10 万个收件箱共 532 ms,已有的收件箱每多一条约占 16 字节;读自己的收件箱一页只需 0.12 ms;拉模式从 500 个发件箱各取最新 20 条再合并,一次要 24.5 ms。按这个速度,一个有 1000 万粉丝的大 V 发一条帖子,单个节点要写入约 50 秒,多占用约 150 MB 内存。 + +所以实际的系统大多推拉结合: + +- 粉丝少的普通用户使用推模式; +- 粉丝很多的大 V 不推,粉丝打开首页时,从自己的收件箱和所关注的少数几个大 V 的发件箱中拉取,再合并; +- 只推给最近活跃的粉丝,长期不登录的用户回来时再用拉模式重建收件箱; +- 收件箱只保留最近的若干条,例如每次写入后执行 ZREMRANGEBYRANK inbox:1001 0 -1001,只留下分值最大的 1000 条,更早的内容到数据库中查。 + +### 分页 + +Feed 流的分页不能用偏移量。例如收件箱中有 p1~p30 共 30 条帖子,第 1 页取到 p30~p21;用户翻页之前又有 3 条新帖子进来,这时按偏移量取第 11~20 条,结果是 p23~p14,p23、p22、p21 重复出现了。 + +应该用上一页最后一条的分值作为游标,取比它更早的帖子: + +```text +> ZRANGE inbox:1001 (21 -inf BYSCORE REV LIMIT 0 10 +p20 p19 p18 ... p11 +``` + +左括号表示不包含 21 本身,这是 Redis 6.2 起的写法,相当于旧的 ZREVRANGEBYSCORE。分值相同的帖子可能被跳过,可以把分值设为帖子 ID 这类唯一且递增的值,例如雪花算法生成的 ID 本身就按时间递增,见 [分布式 ID](分布式.md#八分布式-id)。 + ## 参考资料 - [Redis: Scripting with Lua](https://redis.io/docs/latest/develop/programmability/eval-intro/) - 大型网站技术架构:核心原理与案例分析 - [Designing Data-Intensive Applications 中文版](https://github.com/vonng/ddia) +- [RFC 9110: HTTP Semantics](https://www.rfc-editor.org/rfc/rfc9110) diff --git "a/notes/\347\274\223\345\255\230.md" "b/notes/\347\274\223\345\255\230.md" index 5e4f6aad8..84ff119a7 100644 --- "a/notes/\347\274\223\345\255\230.md" +++ "b/notes/\347\274\223\345\255\230.md" @@ -60,6 +60,33 @@ 相对于本地缓存来说,分布式缓存单独部署,可以根据需求分配硬件资源。不仅如此,服务器集群都可以访问分布式缓存,而本地缓存需要在服务器集群之间进行同步,实现难度和性能开销上都非常大。 +### 多级缓存 + +多级缓存把本地缓存和分布式缓存组合起来:先查本地缓存,未命中再查 Redis,再未命中才查数据库,并逐级回填。 + +

+ +在本机测试,Caffeine 读取一次约 21 纳秒;redis-benchmark 用单个连接逐条发送 GET,每次约 71 微秒,相差三千多倍,这还只是本机回环,跨机器访问还要加上网络往返。热点数据放在本地缓存中,既省去了网络开销,也不会让请求集中到存放这个热点键的 Redis 节点上。 + +本地缓存在每个实例中各存一份,难点在于数据更新后怎样让所有实例失效: + +- 更新数据库后删除 Redis 中的键,再通过 Redis 的发布订阅或消息队列广播一条删除消息,各实例收到后删除自己的本地缓存; +- Redis 的发布订阅不保证送达,实例断线期间的消息会丢失,所以本地缓存还要设置较短的过期时间(例如 30 秒)兜底; +- 因此本地缓存只适合读多写少、能接受短暂不一致的数据,例如商品详情、配置;库存、余额这类数据不要放在本地缓存中。 + +Caffeine 是目前常用的本地缓存库,使用方式如下: + +```java +Cache cache = Caffeine.newBuilder() + .maximumSize(10_000) // 最多 1 万个,超出时淘汰 + .expireAfterWrite(Duration.ofSeconds(30)) // 写入 30 秒后过期 + .build(); + +Product p = cache.get("product:1024", key -> loadFromRedisOrDb(key)); +``` + +它的淘汰算法 W-TinyLFU 同时考虑访问频率和最近访问时间,命中率通常高于 LRU;get 传入的加载函数对同一个键只会执行一次,其它并发的请求等待它的结果,避免缓存未命中时大量请求同时查询下游。 + ### 数据库缓存 MySQL 等数据库管理系统具有自己的缓存机制来提高查询效率,例如 InnoDB 的 Buffer Pool 将数据页和索引页缓存在内存中。MySQL 的查询缓存因为命中率低、维护开销大,已经在 8.0 版本中被移除。 @@ -84,7 +111,7 @@ CDN 主要有以下优点: - 通过部署多台服务器,从而提高系统整体的带宽性能; - 多台服务器可以看成是一种冗余机制,从而具有高可用性。 -

+

## 四、缓存问题 @@ -99,7 +126,7 @@ CDN 主要有以下优点: 布隆过滤器用多个哈希函数把 Key 映射到位数组的多个位置并置为 1。查询时只要有一个位置为 0,Key 就一定不存在;全部为 1 时 Key 可能存在,存在一定的误判率。 -

+

### 缓存击穿 @@ -132,7 +159,7 @@ CDN 主要有以下优点: 删除缓存而不是更新缓存,是因为两个并发的写操作到达缓存的顺序可能和到达数据库的顺序不同,导致缓存中是旧值。先更新数据库再删除缓存,是因为反过来的话,删除缓存之后、更新数据库之前的读请求会把旧值重新写入缓存。 -

+

这种模式仍然存在小概率的不一致,例如删除缓存失败。常用的补救措施: @@ -205,11 +232,9 @@ CDN 主要有以下优点: 将哈希空间 [0, 2n-1] 看成一个哈希环,每个服务器节点都通过哈希配置到哈希环上。每个数据对象通过哈希函数得到哈希值之后,存放到哈希环中顺时针方向第一个大于等于该哈希值的节点上。 -

- 一致性哈希在增加或者删除节点时只会影响到哈希环中相邻的节点,例如下图中在 B 和 C 之间新增节点 X,只需要将节点 C 上哈希值位于 B 和 X 之间的数据迁移到 X 上即可,对于节点 A、B、D 都没有影响。 -

+

### 虚拟节点 @@ -228,7 +253,7 @@ Redis Cluster 使用的不是一致性哈希,而是把 Key 映射到固定的 - 访问某个节点时,将其从原来的位置删除,并重新插入到链表头部。这样就能保证链表尾部存储的就是最近最久未使用的节点,当节点数量大于缓存最大空间时就淘汰链表尾部的节点。 - 为了使删除操作时间复杂度为 O(1),就不能采用遍历的方式找到某个节点。HashMap 存储着 Key 到节点的映射,通过 Key 就能以 O(1) 的时间得到节点,然后再以 O(1) 的时间将其从双向队列中删除。 -

+

Java 的 LinkedHashMap 内部就是这种结构,把 accessOrder 设为 true 并重写 removeEldestEntry 方法,就可以直接得到一个 LRU 缓存。 @@ -368,3 +393,4 @@ public class LRU implements Iterable { - [How Aspiration CDN helps to improve your website loading speed?](https://www.aspirationhosting.com/aspiration-cdn/) - [Redis: UNLINK](https://redis.io/docs/latest/commands/unlink/) - [Redis CLI](https://redis.io/docs/latest/develop/tools/cli/) +- [Caffeine Wiki](https://github.com/ben-manes/caffeine/wiki) diff --git "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \345\206\205\345\255\230\347\256\241\347\220\206.md" "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \345\206\205\345\255\230\347\256\241\347\220\206.md" index 61eb50688..b00a61130 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \345\206\205\345\255\230\347\256\241\347\220\206.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \345\206\205\345\255\230\347\256\241\347\220\206.md" @@ -18,13 +18,13 @@ ## 虚拟内存 -虚拟内存的目的是为了让物理内存扩充成更大的逻辑内存,从而让程序获得更多的可用内存。 +虚拟内存的目的是为了让物理内存扩充成更大的逻辑内存,从而让程序获得更多的可用内存。此外,每个进程都有独立的地址空间,一个进程无法直接访问另一个进程的内存,操作系统还可以按页设置读写和执行权限。 -为了更好的管理内存,操作系统将内存抽象成地址空间。每个程序拥有自己的地址空间,这个地址空间被分割成多个块,每一块称为一页。这些页被映射到物理内存,但不需要映射到连续的物理内存,也不需要所有页都必须在物理内存中。当程序引用到不在物理内存中的页时,由硬件执行必要的映射,将缺失的部分装入物理内存并重新执行失败的指令。 +为了更好的管理内存,操作系统将内存抽象成地址空间。每个程序拥有自己的地址空间,这个地址空间被分割成多个块,每一块称为一页。这些页被映射到物理内存,但不需要映射到连续的物理内存,也不需要所有页都必须在物理内存中。当程序引用到不在物理内存中的页时,硬件触发缺页中断,由操作系统将缺失的页装入物理内存,再重新执行失败的指令。 从上面的描述中可以看出,虚拟内存允许程序不用将地址空间中的每一页都映射到物理内存,也就是说一个程序不需要全部调入内存就可以运行,这使得有限的内存运行大程序成为可能。例如有一台计算机可以产生 16 位地址,那么一个程序的地址空间范围是 0\~64K。该计算机只有 32KB 的物理内存,虚拟内存技术允许该计算机运行一个 64K 大小的程序。 -

+

## 分页系统地址映射 @@ -32,9 +32,13 @@ 一个虚拟地址分成两个部分,一部分存储页面号,一部分存储偏移量。 -下图的页表存放着 16 个页,这 16 个页需要用 4 个比特位来进行索引定位。例如对于虚拟地址(0010 000000000100),前 4 位是存储页面号 2,读取表项内容为(110 1),页表项最后一位表示是否存在于内存中,1 表示存在。后 12 位存储偏移量。这个页对应的页框的地址为 (110 000000000100)。 +下图的页表存放着 16 个页,这 16 个页需要用 4 个比特位来进行索引定位。例如对于虚拟地址 0x3ABC(0011 101010111100),前 4 位是页面号 3,读取表项内容为(101 1),页表项最后一位表示是否存在于内存中,1 表示存在。后 12 位是偏移量,直接拼接到页框号 101 后面,得到物理地址 0x5ABC(101 101010111100)。 -

+

+ +页表存放在内存中,每次访问内存之前都要先查一次页表。CPU 中的快表(Translation Lookaside Buffer, TLB)缓存最近用过的页表项,命中时不用再访问页表。 + +64 位系统的地址空间很大,如果用一张页表覆盖全部地址,页表本身就会非常大,因此使用多级页表,只为用到的地址分配下一级页表。例如 x86-64 通常使用 4 级页表,48 位虚拟地址分为 4 个 9 位的页表索引和 12 位的页内偏移。 ## 页面置换算法 @@ -54,7 +58,7 @@ 举例:一个系统为某进程分配了三个物理块,并有如下页面引用序列: -```html +```text 7,0,1,2,0,3,0,4,2,3,0,3,2,1,2,0,1,7,0,1 ``` @@ -70,11 +74,11 @@ 因为每次访问都需要更新链表,因此这种方式实现的 LRU 代价很高。 -```html +```text 4,7,0,7,1,0,1,2,1,2,6 ``` -

+

### 3. 最近未使用 @@ -105,7 +109,7 @@ FIFO 算法可能会把经常使用的页面置换出去,为了避免这一问 当页面被访问 (读或写) 时设置该页面的 R 位为 1。需要替换的时候,检查最老页面的 R 位。如果 R 位是 0,那么这个页面既老又没有被使用,可以立刻置换掉;如果是 1,就将 R 位清 0,并把该页面放到链表的尾端,修改它的装入时间使它就像刚装入的一样,然后继续从链表的头部开始搜索。 -

+

### 6. 时钟 @@ -113,19 +117,17 @@ FIFO 算法可能会把经常使用的页面置换出去,为了避免这一问 第二次机会算法需要在链表中移动页面,降低了效率。时钟算法使用环形链表将页面连接起来,再使用一个指针指向最老的页面。 -

+

## 分段 虚拟内存采用的是分页技术,也就是将地址空间划分成固定大小的页,每一页再与内存进行映射。 -下图为一个编译器在编译过程中建立的多个表,有 4 个表是动态增长的,如果使用分页系统的一维地址空间,动态增长的特点会导致覆盖问题的出现。 - -

+例如一个程序有代码、全局数据、堆和栈几部分,其中堆和栈会动态增长。如果放在一维的地址空间中,就要预先给每一部分留出位置,某一部分增长到相邻部分的位置时就会发生覆盖。 -分段的做法是把每个表分成段,一个段构成一个独立的地址空间。每个段的长度可以不同,并且可以动态增长。 +分段的做法是把每一部分作为一个段,一个段构成一个独立的地址空间。每个段的长度可以不同,并且可以动态增长。地址由段号和段内偏移组成,通过段表找到段的基址,再加上偏移得到物理地址。 -

+

## 段页式 diff --git "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\246\202\350\277\260.md" "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\246\202\350\277\260.md" index e58db1a67..168bd0c6e 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\246\202\350\277\260.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\246\202\350\277\260.md" @@ -78,7 +78,7 @@ 如果一个进程在用户态需要使用内核态的功能,就进行系统调用从而陷入内核,由操作系统代为完成。 -

+

Linux 的系统调用主要有以下这些: @@ -107,7 +107,7 @@ Linux 的系统调用主要有以下这些: 因为需要频繁地在用户态和核心态之间进行切换,所以会有一定的性能损失。 -

+

## 中断分类 diff --git "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\255\273\351\224\201.md" "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\255\273\351\224\201.md" index 2b81337b1..f7c8ab44a 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\255\273\351\224\201.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \346\255\273\351\224\201.md" @@ -17,12 +17,16 @@ * [1. 安全状态](#1-安全状态) * [2. 单个资源的银行家算法](#2-单个资源的银行家算法) * [3. 多个资源的银行家算法](#3-多个资源的银行家算法) + * [程序中的死锁](#程序中的死锁) + * [1. Java 线程死锁](#1-java-线程死锁) + * [2. MySQL 死锁](#2-mysql-死锁) + * [参考资料](#参考资料) ## 必要条件 -

+

- 互斥:每个资源要么已经分配给了一个进程,要么就是可用的。 - 占有和等待:已经得到了某个资源的进程可以再请求新的资源。 @@ -54,26 +58,26 @@ ### 1. 每种类型一个资源的死锁检测 -

+

上图为资源分配图,其中方框表示资源,圆圈表示进程。资源指向进程表示该资源已经分配给该进程,进程指向资源表示进程请求获取该资源。 -图 a 可以抽取出环,如图 b,它满足了环路等待条件,因此会发生死锁。 +图中 P1、P2、P3 和 R1、R2、R3 构成一个环,满足环路等待条件,因此发生了死锁。 每种类型一个资源的死锁检测算法是通过检测有向图是否存在环来实现,从一个节点出发进行深度优先搜索,对访问过的节点进行标记,如果访问了已经标记的节点,就表示有向图存在环,也就是检测到死锁的发生。 ### 2. 每种类型多个资源的死锁检测 -

+

-上图中,有三个进程四个资源,每个数据代表的含义如下: +上图中,有三个进程三种资源,每个数据代表的含义如下: - E 向量:资源总量 - A 向量:资源剩余量 - C 矩阵:每个进程所拥有的资源数量,每一行都代表一个进程拥有资源的数量 - R 矩阵:每个进程请求的资源数量 -进程 P1 和 P2 所请求的资源都得不到满足,只有进程 P3 可以,让 P3 执行,之后释放 P3 拥有的资源,此时 A = (2 2 2 0)。P2 可以执行,执行后释放 P2 拥有的资源,A = (4 2 2 1) 。P1 也可以执行。所有进程都可以顺利执行,没有死锁。 +进程 P1 和 P3 所请求的资源都得不到满足,只有进程 P2 可以,让 P2 执行,之后释放 P2 拥有的资源,此时 A = (3 1 2)。P1 可以执行,执行后释放 P1 拥有的资源,A = (4 2 2)。P3 也可以执行。所有进程都可以顺利执行,没有死锁。 算法总结如下: @@ -115,9 +119,9 @@ ### 1. 安全状态 -

+

-图 a 的第二列 Has 表示已拥有的资源数,第三列 Max 表示总共需要的资源数,Free 表示还有可以使用的资源数。从图 a 开始出发,先让 B 拥有所需的所有资源(图 b),运行结束后释放 B,此时 Free 变为 5(图 c);接着以同样的方式运行 C 和 A,使得所有进程都能成功运行,因此可以称图 a 所示的状态时安全的。 +图中条形的长度表示进程总共需要的资源数(Max),浅蓝部分表示已拥有的资源数(Has),Free 表示还可以使用的资源数。从图 a 开始出发,先让 B 拥有所需的所有资源,运行结束后释放 B,此时 Free 变为 6(图 b);接着以同样的方式运行 A 和 C,使得所有进程都能成功运行,因此可以称图 a 所示的状态是安全的。 定义:如果没有死锁发生,并且即使所有进程突然请求对资源的最大需求,也仍然存在某种调度次序能够使得每一个进程运行完毕,则称该状态是安全的。 @@ -127,20 +131,96 @@ 一个小城镇的银行家,他向一群客户分别承诺了一定的贷款额度,算法要做的是判断对请求的满足是否会进入不安全状态,如果是,就拒绝请求;否则予以分配。 -

+

-上图 c 为不安全状态,因此算法会拒绝之前的请求,从而避免进入图 c 中的状态。 +上图 b 为不安全状态,因此算法会拒绝 C 的这次申请,从而避免进入图 b 中的状态;图 c 仍然是安全的,可以分配。 ### 3. 多个资源的银行家算法 -

+

-上图中有五个进程,四个资源。左边的图表示已经分配的资源,右边的图表示还需要分配的资源。最右边的 E、P 以及 A 分别表示:总资源、已分配资源以及可用资源,注意这三个为向量,而不是具体数值,例如 A=(1020),表示 4 个资源分别还剩下 1/0/2/0。 +上图中有四个进程,三种资源。Allocation 表示已经分配的资源,Need 表示还需要分配的资源。E 和 Available 分别表示总资源和可用资源,它们都是向量,而不是具体数值,例如 Available = (1 1 2) 表示 3 种资源分别还剩下 1、1、2 个。 检查一个状态是否安全的算法如下: -- 查找右边的矩阵是否存在一行小于等于向量 A。如果不存在这样的行,那么系统将会发生死锁,状态是不安全的。 -- 假若找到这样一行,将该进程标记为终止,并将其已分配资源加到 A 中。 +- 查找 Need 矩阵中是否存在一行小于等于向量 Available。如果不存在这样的行,那么系统将会发生死锁,状态是不安全的。 +- 假若找到这样一行,将该进程标记为终止,并将其已分配资源加到 Available 中。 - 重复以上两步,直到所有进程都标记为终止,则状态是安全的。 如果一个状态不是安全的,需要拒绝进入这个状态。 + +## 程序中的死锁 + +### 1. Java 线程死锁 + +两个线程反向转账时,T1 锁住 alice 再请求 bob,T2 锁住 bob 再请求 alice,就是开头图中的情况: + +```java +static void transfer(Account from, Account to, int amount) { + synchronized (from) { + synchronized (to) { + from.balance -= amount; + to.balance += amount; + } + } +} +``` + +用 jstack 查看进程的线程栈,末尾会直接报告死锁(省略了部分内容): + +```text +Found one Java-level deadlock: +============================= +"T1": + waiting to lock monitor 0x0000000135f26a70 (object 0x000000061fc14e18, a Transfer$Account), + which is held by "T2" + +"T2": + waiting to lock monitor 0x0000000125f06e60 (object 0x000000061fc14dd0, a Transfer$Account), + which is held by "T1" +``` + +解决方法是破坏环路等待:所有线程按同一个顺序加锁,例如总是先锁 id 小的账户。 + +```java +Account first = from.id < to.id ? from : to; +Account second = from.id < to.id ? to : from; +synchronized (first) { + synchronized (second) { + from.balance -= amount; + to.balance += amount; + } +} +``` + +两个线程各反向转账 10 万次,原来的写法每次运行都会卡住,按 id 顺序加锁后都能完成,两个账户的余额仍为 1000。使用 ReentrantLock 时还可以用 tryLock 设置超时,拿不到锁就释放已持有的锁再重试,破坏的是占有和等待条件。 + +### 2. MySQL 死锁 + +事务按不同的顺序更新同一组行时也会死锁。例如两个事务同时反向转账,事务 1 先更新 id = 1,事务 2 先更新 id = 2,之后各自更新对方已经锁住的行: + +```sql +-- 事务 1 +BEGIN; +UPDATE account SET balance = balance - 100 WHERE id = 1; +UPDATE account SET balance = balance + 100 WHERE id = 2; -- 等待事务 2 释放 id = 2 的行锁 + +-- 事务 2 +BEGIN; +UPDATE account SET balance = balance - 50 WHERE id = 2; +UPDATE account SET balance = balance + 50 WHERE id = 1; +-- ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction +``` + +InnoDB 默认开启死锁检测,发现环后立即回滚其中一个事务(倾向于回滚修改行数少的事务),另一个事务继续执行。上例中事务 2 被回滚,事务 1 提交后余额为 900 和 1100。执行 SHOW ENGINE INNODB STATUS,在 LATEST DETECTED DEADLOCK 一节中可以看到两个事务各自持有和等待的锁。被回滚的事务需要由应用重试。 + +减少数据库死锁的方法: + +- 按相同的顺序访问行,例如转账时先更新 id 小的账户; +- 事务尽量短,不在事务中调用外部接口或等待用户操作; +- 为更新的条件列建立索引,避免扫描时锁住过多的行。 + +## 参考资料 + +- Tanenbaum A S, Bos H. Modern Operating Systems [M]. Pearson, 2014. +- [Deadlocks in InnoDB | MySQL 8.0 Reference Manual](https://dev.mysql.com/doc/refman/8.0/en/innodb-deadlocks.html) diff --git "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \347\233\256\345\275\225.md" "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \347\233\256\345\275\225.md" index f30543116..9676b2836 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \347\233\256\345\275\225.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \347\233\256\345\275\225.md" @@ -14,7 +14,7 @@ - Bryant, R. E., & O’Hallaron, D. R. (2004). 深入理解计算机系统. - 史蒂文斯. UNIX 环境高级编程 [M]. 人民邮电出版社, 2014. - [Operating System Notes](https://applied-programming.github.io/Operating-Systems-Notes/) -- [Operating-System Structures](https://www.cs.uic.edu/\~jbell/CourseNotes/OperatingSystems/2_Structures.html) +- [Operating-System Structures](https://www.cs.uic.edu/~jbell/CourseNotes/OperatingSystems/2_Structures.html) - [Processes](http://cse.csusb.edu/tongyu/courses/cs460/notes/process.php) - [Inter Process Communication Presentation[1]](https://www.slideshare.net/rkolahalam/inter-process-communication-presentation1) - [Decoding UCS Invicta – Part 1](https://blogs.cisco.com/datacenter/decoding-ucs-invicta-part-1) diff --git "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\256\276\345\244\207\347\256\241\347\220\206.md" "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\256\276\345\244\207\347\256\241\347\220\206.md" index 987a7c173..830a4b76d 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\256\276\345\244\207\347\256\241\347\220\206.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\256\276\345\244\207\347\256\241\347\220\206.md" @@ -22,6 +22,8 @@ ## 磁盘调度算法 +下面的例子中,磁头当前位于 50 号磁道,按到达顺序有 72、30、95、56、12、81、44 七个请求。先来先服务按这个顺序移动,共移动 318 个磁道。 + 读写一个磁盘块的时间的影响因素有: - 旋转时间(主轴转动盘面,使得磁头移动到适当的扇区上) @@ -46,7 +48,7 @@ 虽然平均寻道时间比较低,但是不够公平。如果新到达的磁道请求总是比一个在等待的磁道请求近,那么在等待的磁道请求会一直等待下去,也就是出现饥饿现象。具体来说,两端的磁道请求更容易出现饥饿现象。 -

+

### 3. 电梯算法 @@ -58,4 +60,4 @@ 因为考虑了移动方向,因此所有的磁盘请求都会被满足,解决了 SSTF 的饥饿问题。 -

+

diff --git "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\277\233\347\250\213\347\256\241\347\220\206.md" "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\277\233\347\250\213\347\256\241\347\220\206.md" index d1cd357e6..aaaf55448 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\277\233\347\250\213\347\256\241\347\220\206.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \350\277\233\347\250\213\347\256\241\347\220\206.md" @@ -6,6 +6,7 @@ * [2. 线程](#2-线程) * [3. 区别](#3-区别) * [4. 协程](#4-协程) + * [5. 上下文切换](#5-上下文切换) * [进程状态的切换](#进程状态的切换) * [进程调度算法](#进程调度算法) * [1. 批处理系统](#1-批处理系统) @@ -26,6 +27,7 @@ * [4. 信号量](#4-信号量) * [5. 共享存储](#5-共享存储) * [6. 套接字](#6-套接字) + * [参考资料](#参考资料) @@ -37,9 +39,9 @@ 进程控制块 (Process Control Block, PCB) 描述进程的基本信息和运行状态,所谓的创建进程和撤销进程,都是指对 PCB 的操作。 -下图显示了 4 个程序创建了 4 个进程,这 4 个进程可以并发地执行。 +下图显示了 4 个进程在一个 CPU 上并发地执行。 -

+

### 2. 线程 @@ -49,7 +51,7 @@ QQ 和浏览器是两个进程,浏览器进程里面有很多线程,例如 HTTP 请求线程、事件响应线程、渲染线程等等,线程的并发执行使得在浏览器中点击一个新链接从而发起 HTTP 请求时,浏览器还可以响应用户的其它事件。 -

+

### 3. 区别 @@ -81,9 +83,23 @@ QQ 和浏览器是两个进程,浏览器进程里面有很多线程,例如 H Java 21 正式引入的虚拟线程([JEP 444](https://openjdk.org/jeps/444))就是 JVM 实现的协程:虚拟线程由 JVM 调度到少量的平台线程上运行,执行阻塞 I/O 时从平台线程上卸载,让平台线程去执行其它虚拟线程。虚拟线程的创建成本很低,不需要用线程池复用,需要限制并发数时使用信号量。在 JDK 21 中,虚拟线程在 synchronized 块内阻塞时无法卸载,JDK 24 起([JEP 491](https://openjdk.org/jeps/491))基本消除了这个限制。 +### 5. 上下文切换 + +上下文切换指的是 CPU 从执行一个线程改为执行另一个线程时,把当前线程的寄存器、程序计数器、栈指针等保存起来,再恢复另一个线程上次保存的值。以下情况会发生上下文切换: + +- 时间片用完,被调度程序换下; +- 线程主动阻塞,例如等待 I/O、等待锁、调用 sleep(); +- 更高优先级的线程进入就绪状态。 + +需要注意的是,系统调用只是从用户态进入内核态,执行完后通常回到同一个线程,不一定发生上下文切换。 + +同一进程中的线程切换不需要换地址空间;切换到另一个进程时还要切换页表,TLB 和 CPU 缓存中原来的地址映射和数据对新进程没有用,要重新加载,这部分间接开销通常比保存寄存器更大。 + +在 Linux 容器中用 taskset 把两个执行流固定在同一个 CPU 上,通过两根管道来回传 1 个字节,让它们交替运行:两个线程之间、两个进程之间每次切换都约 1.1 微秒(包含一次 read 或 write 系统调用)。数据量很小时两者几乎没有差别,进程切换的额外开销主要在工作集较大时体现出来。线程过多、频繁阻塞时,CPU 会把相当一部分时间花在切换上,可以用 vmstat 的 cs 列或 pidstat -w 观察每秒的切换次数。 + ## 进程状态的切换 -

+

- 就绪状态(ready):等待被调度 - 运行状态(running) @@ -131,7 +147,7 @@ Java 21 正式引入的虚拟线程([JEP 444](https://openjdk.org/jeps/444)) - 因为进程切换都要保存进程的信息并且载入新进程的信息,如果时间片太小,会导致进程切换得太频繁,在进程切换上就会花过多时间。 - 而如果时间片过长,那么实时性就不能得到保证。 -

+

**2.2 优先级调度** @@ -149,7 +165,7 @@ Java 21 正式引入的虚拟线程([JEP 444](https://openjdk.org/jeps/444)) 可以将这种调度算法看成是时间片轮转调度算法和优先级调度算法的结合。 -

+

### 3. 实时系统 @@ -323,7 +339,7 @@ end; ### 1. 哲学家进餐问题 -

+

五个哲学家围着一张圆桌,每个哲学家面前放着食物。哲学家的生活有两种交替活动:吃饭以及思考。当一个哲学家吃饭时,需要先拿起自己左右两边的两根筷子,并且一次只能拿起一根筷子。 @@ -568,7 +584,7 @@ int pipe(int fd[2]); - 只支持半双工通信(单向交替传输); - 只能在父子进程或者兄弟进程中使用。 -

+

### 2. FIFO @@ -582,7 +598,7 @@ int mkfifoat(int fd, const char *path, mode_t mode); FIFO 常用于客户-服务器应用程序中,FIFO 用作汇聚点,在客户进程和服务器进程之间传递数据。 -

+

### 3. 消息队列 @@ -607,3 +623,8 @@ FIFO 常用于客户-服务器应用程序中,FIFO 用作汇聚点,在客户 ### 6. 套接字 与其它通信机制不同的是,它可用于不同机器间的进程通信。 + +## 参考资料 + +- Tanenbaum A S, Bos H. Modern Operating Systems [M]. Pearson, 2014. +- [pipe(7) — Linux manual page](https://man7.org/linux/man-pages/man7/pipe.7.html) diff --git "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \351\223\276\346\216\245.md" "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \351\223\276\346\216\245.md" index a06caa1ba..4a86458d8 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \351\223\276\346\216\245.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\346\223\215\344\275\234\347\263\273\347\273\237 - \351\223\276\346\216\245.md" @@ -31,7 +31,7 @@ gcc -o hello hello.c 这个过程大致如下: -

+

- 预处理阶段:处理以 # 开头的预处理命令; - 编译阶段:翻译成汇编文件; @@ -45,7 +45,7 @@ gcc -o hello hello.c - 符号解析:每个符号对应于一个函数、一个全局变量或一个静态变量,符号解析的目的是将每个符号引用与一个符号定义关联起来。 - 重定位:链接器通过把每个符号定义与一个内存位置关联起来,然后修改所有对这些符号的引用,使得它们指向这个内存位置。 -

+

## 目标文件 @@ -65,4 +65,4 @@ gcc -o hello hello.c - 在给定的文件系统中一个库只有一个文件,所有引用该库的可执行目标文件都共享这个文件,它不会被复制到引用它的可执行文件中; - 在内存中,一个共享库的 .text 节(已编译程序的机器代码)的一个副本可以被不同的正在运行的进程共享。 -

+

diff --git "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \345\272\224\347\224\250\345\261\202.md" "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \345\272\224\347\224\250\345\261\202.md" index f23c42796..597df19a2 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \345\272\224\347\224\250\345\261\202.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \345\272\224\347\224\250\345\261\202.md" @@ -15,6 +15,7 @@ * [2. ARP 解析 MAC 地址](#2-arp-解析-mac-地址) * [3. DNS 解析域名](#3-dns-解析域名) * [4. HTTP 请求页面](#4-http-请求页面) + * [参考资料](#参考资料) @@ -24,7 +25,11 @@ DNS 是一个分布式数据库,提供了主机名和 IP 地址之间相互转 域名具有层次结构,从上到下依次为:根域名、顶级域名、二级域名。 -

+以解析 www.example.com 为例:主机先查浏览器缓存、操作系统缓存和 hosts 文件,没有命中就向本地 DNS 服务器查询。本地 DNS 服务器依次询问根服务器、com 顶级域服务器和 example.com 的权威服务器,前两者只返回下一级服务器的地址,权威服务器返回最终的 IP 地址。 + +

+ +主机到本地 DNS 服务器是递归查询,主机只等最终结果;本地 DNS 服务器到其它服务器是迭代查询,由它自己一步步问下去。每一级的结果都按 TTL 缓存,所以大多数查询在本地 DNS 服务器甚至主机上就能得到结果。 DNS 可以使用 UDP 或者 TCP 进行传输,使用的端口号都为 53。大多数情况下 DNS 使用 UDP 进行传输,这就要求域名解析器和域名服务器都必须自己处理超时和重传从而保证可靠性。在两种情况下会使用 TCP 进行传输: @@ -42,11 +47,9 @@ FTP 使用 TCP 进行连接,它需要两个连接来传送一个文件: - 主动模式:服务器端主动建立数据连接,其中服务器端的端口号为 20,客户端的端口号随机,但是必须大于 1024,因为 0\~1023 是熟知端口号。 -

- - 被动模式:客户端主动建立数据连接,其中客户端的端口号由客户端自己指定,服务器端的端口号随机。 -

+

主动模式要求客户端开放端口号给服务器端,需要去配置客户端的防火墙。被动模式只需要服务器端开放端口号即可,无需客户端配置防火墙。但是被动模式会导致服务器端的安全性减弱,因为开放了过多的端口号。 @@ -63,7 +66,7 @@ DHCP 工作过程如下: 3. 如果客户端选择了某个 DHCP 服务器提供的信息,那么就发送 Request 报文给该 DHCP 服务器。 4. DHCP 服务器发送 Ack 报文,表示客户端此时可以使用提供给它的信息。 -

+

## 远程登录协议 @@ -77,13 +80,13 @@ TELNET 可以适应许多计算机和操作系统的差异,例如不同操作 邮件协议包含发送协议和读取协议,发送协议常用 SMTP,读取协议常用 POP3 和 IMAP。 -

+

### 1. SMTP SMTP 只能发送 ASCII 码,而互联网邮件扩充 MIME 可以发送二进制文件。MIME 并没有改动或者取代 SMTP,而是增加邮件主体的结构,定义了非 ASCII 码的编码规则。 -

+

### 2. POP3 @@ -101,14 +104,31 @@ IMAP 协议中客户端和服务器上的邮件保持同步,如果不手动删 | 动态主机配置协议 | DHCP | 67/68 | UDP | | | 简单网络管理协议 | SNMP | 161/162 | UDP | | | 文件传送协议 | FTP | 20/21 | TCP | 控制连接 21,数据连接 20 | +| 安全外壳协议 | SSH | 22 | TCP | | | 远程终端协议 | TELNET | 23 | TCP | | | 超文本传送协议 | HTTP | 80 | TCP | | +| 超文本传送安全协议 | HTTPS | 443 | TCP | HTTP/3 使用 UDP | | 简单邮件传送协议 | SMTP | 25 | TCP | | | 邮件读取协议 | POP3 | 110 | TCP | | | 网际报文存取协议 | IMAP | 143 | TCP | | ## Web 页面请求过程 +在浏览器中输入 https://www.example.com/ 并回车后,主要经过以下步骤: + +1. 浏览器解析 URL,检查缓存,有未过期的缓存时直接使用; +2. DNS 解析域名,得到 IP 地址; +3. 与服务器进行 TCP 三次握手,HTTPS 还要进行 TLS 握手; +4. 发送 HTTP 请求,服务器处理后返回响应; +5. 浏览器解析 HTML,再请求其中引用的 CSS、JavaScript、图片等资源,最后渲染出页面; +6. 连接保持一段时间供后续请求复用,空闲后关闭。 + +以下是本机访问该网址时各阶段的耗时: + +

+ +下面从网络各层的角度,看一台刚接入网络的主机发出这个请求的完整过程。 + ### 1. DHCP 配置主机信息 - 假设主机最开始没有 IP 地址以及其它信息,那么就需要先使用 DHCP 来获取。 @@ -166,3 +186,8 @@ IMAP 协议中客户端和服务器上的邮件保持同步,如果不手动删 - HTTP 服务器从 TCP 套接字读取 HTTP GET 报文,生成一个 HTTP 响应报文,将 Web 页面内容放入报文主体中,发回给主机。 - 浏览器收到 HTTP 响应报文后,抽取出 Web 页面内容,之后进行渲染,显示 Web 页面。 + +## 参考资料 + +- [RFC 1035: Domain Names - Implementation and Specification](https://www.rfc-editor.org/rfc/rfc1035) +- [RFC 2131: Dynamic Host Configuration Protocol](https://www.rfc-editor.org/rfc/rfc2131) diff --git "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \346\246\202\350\277\260.md" "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \346\246\202\350\277\260.md" index 93e271d5f..68ca123b5 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \346\246\202\350\277\260.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \346\246\202\350\277\260.md" @@ -24,7 +24,7 @@ 网络把主机连接起来,而互连网(internet)是把多种不同的网络连接起来,因此互连网是网络的网络。而互联网(Internet)是全球范围的互连网。 -

+

## ISP @@ -76,10 +76,9 @@ 主机或路由器传输数据帧所需要的时间。 - - -

- +```text +传输时延 = 数据帧长度 l(bit)/ 传输速率 v(bit/s) +``` 其中 l 表示数据帧的长度,v 表示传输速率。 @@ -87,11 +86,11 @@ 电磁波在信道中传播所需要花费的时间,电磁波传播的速度接近光速。 - - -

+```text +传播时延 = 信道长度 l(m)/ 电磁波在信道上的传播速度 v(m/s) +``` -其中 l 表示信道长度,v 表示电磁波在信道上的传播速度。 +例如发送一个 1500 字节(12000 bit)的帧:100 Mbit/s 的链路上传输时延为 12000 / 108 = 0.12 ms;光纤中信号的传播速度约为 2 × 10⁸ m/s,北京到广州约 2000 km 的线路传播时延约为 10 ms。传输时延取决于数据量和带宽,传播时延只取决于距离,提高带宽不能缩短传播时延。 ## 计算机网络体系结构 diff --git "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\211\251\347\220\206\345\261\202.md" "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\211\251\347\220\206\345\261\202.md" index 2a10290f4..b751e3962 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\211\251\347\220\206\345\261\202.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\211\251\347\220\206\345\261\202.md" @@ -18,5 +18,9 @@ 模拟信号是连续的信号,数字信号是离散的信号。带通调制把数字信号转换为模拟信号。 -

+基本的调制方法有调幅、调频和调相三种,分别用载波的振幅、频率和相位的变化来表示 0 和 1: + +

+ +实际的系统中还会把振幅和相位组合起来使用,例如正交振幅调制(Quadrature Amplitude Modulation, QAM)用 16 种不同的振幅和相位组合表示 4 个比特,一个码元就能传输更多的数据。 diff --git "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\233\256\345\275\225.md" "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\233\256\345\275\225.md" index 2b049dbdc..408545dcb 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\233\256\345\275\225.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \347\233\256\345\275\225.md" @@ -19,8 +19,8 @@ - [How DHCP works and DHCP Interview Questions and Answers](http://webcache.googleusercontent.com/search?q=cache:http://anandgiria.blogspot.com/2013/09/windows-dhcp-interview-questions-and.html) - [What is process of DORA in DHCP?](https://www.quora.com/What-is-process-of-DORA-in-DHCP) - [What is DHCP Server ?](https://tecadmin.net/what-is-dhcp-server/) -- [Tackling emissions targets in Tokyo](http://www.climatechangenews.com/2011/html/university-tokyo.html) -- [What does my ISP know when I use Tor?](http://www.climatechangenews.com/2011/html/university-tokyo.html) +- [Tackling emissions targets in Tokyo](https://web.archive.org/web/20240229221541/https://www.climatechangenews.com/2011/html/university-tokyo.html) +- [What does my ISP know when I use Tor?](https://web.archive.org/web/20240229221541/https://www.climatechangenews.com/2011/html/university-tokyo.html) - [Technology-Computer Networking[1]-Computer Networks and the Internet](http://www.linyibin.cn/2017/02/12/technology-ComputerNetworking-Internet/) -- [P2P 网络概述.](http://slidesplayer.com/slide/11616167/) -- [Circuit Switching (a) Circuit switching. (b) Packet switching.](http://slideplayer.com/slide/5115386/) +- [P2P 网络概述.](https://web.archive.org/web/20250523115153/https://slidesplayer.com/slide/11616167/) +- [Circuit Switching (a) Circuit switching. (b) Packet switching.](https://web.archive.org/web/20250417034244/http://slideplayer.com/slide/5115386/) diff --git "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \351\223\276\350\267\257\345\261\202.md" "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \351\223\276\350\267\257\345\261\202.md" index c2645caa3..641f8f7a2 100644 --- "a/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \351\223\276\350\267\257\345\261\202.md" +++ "b/notes/\350\256\241\347\256\227\346\234\272\347\275\221\347\273\234 - \351\223\276\350\267\257\345\261\202.md" @@ -88,13 +88,13 @@ ### 5. 码分复用 -为每个用户分配 m bit 的码片,并且所有的码片正交,对于任意两个码片 和 有 +为每个用户分配 m bit 的码片,并且所有的码片正交,对于任意两个码片 S 和 T 有

-为了讨论方便,取 m=8,设码片 为 00011011。在拥有该码片的用户发送比特 1 时就发送该码片,发送比特 0 时就发送该码片的反码 11100100。 +为了讨论方便,取 m=8,设码片 S 为 00011011。在拥有该码片的用户发送比特 1 时就发送该码片,发送比特 0 时就发送该码片的反码 11100100。 在计算时将 00011011 记作 (-1 -1 -1 +1 +1 -1 +1 +1),可以得到 @@ -106,9 +106,9 @@

-其中 为 的反码。 +其中 S' 为 S 的反码。 -利用上面的式子我们知道,当接收端使用码片 对接收到的数据进行内积运算时,结果为 0 的是其它用户发送的数据,结果为 1 的是用户发送的比特 1,结果为 -1 的是用户发送的比特 0。 +利用上面的式子我们知道,当接收端使用码片 S 对接收到的数据进行内积运算时,结果为 0 的是其它用户发送的数据,结果为 1 的是用户发送的比特 1,结果为 -1 的是用户发送的比特 0。 码分复用需要发送的数据量为原先的 m 倍。 diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \344\270\255\344\273\213\350\200\205.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \344\270\255\344\273\213\350\200\205.md" index 4cbd06cae..548f30954 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \344\270\255\344\273\213\350\200\205.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \344\270\255\344\273\213\350\200\205.md" @@ -17,11 +17,11 @@ Alarm(闹钟)、CoffeePot(咖啡壶)、Calendar(日历)、Sprinkler(喷头)是一组相关的对象,在某个对象的事件产生时需要去操作其它对象,形成了下面这种依赖结构: -

+

使用中介者模式可以将复杂的依赖结构变成星形结构: -

+

```java public abstract class Colleague { diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\221\275\344\273\244.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\221\275\344\273\244.md" index 2846cdbd9..a5fea7fee 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\221\275\344\273\244.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\221\275\344\273\244.md" @@ -22,7 +22,7 @@ 设计一个遥控器,可以控制电灯开关。 -

+

```java public interface Command { diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\244\226\350\247\202.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\244\226\350\247\202.md" index a503dcdf7..517bd78a1 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\244\226\350\247\202.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\244\226\350\247\202.md" @@ -6,7 +6,7 @@ ### Class Diagram -

+

### Implementation diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\267\245\345\216\202\346\226\271\346\263\225.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\267\245\345\216\202\346\226\271\346\263\225.md" index d5c57014f..acbc9875e 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\267\245\345\216\202\346\226\271\346\263\225.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \345\267\245\345\216\202\346\226\271\346\263\225.md" @@ -53,7 +53,7 @@ public class ConcreteFactory2 extends Factory { - [java.util.Calendar](http://docs.oracle.com/javase/8/docs/api/java/util/Calendar.html#getInstance--) - [java.util.ResourceBundle](http://docs.oracle.com/javase/8/docs/api/java/util/ResourceBundle.html#getBundle-java.lang.String-) - [java.text.NumberFormat](http://docs.oracle.com/javase/8/docs/api/java/text/NumberFormat.html#getInstance--) -- [java.nio.charset.Charset](http://docs.oracle.com/javase/8/docs/api/java/nio/charset/Charset.html#forName-java.lang.String-) +- [java.nio.charset.Charset](https://docs.oracle.com/javase/8/docs/api/java/nio/charset/Charset.html#forName-java.lang.String-) - [java.net.URLStreamHandlerFactory](http://docs.oracle.com/javase/8/docs/api/java/net/URLStreamHandlerFactory.html#createURLStreamHandler-java.lang.String-) - [java.util.EnumSet](https://docs.oracle.com/javase/8/docs/api/java/util/EnumSet.html#of-E-) - [javax.xml.bind.JAXBContext](https://docs.oracle.com/javase/8/docs/api/javax/xml/bind/JAXBContext.html#createMarshaller--) diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \346\250\241\346\235\277\346\226\271\346\263\225.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \346\250\241\346\235\277\346\226\271\346\263\225.md" index a6eddea46..3bfd0fdd0 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \346\250\241\346\235\277\346\226\271\346\263\225.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \346\250\241\346\235\277\346\226\271\346\263\225.md" @@ -14,7 +14,7 @@ 冲咖啡和冲茶都有类似的流程,但是某些步骤会有点不一样,要求复用那些相同步骤的代码。 -

+

```java public abstract class CaffeineBeverage { diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \347\212\266\346\200\201.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \347\212\266\346\200\201.md" index 42a30bd83..3fac013b9 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \347\212\266\346\200\201.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \347\212\266\346\200\201.md" @@ -12,7 +12,7 @@ 糖果销售机有多种状态,每种状态下销售机有不同的行为,状态可以发生转移,使得销售机的行为也发生改变。 -

+

```java public interface State { diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\243\205\351\245\260.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\243\205\351\245\260.md" index cf9529249..f26318d04 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\243\205\351\245\260.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\243\205\351\245\260.md" @@ -14,9 +14,9 @@ 设计不同种类的饮料,饮料可以添加配料,比如可以添加牛奶,并且支持动态添加新配料。每增加一种配料,该饮料的价格就会增加,要求计算一种饮料的价格。 -下图表示在 DarkRoast 饮料上新增新添加 Mocha 配料,之后又添加了 Whip 配料。DarkRoast 被 Mocha 包裹,Mocha 又被 Whip 包裹。它们都继承自相同父类,都有 cost() 方法,外层类的 cost() 方法调用了内层类的 cost() 方法。 +下图对应后面的代码:HouseBlend 饮料先被 Mocha 包裹,Mocha 又被 Milk 包裹。它们都继承自相同父类,都有 cost() 方法,外层类的 cost() 方法调用了内层类的 cost() 方法。 -

+

```java public interface Beverage { diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\247\202\345\257\237\350\200\205.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\247\202\345\257\237\350\200\205.md" index 141c513ca..4cc5f65fe 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\247\202\345\257\237\350\200\205.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\247\202\345\257\237\350\200\205.md" @@ -6,7 +6,7 @@ 主题(Subject)是被观察的对象,而其所有依赖者(Observer)称为观察者。 -

+

### Class Diagram @@ -20,7 +20,7 @@ 天气数据布告板会在天气信息发生改变时更新其内容,布告板有多个,并且在将来会继续增加。 -

+

```java public interface Subject { diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\264\243\344\273\273\351\223\276.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\264\243\344\273\273\351\223\276.md" index c652e334d..c6bd0f172 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\264\243\344\273\273\351\223\276.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \350\264\243\344\273\273\351\223\276.md" @@ -125,5 +125,5 @@ request2 is handle by ConcreteHandler2 ### JDK - [java.util.logging.Logger#log()](http://docs.oracle.com/javase/8/docs/api/java/util/logging/Logger.html#log%28java.util.logging.Level,%20java.lang.String%29) -- [Apache Commons Chain](https://commons.apache.org/proper/commons-chain/index.html) +- [Apache Commons Chain](https://commons.apache.org/dormant/commons-chain/) - [javax.servlet.Filter#doFilter()](http://docs.oracle.com/javaee/7/api/javax/servlet/Filter.html#doFilter-javax.servlet.ServletRequest-javax.servlet.ServletResponse-javax.servlet.FilterChain-) diff --git "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \351\200\202\351\205\215\345\231\250.md" "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \351\200\202\351\205\215\345\231\250.md" index 72eb98cd2..f2d14a7eb 100644 --- "a/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \351\200\202\351\205\215\345\231\250.md" +++ "b/notes/\350\256\276\350\256\241\346\250\241\345\274\217 - \351\200\202\351\205\215\345\231\250.md" @@ -4,7 +4,7 @@ 把一个类接口转换成另一个用户需要的接口。 -

+

### Class Diagram diff --git "a/notes/\351\233\206\347\276\244.md" "b/notes/\351\233\206\347\276\244.md" index df93c17c6..0a0125ce0 100644 --- "a/notes/\351\233\206\347\276\244.md" +++ "b/notes/\351\233\206\347\276\244.md" @@ -45,14 +45,14 @@ 轮询算法把每个请求轮流发送到每个服务器上。 -下图中,一共有 6 个客户端产生了 6 个请求,这 6 个请求按 (1, 2, 3, 4, 5, 6) 的顺序发送。(1, 3, 5) 的请求会被发送到服务器 1,(2, 4, 6) 的请求会被发送到服务器 2。 +下图中,6 个请求按 (1, 2, 3, 4, 5, 6) 的顺序到达。(1, 3, 5) 的请求会被发送到服务器 1,(2, 4, 6) 的请求会被发送到服务器 2。 -

+

该算法比较适合每个服务器的性能差不多的场景,如果有性能存在差异的情况下,那么性能较差的服务器可能无法承担过大的负载(下图的 Server 2)。 -

+

#### 2. 加权轮询(Weighted Round Robin) @@ -60,9 +60,9 @@ 例如下图中,服务器 1 被赋予的权值为 5,服务器 2 被赋予的权值为 1,那么 (1, 2, 3, 4, 5) 请求会被发送到服务器 1,(6) 请求会被发送到服务器 2。 -

+

-实际实现(例如 Nginx 的平滑加权轮询)会把请求交错发送,避免连续的请求集中到同一台服务器上。 +实际实现(例如 Nginx 的平滑加权轮询)会把请求交错发送,避免连续的请求集中到同一台服务器上,上图最后一行是按 Nginx 源码中的算法计算出的顺序。 #### 3. 最少连接(Least Connections) @@ -70,13 +70,13 @@ 例如下图中,(1, 3, 5) 请求会被发送到服务器 1,但是 (1, 3) 很快就断开连接,此时只有 (5) 请求连接服务器 1;(2, 4, 6) 请求被发送到服务器 2,只有 (2) 的连接断开,此时 (6, 4) 请求连接服务器 2。该系统继续运行时,服务器 2 会承担过大的负载。 -

+

最少连接算法就是将请求发送给当前最少连接数的服务器上。 例如下图中,服务器 1 当前连接数最小,那么新到来的请求 6 就会被发送到服务器 1 上。 -

+

#### 4. 加权最少连接(Weighted Least Connection) @@ -88,7 +88,7 @@ 和轮询算法类似,该算法比较适合服务器性能差不多的场景。 -

+

#### 6. 源地址哈希法 (IP Hash) @@ -96,9 +96,9 @@ 可以保证同一 IP 的客户端的请求会转发到同一台服务器上,用来实现会话粘滞(Sticky Session)。 -

+

-缺点是同一出口 IP 后面的大量用户会落到同一台服务器上,造成负载不均;服务器数量变化时取模结果会全部改变,可以改用一致性哈希。 +缺点是同一出口 IP 后面的大量用户会落到同一台服务器上,造成负载不均;服务器数量变化时大部分客户端的取模结果都会改变,可以改用一致性哈希。需要注意的是,Nginx 的 ip_hash 只用 IPv4 地址的前 3 个字节计算哈希,同一个 /24 网段的客户端都会落到同一台服务器上。 ### 转发实现 @@ -113,7 +113,7 @@ HTTP 重定向负载均衡服务器使用某种负载均衡算法计算得到服 该负载均衡转发的缺点比较明显,实际场景中很少使用它。 -

+

#### 2. DNS 域名解析 @@ -129,7 +129,7 @@ HTTP 重定向负载均衡服务器使用某种负载均衡算法计算得到服 大型网站基本使用了 DNS 作为第一级负载均衡手段,然后在内部使用其它方式做第二级负载均衡。也就是说,域名解析的结果为内部的负载均衡服务器 IP 地址。 -

+

#### 3. 反向代理服务器 @@ -174,7 +174,9 @@ HTTP 重定向负载均衡服务器使用某种负载均衡算法计算得到服 参考: - [Comparing Load Balancing Algorithms](http://www.jscape.com/blog/load-balancing-algorithms) -- [Redirection and Load Balancing](http://slideplayer.com/slide/6599069/#) +- [Nginx: ngx_http_upstream_module](https://nginx.org/en/docs/http/ngx_http_upstream_module.html) +- [Nginx 源码:ngx_http_upstream_round_robin.c](https://github.com/nginx/nginx/blob/master/src/http/ngx_http_upstream_round_robin.c) +- [Redirection and Load Balancing](https://web.archive.org/web/20250420002753/http://slideplayer.com/slide/6599069/) ## 二、集群下的 Session 管理 @@ -229,5 +231,5 @@ HTTP 重定向负载均衡服务器使用某种负载均衡算法计算得到服 参考: -- [Session Management using Spring Session with JDBC DataStore](https://sivalabs.in/2018/02/session-management-using-spring-session-jdbc-datastore/) +- [Session Management using Spring Session with JDBC DataStore](https://web.archive.org/web/20230602191402/https://www.sivalabs.in/2018/02/session-management-using-spring-session-jdbc-datastore/) diff --git "a/notes/\351\235\242\345\220\221\345\257\271\350\261\241\346\200\235\346\203\263.md" "b/notes/\351\235\242\345\220\221\345\257\271\350\261\241\346\200\235\346\203\263.md" index 2da3af943..ecd8406b8 100644 --- "a/notes/\351\235\242\345\220\221\345\257\271\350\261\241\346\200\235\346\203\263.md" +++ "b/notes/\351\235\242\345\220\221\345\257\271\350\261\241\346\200\235\346\203\263.md" @@ -369,4 +369,4 @@ Vihicle .. N - [面向对象设计的 SOLID 原则](http://www.cnblogs.com/shanyou/archive/2009/09/21/1570716.html) - [看懂 UML 类图和时序图](http://design-patterns.readthedocs.io/zh_CN/latest/read_uml.html#generalization) - [UML 系列——时序图(顺序图)sequence diagram](http://www.cnblogs.com/wolf-sun/p/UML-Sequence-diagram.html) -- [面向对象编程三大特性 ------ 封装、继承、多态](http://blog.csdn.net/jianyuerensheng/article/details/51602015) +- [面向对象编程三大特性 ------ 封装、继承、多态](https://web.archive.org/web/20260112143923/https://blog.csdn.net/jianyuerensheng/article/details/51602015) diff --git "a/notes/\351\235\242\350\257\225\351\253\230\351\242\221\351\227\256\351\242\230.md" "b/notes/\351\235\242\350\257\225\351\253\230\351\242\221\351\227\256\351\242\230.md" new file mode 100644 index 000000000..fa7e26c11 --- /dev/null +++ "b/notes/\351\235\242\350\257\225\351\253\230\351\242\221\351\227\256\351\242\230.md" @@ -0,0 +1,215 @@ +# 面试高频问题 + +* [面试高频问题](#面试高频问题) + * [后端](#后端) + * [Redis](#redis) + * [MySQL](#mysql) + * [Java 容器](#java-容器) + * [Java 并发](#java-并发) + * [系统设计](#系统设计) + * [网络](#网络) + * [设计模式](#设计模式) + * [JVM](#jvm) + * [分布式](#分布式) + * [操作系统](#操作系统) + * [大模型](#大模型) + * [Spring](#spring) + * [消息队列](#消息队列) + * [Java 基础](#java-基础) + * [工具](#工具) + * [AI 应用](#ai-应用) + + + +以下是后端和 AI 应用岗位面试中最常被问到的问题,同一类中按出现的频率从高到低排列,每一项都链接到笔记中讲解它的章节。 + +## 后端 + +### Redis + +- [分布式锁](分布式.md#一分布式锁) +- [缓存穿透、击穿与雪崩](缓存.md#四缓存问题) +- [Redis 底层结构与跳表](Redis.md#对象编码) +- [Redis 数据类型](Redis.md#二数据类型) +- [缓存与数据库一致性](缓存.md#缓存一致性) +- [Redis 持久化](Redis.md#八持久化) +- [Redis 集群、哨兵与主从](Redis.md#redis-cluster) +- [Lua 脚本与原子性](Redis.md#lua-脚本) +- [Redis 使用场景](Redis.md#四使用场景) +- [大 Key 与热 Key](缓存.md#大-key-与热-key) +- [本地缓存与多级缓存](缓存.md#多级缓存) +- [布隆过滤器](缓存.md#缓存穿透) +- [手写 LRU](缓存.md#七lru) +- [Redis 为什么快与线程模型](Redis.md#单线程为什么快) +- [过期删除与内存淘汰](Redis.md#七数据淘汰策略) +- [为什么用 Redis](Redis.md#一概述) + +### MySQL + +- [慢查询与 SQL 优化](MySQL.md#二查询性能优化) +- [索引结构与 B+ 树](MySQL.md#b-tree-原理) +- [隔离级别](数据库系统原理.md#四隔离级别) +- [MVCC](数据库系统原理.md#五多版本并发控制) +- [聚簇索引、回表与覆盖索引](MySQL.md#mysql-索引) +- [索引失效](MySQL.md#索引失效) +- [redo log、undo log 与 binlog](MySQL.md#七日志) +- [索引分类与建索引的原则](MySQL.md#索引的使用条件) +- [联合索引与最左前缀](MySQL.md#索引优化) +- [分库分表](MySQL.md#五切分) +- [MySQL 的锁](数据库系统原理.md#三封锁) +- [脏读、不可重复读与幻读](数据库系统原理.md#二并发一致性问题) +- [存储引擎](MySQL.md#三存储引擎) +- [事务 ACID](数据库系统原理.md#acid) +- [主从复制与读写分离](MySQL.md#六复制) +- [EXPLAIN 执行计划](MySQL.md#使用-explain-进行分析) +- [事务的实现原理](数据库系统原理.md#acid) + +### Java 容器 + +- [HashMap 原理](Java%20容器.md#hashmap) +- [ConcurrentHashMap](Java%20容器.md#concurrenthashmap) +- [ArrayList 与 LinkedList](Java%20容器.md#arraylist) +- [集合框架与线程安全的集合](Java%20容器.md#一概览) + +### Java 并发 + +- [线程池参数](Java%20并发.md#threadpoolexecutor) +- [线程池(泛问与使用)](Java%20并发.md#threadpoolexecutor) +- [CAS 与 ABA](Java%20并发.md#非阻塞同步) +- [线程安全怎么保证](Java%20并发.md#十一线程安全) +- [volatile](Java%20并发.md#内存模型三大特性) +- [乐观锁与悲观锁](Java%20并发.md#4-乐观锁与悲观锁) +- [拒绝策略](Java%20并发.md#threadpoolexecutor) +- [线程池执行流程](Java%20并发.md#threadpoolexecutor) +- [线程数怎么设置](Java%20并发.md#threadpoolexecutor) +- [synchronized 原理与锁升级](Java%20并发.md#轻量级锁) +- [ThreadLocal](Java%20并发.md#无同步方案) +- [创建线程的方式](Java%20并发.md#一使用线程) +- [ReentrantLock 与公平锁](Java%20并发.md#七juc---aqs) +- [Java 内存模型](Java%20并发.md#十java-内存模型) + +### 系统设计 + +- [秒杀与超卖](系统设计基础.md#六秒杀系统) + +### 网络 + +- [TCP 三次握手与四次挥手](计算机网络%20-%20传输层.md#tcp-的三次握手) +- [TCP 与 UDP 的区别](计算机网络%20-%20传输层.md#udp-和-tcp-的特点) +- [HTTPS 加密与 TLS 握手](HTTP.md#tls-握手) +- [HTTP 与 HTTPS](HTTP.md#六https) +- [IO 多路复用](Socket.md#二io-复用) +- [RPC](分布式.md#七rpc) +- [拥塞控制与流量控制](计算机网络%20-%20传输层.md#tcp-拥塞控制) +- [输入 URL 的过程](计算机网络%20-%20应用层.md#web-页面请求过程) +- [TCP 可靠传输](计算机网络%20-%20传输层.md#tcp-可靠传输) +- [WebSocket 与 SSE](HTTP.md#websocket) +- [TIME_WAIT 与 CLOSE_WAIT](计算机网络%20-%20传输层.md#tcp-的四次挥手) +- [HTTP 版本](HTTP.md#http3) +- [Cookie、Session 与 Token](HTTP.md#cookie) + +### 设计模式 + +- [常用设计模式](设计模式%20-%20目录.md#一前言) +- [单例模式](设计模式%20%20-%20单例.md#单例singleton) + +### JVM + +- [OOM 与内存泄漏排查](Java%20虚拟机.md#内存溢出与内存泄漏) +- [垃圾收集器 CMS、G1](Java%20虚拟机.md#垃圾收集器) +- [垃圾回收机制(泛问)](Java%20虚拟机.md#二垃圾收集) +- [JVM 内存区域](Java%20虚拟机.md#一运行时数据区域) +- [垃圾回收算法](Java%20虚拟机.md#垃圾收集算法) +- [CPU 占用过高排查](Java%20虚拟机.md#cpu-占用过高) +- [双亲委派](Java%20虚拟机.md#双亲委派模型) +- [JVM 调优与参数](Java%20虚拟机.md#jvm-调优) + +### 分布式 + +- [限流算法](系统设计基础.md#限流降级与熔断) +- [微服务架构与 Spring Cloud](微服务.md#二spring-cloud) +- [分布式事务](分布式.md#二分布式事务) +- [注册中心与服务发现](分布式.md#服务发现) +- [幂等](分布式.md#九幂等) +- [熔断与降级](系统设计基础.md#限流降级与熔断) +- [负载均衡](集群.md#一负载均衡) +- [分布式 ID](分布式.md#八分布式-id) + +### 操作系统 + +- [协程与虚拟线程](计算机操作系统%20-%20进程管理.md#4-协程) +- [进程与线程的区别](计算机操作系统%20-%20进程管理.md#3-区别) +- [死锁](计算机操作系统%20-%20死锁.md#必要条件) +- [虚拟内存与分页](计算机操作系统%20-%20内存管理.md#虚拟内存) +- [Linux 常用命令](Linux.md#十一线上问题排查) +- [进程间通信](计算机操作系统%20-%20进程管理.md#进程通信) +- [用户态与内核态](计算机操作系统%20-%20概述.md#系统调用) + +### 大模型 + +- [AI 编程工具的使用](大模型应用.md#ai-编程助手) +- [RAG 流程](大模型应用.md#三检索增强生成) +- [ReAct 与规划](大模型应用.md#规划) +- [MCP](大模型应用.md#mcp) +- [Agent 的概念与组成](大模型应用.md#agent-是什么) +- [Agent 的记忆](大模型应用.md#记忆) +- [开发框架](大模型应用.md#开发框架) +- [混合检索与重排](大模型应用.md#混合检索) +- [提示词](大模型应用.md#提示词) +- [Embedding 与向量检索](大模型应用.md#embedding-与相似度) +- [Skills](大模型应用.md#skills) + +### Spring + +- [AOP](Spring.md#二aop) +- [Bean 的生命周期](Spring.md#bean-的生命周期) +- [Spring Boot 自动配置](Spring.md#四spring-boot-自动配置) +- [Spring MVC 流程](Spring.md#请求的处理过程) +- [循环依赖与三级缓存](Spring.md#循环依赖) +- [MyBatis](Spring.md#六mybatis) +- [常用注解](Spring.md#ioc-与依赖注入) + +### 消息队列 + +- [消息丢失](消息队列.md#三可靠性) +- [消息队列的作用与选型](消息队列.md#二使用场景) +- [重复消费](消息队列.md#接收端的可靠性) +- [消息积压](消息队列.md#五消息堆积) +- [延迟消息与事务消息](消息队列.md#六延迟消息与死信队列) + +### Java 基础 + +- [面向对象与多态](面向对象思想.md#一三大特性) +- [Java 新特性](Java%20基础.md#java-各版本的新特性) +- [final 与 static](Java%20基础.md#四关键字) +- [反射](Java%20基础.md#七反射) +- [动态代理](Spring.md#动态代理) + +### 工具 + +- [Docker 与 K8s](Docker.md#七kubernetes) + +## AI 应用 + +- [RAG 流程](大模型应用.md#三检索增强生成) +- [Agent 的概念与组成](大模型应用.md#agent-是什么) +- [AI 编程工具的使用](大模型应用.md#ai-编程助手) +- [Agent 的记忆](大模型应用.md#记忆) +- [工具调用](大模型应用.md#工具调用) +- [Skills](大模型应用.md#skills) +- [ReAct 与规划](大模型应用.md#规划) +- [开发框架](大模型应用.md#开发框架) +- [上下文管理](大模型应用.md#上下文工程) +- [MCP](大模型应用.md#mcp) +- [提示词](大模型应用.md#提示词) +- [Embedding 与向量检索](大模型应用.md#embedding-与相似度) +- [多 Agent](大模型应用.md#多-agent) +- [微调与 LoRA](大模型应用.md#微调) +- [幻觉](大模型应用.md#幻觉) +- [混合检索与重排](大模型应用.md#混合检索) +- [RAG 评测与优化](大模型应用.md#评测与优化) +- [Transformer 与注意力](大模型应用.md#注意力机制) +- [切片策略](大模型应用.md#切片) +- [Agent Harness](大模型应用.md#harness) +- [RLHF 与 DPO](大模型应用.md#训练过程) +- [工作流与 Agent](大模型应用.md#agent-与工作流) diff --git a/tools/diagram/src/acid.svg b/tools/diagram/src/acid.svg new file mode 100644 index 000000000..e42274994 --- /dev/null +++ b/tools/diagram/src/acid.svg @@ -0,0 +1,58 @@ + + + + + + + + + + + + + + + + ACID:原子性、隔离性、持久性是手段,一致性是目的 + + 原子性 + undo log 回滚 + + 隔离性 + 锁和 MVCC + + 持久性 + redo log 刷盘 + + 一致性 + 满足约束和业务规则 + + + 没有并发时 + 有并发时还需要 + + 事务的结果正确 + + + 系统崩溃后 + 已提交的修改不丢失 + + 例如转账:原子性保证不会只扣款不入账,隔离性保证并发的转账互不干扰,持久性保证提交之后断电也不丢。 + diff --git a/tools/diagram/src/adapter-turkey.svg b/tools/diagram/src/adapter-turkey.svg new file mode 100644 index 000000000..91d93d1c3 --- /dev/null +++ b/tools/diagram/src/adapter-turkey.svg @@ -0,0 +1,52 @@ + + + + + + + + + + + + + + + + 适配器:让火鸡冒充鸭子 + + 客户端 + 只认 Duck 接口 + + quack() + + TurkeyAdapter + + implements Duck + quack() → gobble() + + gobble() + + WildTurkey + + gobble() + 输出 gobble! + 适配器实现客户端需要的接口,内部持有被适配的对象,把调用转换过去;两边的代码都不用修改。 + diff --git a/tools/diagram/src/cdn.svg b/tools/diagram/src/cdn.svg new file mode 100644 index 000000000..8df0e3561 --- /dev/null +++ b/tools/diagram/src/cdn.svg @@ -0,0 +1,75 @@ + + + + + + + + + + + + + + + + CDN:用户访问离自己最近的节点 + + + 杭州的用户 + + + + + + + DNS 调度 + 返回杭州节点的 IP + + + + + + + + + + CDN 杭州节点 + 缓存了 logo.png + + + + + + + + + + 源站(北京) + + ① 解析 img.example.com + + ② 请求 logo.png + + ③ 未命中时回源,取回后缓存 + + ④ 返回,命中时不经过源站 + 静态资源由离用户最近的节点返回,延迟低,源站的带宽压力也小;资源更新后要刷新 CDN 缓存,或者在文件名中带上版本号。 + diff --git a/tools/diagram/src/cert-chain.svg b/tools/diagram/src/cert-chain.svg new file mode 100644 index 000000000..fbcda6c8d --- /dev/null +++ b/tools/diagram/src/cert-chain.svg @@ -0,0 +1,58 @@ + + + + + + + + + + + + + + + + 证书链:www.baidu.com 的证书如何被信任 + + 服务器证书 + baidu.com + 公钥:RSA 2048 位 + 有效期 2026-07-09 ~ 2027-01-24 + + + + 中间证书 + GlobalSign RSA OV SSL CA 2018 + 由根证书签名 + 随服务器证书一起发送 + + + + 根证书 + GlobalSign Root R3 + 自签名 + 预装在操作系统的信任列表中 + 用中间证书的公钥验证服务器证书的签名 + 用根证书的公钥验证中间证书 + 浏览器还要检查:访问的域名 www.baidu.com 与证书中的域名匹配(Subject Alternative Name 中有 *.baidu.com), + 证书在有效期内且没有被吊销。任何一步失败都会提示“连接不是私密连接”。 + 证书和签名是公开的,伪造者拿不到 CA 的私钥,就无法为自己的公钥生成有效签名。 + diff --git a/tools/diagram/src/clock.svg b/tools/diagram/src/clock.svg new file mode 100644 index 000000000..fbbe6153e --- /dev/null +++ b/tools/diagram/src/clock.svg @@ -0,0 +1,61 @@ + + + + + + + + + + + + + + + + 时钟算法:用环形链表代替移动页面 + + A R=1 + + B R=0 + + C R=1 + + D R=1 + + E R=0 + + F R=1 + + G R=0 + + H R=1 + + + 指针 + 发生缺页时,从指针处开始检查: + C 的 R = 1:清零,指针前进 + D 的 R = 1:清零,指针前进 + E 的 R = 0:换出 E,新页面放在这里, + 指针指向 F + 效果与第二次机会相同,但只移动指针, + 不用在链表中移动页面。 + 图中灰色的 C、D 在这次检查中被清零;淡紫色的 E 被换出。 + diff --git a/tools/diagram/src/coding-agent.svg b/tools/diagram/src/coding-agent.svg new file mode 100644 index 000000000..108cfbb8c --- /dev/null +++ b/tools/diagram/src/coding-agent.svg @@ -0,0 +1,82 @@ + + + + + + + + + + + + + + + + AI 编程助手修复一个失败的测试(示意) + + + 开发者 + + “OrderServiceTest 挂了,修一下” + 收集上下文 + + Bash + + mvn test → 1 个测试失败:期望 59.9,实际 0.0 + + Grep + + grep -rn "calcAmount" src/ → OrderService.java:42 + + + Read + + 读取 OrderService.java 第 30~60 行 + + 修改 + + Edit + + 把 discount 为 null 时的分支改为按原价计算 + + 验证 + + Bash + + mvn test → 全部通过 + + + 失败就 + 继续循环 + 每一步都是一次模型调用:模型选择工具,应用执行后把输出放回上下文。 + 上下文中有什么 + + 系统提示词、工具定义 + + CLAUDE.md 等项目约定 + + 对话和每次工具的输出 + + 接近上限时压缩为摘要 + 子 Agent 在自己的上下文中 + 搜索大量文件,只返回结论 + 修改文件前自动保存快照,可以撤销;执行命令、修改文件前按权限设置决定是否请求开发者确认。 + diff --git a/tools/diagram/src/command-remote.svg b/tools/diagram/src/command-remote.svg new file mode 100644 index 000000000..369780ef7 --- /dev/null +++ b/tools/diagram/src/command-remote.svg @@ -0,0 +1,71 @@ + + + + + + + + + + + + + + + + 命令:遥控器只认 Command 接口 + + Invoker(遥控器) + + on[0] + + off[0] + + on[1] + + off[1] + + on[2] + + off[2] + + on[3] + + off[3] + + LightOnCommand + + execute() { light.on(); } + + LightOffCommand + + execute() { light.off(); } + + Light(接收者) + + on() + off() + + + + + + onButtonWasPushed(0) 只调用 onCommands[0].execute(),不知道背后是电灯还是空调;换一个命令对象,按钮就有了新功能。 + diff --git a/tools/diagram/src/compile-pipeline.svg b/tools/diagram/src/compile-pipeline.svg new file mode 100644 index 000000000..81cc14c1e --- /dev/null +++ b/tools/diagram/src/compile-pipeline.svg @@ -0,0 +1,89 @@ + + + + + + + + + + + + + + + + gcc -o hello hello.c 的四个阶段 + + + + + + hello.c + 源程序 + + 预处理器 cpp + gcc -E + + + + + + hello.i + 预处理后的源程序 + + 编译器 cc1 + gcc -S + + + + + + hello.s + 汇编程序 + + 汇编器 as + gcc -c + + + + + + hello.o + 可重定位目标文件 + + 链接器 ld + + + + + + hello + 可执行目标文件 + + + + + + printf.o 等 + 库中的目标文件 + + 前三步各自可以用 gcc 的选项单独执行;.i、.s 是文本文件,.o 和 hello 是二进制的 ELF 文件。 + diff --git a/tools/diagram/src/consistent-hash.svg b/tools/diagram/src/consistent-hash.svg new file mode 100644 index 000000000..1957ef122 --- /dev/null +++ b/tools/diagram/src/consistent-hash.svg @@ -0,0 +1,83 @@ + + + + + + + + + + + + + + + + 一致性哈希:数据放在顺时针方向的第一个节点上 + + + A + + B + + C + + D + + k1 + + k2 + + k3 + + k4 + + X + 新增 X + 哈希环 + 0 ~ 2³² − 1 + 顺时针找第一个节点:k1 → B,k2、k3 → C,k4 → D。 + 在 B、C 之间新增 X 后,只有 k2 改由 X 负责, + k3 和其它节点上的数据都不动。 + 10 万个键(MD5 取前 32 位)的实测结果 + + + + 每节点 1 个点 + + 每节点 150 个 + + 最多 / 最少 + + 41.6 倍 + + 1.17 倍 + + 新增 1 个节点迁移 + + 33.8% + + 20.7% + 4 个节点各放 1 个点时,位置是随机的,最多的节点分到 + 55.4% 的键,最少的只有 1.3%;新增节点后应迁移约 1/5, + 实际迁移了 33.8%。每个节点放 150 个虚拟节点后就接近均匀。 + 对比:hash % 4 改为 hash % 5,79.7% 的键要迁移。 + 左图是示意,节点位置不按比例;右表是实际计算的结果。 + diff --git a/tools/diagram/src/crypto-asymmetric.svg b/tools/diagram/src/crypto-asymmetric.svg new file mode 100644 index 000000000..3c7c6842a --- /dev/null +++ b/tools/diagram/src/crypto-asymmetric.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + 非对称加密:公钥加密、私钥解密;私钥签名、公钥验证 + 加密 + + 会话密钥 + + 服务器公钥 + + 密文 256 字节 + + 服务器私钥 + + 会话密钥 + 任何人都能用公钥加密,只有持有私钥的服务器能解开 + 签名 + + 证书内容 + + CA 私钥签名 + + 签名 + + CA 公钥验证 + + 签名有效 + 只有 CA 能生成签名,任何人都能用 CA 的公钥检查,内容改动一个字节签名就对不上 + 2048 位 RSA 的密文和签名都是 256 字节。非对称运算比对称加密慢得多,所以只用在握手阶段。 + diff --git a/tools/diagram/src/crypto-symmetric.svg b/tools/diagram/src/crypto-symmetric.svg new file mode 100644 index 000000000..2978ca6a2 --- /dev/null +++ b/tools/diagram/src/crypto-symmetric.svg @@ -0,0 +1,50 @@ + + + + + + + + + + + + + + + + 对称加密:加密和解密用同一个密钥 + + 转账 100 元 + + AES 加密 + + c0b9bea2112248bbc17e8d6a15e542de + + AES 解密 + + 转账 100 元 + + + + + 同一个密钥 K = 000102…0e0f(16 字节) + 用 openssl 实际计算(AES-128-CBC):14 字节的明文补齐到 16 字节;没有 K 无法还原,但 K 本身怎样安全地交给对方是个问题。 + diff --git a/tools/diagram/src/deadlock-banker-multi.svg b/tools/diagram/src/deadlock-banker-multi.svg new file mode 100644 index 000000000..a02a79619 --- /dev/null +++ b/tools/diagram/src/deadlock-banker-multi.svg @@ -0,0 +1,121 @@ + + + + + + + + + + + + + + + + 多个资源的银行家算法:找出一个安全序列 + E 总量 + + 9 + + 5 + + 7 + Available + + 1 + + 1 + + 2 + Allocation 已分配 + P1 + + 2 + + 1 + + 1 + P2 + + 3 + + 0 + + 2 + P3 + + 1 + + 2 + + 1 + P4 + + 2 + + 1 + + 1 + Need 还需要 + P1 + + 3 + + 2 + + 2 + P2 + + 1 + + 0 + + 2 + P3 + + 5 + + 2 + + 0 + P4 + + 0 + + 1 + + 1 + 安全序列 P2 → P4 → P1 → P3 + + 1. P2 需要 (1 0 2) ≤ (1 1 2) + 归还后 Available = (4 1 4) + + 2. P4 需要 (0 1 1) ≤ (4 1 4) + 归还后 Available = (6 2 5) + + 3. P1 需要 (3 2 2) ≤ (6 2 5) + 归还后 Available = (8 3 6) + + 4. P3 需要 (5 2 0) ≤ (8 3 6) + 归还后 Available = (9 5 7) + Need = 最大需求 − 已分配。一开始只有 P2 的需求能被满足,P1 缺 R2、P3 缺 R1; + 收到新的申请时,先假设分配,再用这个方法检查,找不到安全序列就拒绝。 + diff --git a/tools/diagram/src/deadlock-banker-single.svg b/tools/diagram/src/deadlock-banker-single.svg new file mode 100644 index 000000000..eac2d55f6 --- /dev/null +++ b/tools/diagram/src/deadlock-banker-single.svg @@ -0,0 +1,84 @@ + + + + + + + + + + + + + + + + 单个资源的银行家算法:共 12 个,分配前先检查分配后是否安全 + (a) 当前状态 + A + + + 3 / 8 + B + + + 2 / 4 + C + + + 4 / 9 + + Free 3 + 安全:B → A → C + (b) C 再申请 2 个 + A + + + 3 / 8 + B + + + 2 / 4 + C + + + 6 / 9 + + Free 1 + 不安全:谁都补不齐,拒绝 + (c) B 再申请 1 个 + A + + + 3 / 8 + B + + + 3 / 4 + C + + + 4 / 9 + + Free 2 + 安全:B → A → C,分配 + (b) 中 A、B、C 分别还需要 5、2、3 个,Free 只有 1,任何进程都无法运行完,可能发生死锁,所以拒绝这次申请, + 让 C 等待;(c) 中 B 只差 1 个,运行完归还 4 个后 Free = 5,A 和 C 也能依次完成,所以可以分配。 + diff --git a/tools/diagram/src/deadlock-detect-graph.svg b/tools/diagram/src/deadlock-detect-graph.svg new file mode 100644 index 000000000..23a2c3462 --- /dev/null +++ b/tools/diagram/src/deadlock-detect-graph.svg @@ -0,0 +1,60 @@ + + + + + + + + + + + + + + + + 每种资源只有一个:在资源分配图中找环 + + P1 + + P2 + + P3 + + P4 + + R1 + + R2 + + R3 + + R4 + + + + + + + + + 资源指向进程表示已分配,进程指向资源表示正在请求。红色的边构成环 P1 → R1 → P2 → R2 → P3 → R3 → P1, + 三个进程互相等待,发生死锁;P4 不在环上,但它请求的 R2 被 P2 持有,也会一直等下去。 + diff --git a/tools/diagram/src/deadlock-detect-matrix.svg b/tools/diagram/src/deadlock-detect-matrix.svg new file mode 100644 index 000000000..29a497930 --- /dev/null +++ b/tools/diagram/src/deadlock-detect-matrix.svg @@ -0,0 +1,105 @@ + + + + + + + + + + + + + + + + 每种资源有多个:逐个找能满足请求的进程 + 资源 R1、R2、R3 + E 总量 + + 5 + + 3 + + 4 + A 剩余 + + 1 + + 1 + + 1 + C 已分配 + P1 + + 1 + + 1 + + 0 + P2 + + 2 + + 0 + + 1 + P3 + + 1 + + 1 + + 2 + R 还在请求 + P1 + + 2 + + 0 + + 1 + P2 + + 1 + + 1 + + 0 + P3 + + 1 + + 2 + + 1 + 按算法依次标记 + + 1. P2 请求 (1 1 0) ≤ A,可以运行 + 结束后归还 (2 0 1),A = (3 1 2) + + 2. P1 请求 (2 0 1) ≤ A,可以运行 + 结束后归还 (1 1 0),A = (4 2 2) + + 3. P3 请求 (1 2 1) ≤ A,可以运行 + 结束后归还 (1 1 2),A = (5 3 4) + 开始时 A 只满足 P2 的请求;P2 结束后归还资源,P1、P3 才依次得到满足。 + 所有进程都能被标记,没有死锁;如果某一步找不到能满足的进程,剩下没被标记的进程就处于死锁中。 + diff --git a/tools/diagram/src/deadlock-safe-state.svg b/tools/diagram/src/deadlock-safe-state.svg new file mode 100644 index 000000000..747bd4727 --- /dev/null +++ b/tools/diagram/src/deadlock-safe-state.svg @@ -0,0 +1,85 @@ + + + + + + + + + + + + + + + + 安全状态:共 10 个资源,存在一个能让所有进程运行完的顺序 + (a) 初始 + A + + + 2 / 7 + B + + + 3 / 5 + C + + + 2 / 4 + + Free 3 + (b) B 再拿 2 个,运行结束 + A + + + 2 / 7 + B + 已完成 + C + + + 2 / 4 + + Free 6 + (c) A 再拿 5 个,运行结束 + A + 已完成 + B + 已完成 + C + + + 2 / 4 + + Free 8 + (d) C 再拿 2 个,运行结束 + A + 已完成 + B + 已完成 + C + 已完成 + + Free 10 + 条形的长度是最大需求,浅蓝部分是已持有的数量。(a) 中 Free = 10 − 2 − 3 − 2 = 3,只够 B 补齐, + B 运行完归还 5 个后 Free = 6,又够 A 补齐 5 个,依此类推。 + 安全不代表一定按这个顺序执行,只说明不管进程怎样申请,系统都能找到一条出路。 + diff --git a/tools/diagram/src/deadlock-transfer.svg b/tools/diagram/src/deadlock-transfer.svg new file mode 100644 index 000000000..2a85d548b --- /dev/null +++ b/tools/diagram/src/deadlock-transfer.svg @@ -0,0 +1,66 @@ + + + + + + + + + + + + + + + + 死锁:两个线程反向转账 + + T1 + + T2 + + alice + + bob + + 持有 + + 持有 + + 等待 + + 等待 + transfer(alice, bob) + transfer(bob, alice) + 圆形是线程,方形是账户上的锁 + 四个条件同时满足: + + 互斥 + 一把锁同一时刻只能被一个线程持有 + + 占有和等待 + T1 持有 alice 的锁,还在等 bob 的锁 + + 不可抢占 + bob 的锁只能由 T2 自己释放 + + 环路等待 + T1 → bob → T2 → alice → T1 + diff --git a/tools/diagram/src/decorator-cost.svg b/tools/diagram/src/decorator-cost.svg new file mode 100644 index 000000000..99a06c499 --- /dev/null +++ b/tools/diagram/src/decorator-cost.svg @@ -0,0 +1,49 @@ + + + + + + + + + + + + + + + + 装饰者:一层套一层,cost() 由外向内调用 + + Milk + + Mocha + + HouseBlend + cost() = 1 + cost() = 1 + 1 + cost() = 1 + 2 + ① Milk.cost() 调用 Mocha.cost() + ② Mocha.cost() 调用 HouseBlend.cost() + ③ HouseBlend 返回 1 + ④ Mocha 返回 1 + 1 = 2 + ⑤ Milk 返回 1 + 2 = 3,输出 3.0 + Milk、Mocha 和 HouseBlend 都实现 Beverage,所以装饰者可以继续被装饰;new Milk(new Mocha(new HouseBlend()))。 + diff --git a/tools/diagram/src/dhcp.svg b/tools/diagram/src/dhcp.svg new file mode 100644 index 000000000..05108bcaa --- /dev/null +++ b/tools/diagram/src/dhcp.svg @@ -0,0 +1,53 @@ + + + + + + + + + + + + + + + + DHCP:新接入的主机获取 IP 地址 + + 客户端(还没有 IP) + + + DHCP 服务器 192.168.1.1 + + + ① Discover 0.0.0.0:68 → 255.255.255.255:67 + 广播:有没有 DHCP 服务器? + + ② Offer 可以用 192.168.1.100,租期 1 天 + 附带子网掩码、网关、DNS 服务器 + + ③ Request 我要 192.168.1.1 提供的这个地址 + 仍是广播,其它服务器收回提议 + + ④ Ack 确认,从现在起租期 1 天 + 客户端开始使用这个地址 + 前两步用广播是因为客户端还没有地址,也不知道服务器在哪;租期过半时客户端会向同一台服务器申请续租。 + diff --git a/tools/diagram/src/disk-scan.svg b/tools/diagram/src/disk-scan.svg new file mode 100644 index 000000000..58e09ed76 --- /dev/null +++ b/tools/diagram/src/disk-scan.svg @@ -0,0 +1,90 @@ + + + + + + + + + + + + + + + + 电梯算法:磁头在 50,先向磁道号增大的方向移动 + + + 0 + + 10 + + 20 + + 30 + + 40 + + 50 + + 60 + + 70 + + 80 + + 90 + + 100 + 磁道 + + + + + + + + + 50 + + 56 + + + 72 + + + 81 + + + 95 + + + 44 + + + 30 + + + 12 + + 起点 + 淡紫色点是待处理的请求。磁头移动的总距离为 128 个磁道。按先来先服务需要 318 个磁道。 + diff --git a/tools/diagram/src/disk-sstf.svg b/tools/diagram/src/disk-sstf.svg new file mode 100644 index 000000000..4cb4d76f4 --- /dev/null +++ b/tools/diagram/src/disk-sstf.svg @@ -0,0 +1,90 @@ + + + + + + + + + + + + + + + + 最短寻道时间优先:磁头在 50,请求 72、30、95、56、12、81、44 + + + 0 + + 10 + + 20 + + 30 + + 40 + + 50 + + 60 + + 70 + + 80 + + 90 + + 100 + 磁道 + + + + + + + + + 50 + + 44 + + + 56 + + + 72 + + + 81 + + + 95 + + + 30 + + + 12 + + 起点 + 淡紫色点是待处理的请求。磁头移动的总距离为 140 个磁道。30 和 12 离得远,一直被推后。 + diff --git a/tools/diagram/src/dns-resolve.svg b/tools/diagram/src/dns-resolve.svg new file mode 100644 index 000000000..b814d2490 --- /dev/null +++ b/tools/diagram/src/dns-resolve.svg @@ -0,0 +1,97 @@ + + + + + + + + + + + + + + + + DNS 解析 www.example.com + + + + + 主机 + 先查浏览器缓存、 + 系统缓存和 hosts + + + + + + + + + + 本地 DNS 服务器 + 运营商或公司提供 + + + + + + + 根服务器 + a.root-servers.net + + + 去问 com 的服务器 + a.gtld-servers.net 等 + + + + + + + com 顶级域服务器 + a.gtld-servers.net + + + 去问 example.com 的服务器 + hera.ns.cloudflare.com 等 + + + + + + + 权威服务器 + hera.ns.cloudflare.com + + + www.example.com 的 A 记录 + 104.20.23.154,TTL 300 + + ① 递归查询 + + ④ 返回结果 + ② 迭代查询:每台服务器 + 只告诉下一步去问谁 + ③ 按 TTL 缓存 300 秒 + 图中的服务器和 TTL 是本机用 dig 逐级查询的结果:根服务器和 com 服务器返回的是下一级的 NS 记录(缓存 2 天), + 只有权威服务器的回答带有 aa(权威回答)标志。缓存命中时,前面任何一级都可以直接返回,不必走完全程。 + diff --git a/tools/diagram/src/docker-layers.svg b/tools/diagram/src/docker-layers.svg new file mode 100644 index 000000000..56d0a462b --- /dev/null +++ b/tools/diagram/src/docker-layers.svg @@ -0,0 +1,49 @@ + + + + + + + + + + + + + + + + 镜像分层与容器的可写层 + + 容器的可写层:运行时的修改都写在这里 + + RUN pip install flask + + COPY app.py /app/ + + FROM python:3.12-slim(基础镜像的多层) + 可读写,容器删除后就没有了 + + 镜像的只读层 + Dockerfile 的每条指令生成一层, + 多个镜像共享相同的层 + 容器修改镜像中的文件时,先把文件复制到可写层再修改(写时复制),只读层不变,所以同一个镜像可以启动多个容器。 + Dockerfile 中把变化少的指令放在前面,修改代码后重新构建时前面的层可以直接复用缓存。 + diff --git a/tools/diagram/src/docker-vs-vm.svg b/tools/diagram/src/docker-vs-vm.svg new file mode 100644 index 000000000..13a5b0539 --- /dev/null +++ b/tools/diagram/src/docker-vs-vm.svg @@ -0,0 +1,70 @@ + + + + + + + + + + + + + + + + 虚拟机与容器 + 虚拟机 + + App A + + App B + + 依赖库 + + 依赖库 + + 客户机 OS + + 客户机 OS + + Hypervisor + + 宿主机 OS + + 服务器 + 容器 + + App A + + App B + + 依赖库 + + 依赖库 + + 容器运行时(Docker Engine) + + 宿主机 OS(共享一个内核) + + 服务器 + 虚拟机为每个应用运行一个完整的操作系统,启动要几十秒、占用 GB 级内存;容器只是宿主机上隔离的进程, + 共享宿主机的内核,启动通常在 1 秒以内。代价是隔离性不如虚拟机,也不能在 Linux 宿主机上直接运行 Windows 容器。 + diff --git a/tools/diagram/src/docker-why.svg b/tools/diagram/src/docker-why.svg new file mode 100644 index 000000000..af62ee2d2 --- /dev/null +++ b/tools/diagram/src/docker-why.svg @@ -0,0 +1,61 @@ + + + + + + + + + + + + + + + + 容器:把应用和依赖打包在一起 + + 容器 + + 订单服务 + + JDK 21 + + Debian + + 容器 + + 推荐服务 + + Python 3.12 + + Ubuntu + + 容器 + + 网关 + + 静态二进制 + + Alpine + + 宿主机的 Linux 内核 + 各容器的依赖互不影响,同一个镜像在开发机、测试环境和生产环境中运行结果一致。 + diff --git a/tools/diagram/src/dynamic-link.svg b/tools/diagram/src/dynamic-link.svg new file mode 100644 index 000000000..f30c7836f --- /dev/null +++ b/tools/diagram/src/dynamic-link.svg @@ -0,0 +1,74 @@ + + + + + + + + + + + + + + + + 动态链接:链接时只记录依赖,运行时再加载共享库 + + 构建时 + + 运行时 + + + + + + main.o + + + + + + libmath.so + 只读取符号表 + + ld + + + + + + + + prog + + prog 中只记下依赖 libmath.so 和 libc.so, + 不包含它们的代码 + + execve 加载 prog + + + 动态链接器 ld-linux.so + 把 libmath.so、libc.so + 映射进内存,完成重定位 + 多个进程共享同一份库的代码(.text), + 库更新后不用重新链接程序 + 用 ldd prog 可以查看程序依赖的共享库;找不到某个库时程序启动失败,报 cannot open shared object file。 + diff --git a/tools/diagram/src/email-flow.svg b/tools/diagram/src/email-flow.svg new file mode 100644 index 000000000..293446094 --- /dev/null +++ b/tools/diagram/src/email-flow.svg @@ -0,0 +1,76 @@ + + + + + + + + + + + + + + + + 电子邮件:alice@a.com 发信给 bob@b.com + + + alice + 用户代理 + + + + + + + + + + a.com 邮件服务器 + + + + + + + + + + b.com 邮件服务器 + + + bob + 用户代理 + + + SMTP + + + SMTP(端口 25) + 先查 b.com 的 MX 记录 + 找到对方的邮件服务器 + + POP3 或 IMAP + bob 主动来取 + 发送和服务器之间的转发用 SMTP,是“推”;收件人读取用 POP3 或 IMAP,是“拉”。 + 邮件先存放在收件方的服务器上,bob 不在线也不影响 alice 发信。 + (用户代理到发件服务器之间通常使用端口 587 并要求登录。) + diff --git a/tools/diagram/src/ext-layout.svg b/tools/diagram/src/ext-layout.svg new file mode 100644 index 000000000..15fb786c9 --- /dev/null +++ b/tools/diagram/src/ext-layout.svg @@ -0,0 +1,60 @@ + + + + + + + + + + + + + + + + ext2/ext4 文件系统:分区被分成多个块组 + + 启动块 + + 块组 0 + + 块组 1 + + 块组 2 + + … + + + + superblock + + 块组描述符 + + block bitmap + + inode bitmap + + inode table + + data blocks + superblock 记录 inode 和 block 的总数与剩余数(多个块组中有备份);两个 bitmap 用 1 位表示一个 block 或 inode 是否已被使用; + inode table 存放 inode,data blocks 存放文件内容。找空闲块时只需要扫描 bitmap。 + diff --git a/tools/diagram/src/facade-movie.svg b/tools/diagram/src/facade-movie.svg new file mode 100644 index 000000000..0d07afca5 --- /dev/null +++ b/tools/diagram/src/facade-movie.svg @@ -0,0 +1,53 @@ + + + + + + + + + + + + + + + + 外观:一个方法替客户端完成一串调用 + + Client + + Facade + + watchMovie() + + + SubSystem + + ① turnOnTV() + + + ② setCD("a movie") + + + ③ startWatching() + + 客户端只调用 watchMovie(),不需要知道子系统中有哪些类、调用顺序是什么;需要精细控制时仍然可以直接使用子系统。 + diff --git a/tools/diagram/src/feed-push-pull.svg b/tools/diagram/src/feed-push-pull.svg new file mode 100644 index 000000000..cc552a717 --- /dev/null +++ b/tools/diagram/src/feed-push-pull.svg @@ -0,0 +1,116 @@ + + + + + + + + + + + + + + + + Feed 流:拉模式在读时合并,推模式在写时分发 + 拉模式(读扩散) + 张三关注了 A、B 和大 V,打开首页时现场合并 + + + A 的发件箱 + + a2 10:05 + + a1 09:00 + + + B 的发件箱 + + b1 10:20 + + + 大 V 的发件箱 + + v3 10:30 + + v2 08:10 + + + 张三刷新首页 + + + + + + 合并后按时间倒序 + + v3 10:30 + + b1 10:20 + + a2 10:05 + + a1 09:00 + 关注的人越多,读一次首页越慢 + + 推模式(写扩散) + A 发帖时,写入每个粉丝的收件箱 + + + A 发了 a3 + + + 张三的收件箱 + + a3 10:40 + + v3 10:30 + + b1 10:20 + + + 李四的收件箱 + + a3 10:40 + + a2 10:05 + + + 读首页只需读自己的收件箱: + ZREVRANGE inbox:张三 0 19 + 问题:大 V 有 1000 万粉丝,发一条就要写 1000 万次 + 解决:粉丝多的用户不推,粉丝打开首页时再拉取 + 合并(推拉结合);只推给最近活跃的粉丝 + 本机 Redis 7.4 实测 + + 推:10 万个收件箱各写 1 条 + + 532 ms,内存 +10 MB + + 推:读自己的收件箱一页 + + 0.12 ms + + 拉:合并 500 个发件箱 + + 24.5 ms + 左右两边的帖子和时间是示意;表中的数字是用流水线在本机执行得到的,拉模式包括在客户端合并排序的时间。 + diff --git a/tools/diagram/src/fifo.svg b/tools/diagram/src/fifo.svg new file mode 100644 index 000000000..b5f5ad17e --- /dev/null +++ b/tools/diagram/src/fifo.svg @@ -0,0 +1,53 @@ + + + + + + + + + + + + + + + + FIFO:不相关的进程通过路径名通信 + + 客户进程 1 + + + 客户进程 2 + + + 客户进程 3 + + + + + + + /tmp/server.fifo + + + 服务器进程 + mkfifo 在文件系统中创建一个特殊文件,任何有权限的进程都可以打开它读写,数据仍然经过内核,不写入磁盘。 + diff --git a/tools/diagram/src/ftp-modes.svg b/tools/diagram/src/ftp-modes.svg new file mode 100644 index 000000000..281bf44a4 --- /dev/null +++ b/tools/diagram/src/ftp-modes.svg @@ -0,0 +1,82 @@ + + + + + + + + + + + + + + + + FTP 的主动模式与被动模式 + 主动模式 + + + + + 客户端 + + + + + + + + + + 服务器 + + 控制连接 → 21 + PORT 192,168,1,10,195,81 + + 数据连接 20 → 50001 + 服务器主动连接客户端的 50001, + 客户端的防火墙要放行 + 被动模式 + + + + + 客户端 + + + + + + + + + + 服务器 + + 控制连接 → 21 + PASV → 227 (…,195,82) + + 数据连接 → 50002 + 客户端主动连接服务器的 50002, + 服务器要开放一段端口 + PORT 和 PASV 的回复中,最后两个数字表示端口:195 × 256 + 81 = 50001,195 × 256 + 82 = 50002。 + 客户端通常在 NAT 和防火墙之后,服务器连不进来,所以现在多用被动模式。 + diff --git a/tools/diagram/src/gc-cms.svg b/tools/diagram/src/gc-cms.svg new file mode 100644 index 000000000..4168ec352 --- /dev/null +++ b/tools/diagram/src/gc-cms.svg @@ -0,0 +1,68 @@ + + + + + + + + + + + + + + + + CMS:大部分时间与用户线程并发 + 用户线程 + + + + + + 初始标记 + + + 停顿 + + + + + 并发标记 + + + + + 重新标记 + + + 停顿 + + + + + 并发清除 + + + + + 浅蓝是用户线程,浅青是 GC 线程,红线之间所有用户线程暂停(Stop The World)。 + 只有初始标记和重新标记需要停顿;并发阶段占用一个 CPU,用户线程变慢,所以吞吐量较低。 + diff --git a/tools/diagram/src/gc-collectors.svg b/tools/diagram/src/gc-collectors.svg new file mode 100644 index 000000000..1103f4d7c --- /dev/null +++ b/tools/diagram/src/gc-collectors.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + HotSpot 的 7 个经典垃圾收集器 + + + 新生代 + 老年代 + + Serial + + ParNew + + Parallel Scavenge + + CMS + + Serial Old + + Parallel Old + + G1 + 整个堆 + + + + + + + + 失败时退回 + 实线是可以配合使用的组合;红色虚线的两种组合在 JDK 9 中移除(JEP 214)。JDK 9 起默认使用 G1, + CMS 在 JDK 14 中移除(JEP 363)。新的 ZGC、Shenandoah 不在图中。 + diff --git a/tools/diagram/src/gc-g1-cycle.svg b/tools/diagram/src/gc-g1-cycle.svg new file mode 100644 index 000000000..cb61fa087 --- /dev/null +++ b/tools/diagram/src/gc-g1-cycle.svg @@ -0,0 +1,65 @@ + + + + + + + + + + + + + + + + G1 的一次并发标记周期(JDK 21 实测,堆 128 MB) + + + 56 ms + + 60 ms + + 64 ms + + 68 ms + + 并发标记 11.4 ms:与用户线程同时运行,2 个并发线程 + + + Young (Concurrent Start) 1.649 ms + + + + + Remark 0.096 ms + + + + + Cleanup 0.046 ms + + + + Mixed 0.585 ms + 柱子是停顿,高度表示时长。① 一次年轻代回收顺带开始标记(Concurrent Start);② 并发标记期间年轻代回收照常进行; + ③ 最终标记 Remark 和 ④ 清理 Cleanup 只停顿不到 0.1 ms;⑤ 之后的混合回收(Mixed)同时回收年轻代和 + 垃圾最多的老年代 Region。这次运行共 88 次停顿,最长 2.38 ms。 + diff --git a/tools/diagram/src/gc-g1-regions.svg b/tools/diagram/src/gc-g1-regions.svg new file mode 100644 index 000000000..b2c2b45f3 --- /dev/null +++ b/tools/diagram/src/gc-g1-regions.svg @@ -0,0 +1,178 @@ + + + + + + + + + + + + + + + + G1 把堆分成大小相等的 Region + + E + + O + + E + + O + + + + + + O + + + + + + + + E + + O + + E + + S + + E + + O + + E + + + + + + + + O + + H + + H + + H + + O + + O + + + + + + + + + + O + + + + + + + + + + + + S + + E + + O + + + + + + O + + + + S + + + + O + + O + + E + + E + + E + + O + + + + + + O + + E + + O + + + + E + + E + + + + O + + E + + + + + + E + Eden + + S + Survivor + + O + 老年代 + + H + 大对象(Humongous) + + + 空闲 + 每个 Region 的角色可以变化。不小于半个 Region 的对象放在连续的大对象 Region 中。堆 128 MB 时 Region 为 1 MB,本机默认堆时为 4 MB。 + diff --git a/tools/diagram/src/gc-generations.svg b/tools/diagram/src/gc-generations.svg new file mode 100644 index 000000000..7377a9b80 --- /dev/null +++ b/tools/diagram/src/gc-generations.svg @@ -0,0 +1,48 @@ + + + + + + + + + + + + + + + + 分代的堆:其它收集器按新生代、老年代整体回收 + + Eden + + S0 + + S1 + + 老年代 + + 新生代:Eden 与两个 Survivor 默认 8 : 1 : 1 + + 老年代:默认是新生代的 2 倍(NewRatio = 2) + 新对象在 Eden 分配;Minor GC 时把存活对象复制到 Survivor,年龄够了晋升到老年代。 + 类的元数据不在堆中,JDK 8 起放在本地内存的元空间(Metaspace)。 + diff --git a/tools/diagram/src/gc-parallel.svg b/tools/diagram/src/gc-parallel.svg new file mode 100644 index 000000000..c6dadf49b --- /dev/null +++ b/tools/diagram/src/gc-parallel.svg @@ -0,0 +1,65 @@ + + + + + + + + + + + + + + + + Parallel Scavenge 与 Parallel Old:两代都多线程 + 用户线程 + + + + + + + + + 新生代复制 + + + 停顿 + + + + + + + + + 老年代标记 - 整理 + + + 停顿 + + + + + 浅蓝是用户线程,浅青是 GC 线程,红线之间所有用户线程暂停(Stop The World)。 + 目标是吞吐量:用户线程运行时间占总时间的比例越高越好。 + diff --git a/tools/diagram/src/gc-parnew.svg b/tools/diagram/src/gc-parnew.svg new file mode 100644 index 000000000..260fd117e --- /dev/null +++ b/tools/diagram/src/gc-parnew.svg @@ -0,0 +1,62 @@ + + + + + + + + + + + + + + + + ParNew:多线程收集新生代 + 用户线程 + + + + + + + + + 新生代复制 + + + 停顿 + + + + + + Serial Old + + + 停顿 + + + + + 浅蓝是用户线程,浅青是 GC 线程,红线之间所有用户线程暂停(Stop The World)。 + 新生代用多个 GC 线程并行复制,停顿更短;老年代仍由单线程的 Serial Old 或 CMS 回收。 + diff --git a/tools/diagram/src/gc-serial.svg b/tools/diagram/src/gc-serial.svg new file mode 100644 index 000000000..148152238 --- /dev/null +++ b/tools/diagram/src/gc-serial.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + Serial 与 Serial Old:单线程收集 + 用户线程 + + + + + + 新生代复制 + + + 停顿 + + + + + + 老年代标记 - 整理 + + + 停顿 + + + + + 浅蓝是用户线程,浅青是 GC 线程,红线之间所有用户线程暂停(Stop The World)。 + 收集期间只有一个 GC 线程工作,其它 CPU 空闲。 + diff --git a/tools/diagram/src/gpt-layout.svg b/tools/diagram/src/gpt-layout.svg new file mode 100644 index 000000000..55ae94607 --- /dev/null +++ b/tools/diagram/src/gpt-layout.svg @@ -0,0 +1,54 @@ + + + + + + + + + + + + + + + + GPT 分区表的布局(LBA 为 512 字节) + + 保护性 MBR + LBA 0 + + GPT 表头 + LBA 1 + + 分区项 × 128 + LBA 2~33 + + 各个分区 + + + 分区项备份 + + + 表头备份 + 最后 + 每个分区项 128 字节,一个 LBA 放 4 个,32 个 LBA 共 128 个分区;表头带 CRC32 校验,损坏时用末尾的备份恢复。 + LBA 是 64 位的,按 512 字节计算最大支持 2⁶⁴ × 512 字节 = 8 ZiB;MBR 只有 32 位,最大 2 TiB。 + diff --git a/tools/diagram/src/h2-frames.svg b/tools/diagram/src/h2-frames.svg new file mode 100644 index 000000000..1d5573769 --- /dev/null +++ b/tools/diagram/src/h2-frames.svg @@ -0,0 +1,72 @@ + + + + + + + + + + + + + + + + HTTP/2 的二进制分帧:一次 GET 请求和响应 + + + + + + GET /index.html HTTP/1.1 + Host: www.example.com + User-Agent: Mozilla/5.0 … + Accept: text/html + HTTP/1.1:文本,150 字节 + + HTTP/2 + + HEADERS + + stream 1 + + 78 字节 + 请求首部 + + HEADERS + + stream 1 + + … 字节 + 响应首部 + + DATA + + stream 1 + + 577 字节 + 页面内容 + + 服务器返回: + 每个帧前面有 9 字节的帧头:长度、类型、标志和流 ID。请求和响应属于同一个流(stream 1), + 所以多个请求可以在一个 TCP 连接上交错发送,接收方按流 ID 重新组装。 + 78 字节是用 hpack 库按图中首部实际编码的结果;577 字节是 www.example.com 首页的大小。 + diff --git a/tools/diagram/src/h2-push.svg b/tools/diagram/src/h2-push.svg new file mode 100644 index 000000000..7b9294b1d --- /dev/null +++ b/tools/diagram/src/h2-push.svg @@ -0,0 +1,49 @@ + + + + + + + + + + + + + + + + 服务端推送:请求页面时一起发送样式 + + 浏览器 + + + 服务器 + + + stream 1:GET /page.html + + stream 1:PUSH_PROMISE /style.css + + stream 1:page.html 的内容 + + stream 2:style.css 的内容 + 服务器推送的流 ID 为偶数。浏览器解析到 style.css 时它已经在缓存里,省去一次请求的往返。 + diff --git a/tools/diagram/src/h2-streams.svg b/tools/diagram/src/h2-streams.svg new file mode 100644 index 000000000..c3df994c7 --- /dev/null +++ b/tools/diagram/src/h2-streams.svg @@ -0,0 +1,60 @@ + + + + + + + + + + + + + + + + 多路复用:三个请求共用一个 TCP 连接 + + + HEADERS 1 + + HEADERS 3 + + DATA 1 + + HEADERS 5 + + DATA 3 + + DATA 1 + + DATA 5 + + DATA 3 + + DATA 5 + + 一个 TCP 连接 + stream 1:/index.html + stream 3:/style.css + stream 5:/app.js + 帧可以交错发送,一个响应慢不会挡住其它响应;但 TCP 丢包时所有流都要等重传,这是 HTTP/3 改用 QUIC 的原因。 + 客户端发起的流 ID 为奇数。 + diff --git a/tools/diagram/src/harness-loop.svg b/tools/diagram/src/harness-loop.svg new file mode 100644 index 000000000..5b25c94e3 --- /dev/null +++ b/tools/diagram/src/harness-loop.svg @@ -0,0 +1,92 @@ + + + + + + + + + + + + + + + + Harness 中的引导与反馈:以分层规范为例 + 引导:动手之前 + + CLAUDE.md、AGENTS.md + Controller 只能调用 Service + + + 架构文档、代码示例 + 需要时再读取 + + + Skill + 按需加载的操作步骤 + + + + + Agent + 模型 + Agent 循环 + + + + + + + OrderController.java + mapper.selectById(id); + Agent 第一次写的代码 + 跳过了 Service 层 + 反馈:动手之后 + + 编译、单元测试 + 确定,速度快 + + 架构检查(ArchUnit) + 确定,速度快 + + 模型审查 + 能查语义,较慢且不确定 + + + 未通过 + + + + + + Architecture Violation [Priority: MEDIUM] - Rule 'no classes that reside in a package + '..controller..' should depend on classes that reside in a package '..mapper..', + because Controller 只能调用 Service' was violated (3 times): + Method <OrderController.get(long)> calls method <OrderMapper.selectById(long)> + in (OrderController.java:7) + + 错误信息作为工具结果发回,Agent 改为调用 OrderService + + + 开发者:同一个问题反复出现时,补一条规范(引导)或一个检查(反馈),而不是每次在对话中纠正。 + 确定的检查放在前面,便宜又可靠;模型审查用来发现规则写不出来的问题。 + 错误信息是本机用 ArchUnit 1.3 检查示例代码的真实输出,省略了包名。 + diff --git a/tools/diagram/src/hpack.svg b/tools/diagram/src/hpack.svg new file mode 100644 index 000000000..bb0474e50 --- /dev/null +++ b/tools/diagram/src/hpack.svg @@ -0,0 +1,93 @@ + + + + + + + + + + + + + + + + 首部压缩:第二次请求只需 21 字节 + + 首部 + + 值 + + 编码方式 + + 字节数 + + :method + + GET + + 静态表第 2 项 + + 1 + + :scheme + + https + + 静态表第 7 项 + + 1 + + :authority + + www.example.com + + 动态表(第一次请求时加入) + + 1 + + :path + + /style.css + + 新值:名字用静态表,值用 Huffman 编码 + + 9 + + user-agent + + Mozilla/5.0 …(64 字节) + + 动态表(第一次请求时加入) + + 1 + + accept + + text/css + + 新值:名字用静态表,值用 Huffman 编码 + + 8 + 同样的请求用 HTTP/1.1 的文本格式是 148 字节;第一次请求要建立动态表,编码后 78 字节。 + 静态表是协议规定的 61 个常见首部;动态表由双方各自维护,保存本连接中出现过的首部,之后只发送序号。 + 以上字节数由 hpack 4.0 库编码得到(RFC 7541)。 + diff --git a/tools/diagram/src/http-connect.svg b/tools/diagram/src/http-connect.svg new file mode 100644 index 000000000..efc802aa0 --- /dev/null +++ b/tools/diagram/src/http-connect.svg @@ -0,0 +1,52 @@ + + + + + + + + + + + + + + + + CONNECT:通过代理建立隧道 + + 浏览器 + + + 代理 proxy:8080 + + + www.example.com:443 + + + CONNECT www.example.com:443 HTTP/1.1 + + 建立 TCP 连接 + + HTTP/1.1 200 Connection Established + + TLS 握手和加密的 HTTP 报文,代理只转发字节,看不到内容 + 代理只知道目标主机和端口;之后它像一根管道,把两端的数据原样转发。 + diff --git a/tools/diagram/src/http-connections.svg b/tools/diagram/src/http-connections.svg new file mode 100644 index 000000000..c52e35dee --- /dev/null +++ b/tools/diagram/src/http-connections.svg @@ -0,0 +1,74 @@ + + + + + + + + + + + + + + + + 短连接、长连接与流水线:请求 3 个资源 + 短连接 + + 握手 + + 请求 1 + + 握手 + + 请求 2 + + 握手 + + 请求 3 + 6 个 RTT + 长连接 + + 握手 + + 请求 1 + + 请求 2 + + 请求 3 + 4 个 RTT + 流水线 + + 握手 + + 请求 1、2、3 连续发出 + 约 2 个 RTT + 0 + 1 + 2 + 3 + 4 + 5 + 6 + + RTT + 灰色是 TCP 三次握手,每段约 1 个 RTT。HTTP/1.1 默认使用长连接;流水线中响应仍需按顺序返回,前一个慢了会阻塞后面的。 + diff --git a/tools/diagram/src/http-proxy.svg b/tools/diagram/src/http-proxy.svg new file mode 100644 index 000000000..c87013234 --- /dev/null +++ b/tools/diagram/src/http-proxy.svg @@ -0,0 +1,109 @@ + + + + + + + + + + + + + + + + 正向代理与反向代理 + + 正向代理 + + 内网 + + + + + 客户端 + + + + + + + + + + 代理 + + + + + + + + + + 网站 + + + 互联网 + 代理客户端:服务器看到的是代理的地址 + + 反向代理 + + 机房 + + + + + 客户端 + + + + + + + + + + Nginx + + + + + + + + + + + + + + + + + + + + + + + 代理服务器:客户端只知道代理的地址 + diff --git a/tools/diagram/src/https-hybrid.svg b/tools/diagram/src/https-hybrid.svg new file mode 100644 index 000000000..828061c1c --- /dev/null +++ b/tools/diagram/src/https-hybrid.svg @@ -0,0 +1,51 @@ + + + + + + + + + + + + + + + + 混合加密:用非对称加密传递会话密钥(TLS 1.2 的 RSA 密钥交换) + + 浏览器 + + + 服务器(持有私钥) + + + ① 客户端随机数 + + ② 服务器随机数 + 证书(含公钥) + + ③ 用公钥加密的预主密钥 + 三者算出会话密钥 + 解密后算出同样的会话密钥 + + ④ 之后的 HTTP 报文用会话密钥对称加密(例如 AES-GCM) + 这种方式下私钥一旦泄露,之前录下的通信都能被解密,TLS 1.3 已经去掉它,改用 ECDHE 密钥交换。 + diff --git a/tools/diagram/src/https-layers.svg b/tools/diagram/src/https-layers.svg new file mode 100644 index 000000000..7c78f2b85 --- /dev/null +++ b/tools/diagram/src/https-layers.svg @@ -0,0 +1,62 @@ + + + + + + + + + + + + + + + + HTTPS:HTTP 报文交给 TLS 加密后再交给 TCP + HTTP + + HTTP + + TCP + + IP + HTTPS + + HTTP + + TLS + + TCP + + IP + 抓包能看到的内容 + + IP、TCP 首部 + 明文:双方的地址和端口 + + TLS 记录头 + 明文:类型、版本、长度 + + HTTP 请求行、首部、主体 + 全部加密,包括 URL 和 Cookie + HTTPS 默认端口 443。握手时 ClientHello 中的 SNI(要访问的域名)仍是明文, + 所以中间人能知道访问的是哪个网站,但看不到访问了哪个页面、提交了什么内容。 + diff --git a/tools/diagram/src/inode-pointers.svg b/tools/diagram/src/inode-pointers.svg new file mode 100644 index 000000000..0436519bf --- /dev/null +++ b/tools/diagram/src/inode-pointers.svg @@ -0,0 +1,75 @@ + + + + + + + + + + + + + + + + inode 中的 block 指针(block 大小为 1 KB) + + inode + + 权限、拥有者 + + 大小、时间 + + 直接指针 × 12 + + 一级间接 + + 二级间接 + + 三级间接 + + 12 个数据块:12 KB + + + + + + + 256 个指针 + + 256 个数据块:256 KB + + + 256 + + + 256 × 256 + 65536 个数据块:64 MB + + + 256 + + 256² + + 256³ + 16777216 个数据块:16 GB + 一个 1 KB 的块能存 1024 / 4 = 256 个块号,合计 12 + 256 + 256² + 256³ = 16843020 个块,约 16 GB,与 ext2 的最大文件一致。 + diff --git a/tools/diagram/src/io-async.svg b/tools/diagram/src/io-async.svg new file mode 100644 index 000000000..a2b50970b --- /dev/null +++ b/tools/diagram/src/io-async.svg @@ -0,0 +1,55 @@ + + + + + + + + + + + + + + + + 异步 I/O + + 应用进程 + + 内核 + + + + ① 等待数据 + 例如等对方发来 hello + + ② 复制到用户缓冲区 + 数据到达 + + aio_read(fd, buf, 1024) + + 立即返回 + + 继续执行其它代码 + + 完成通知:buf 中已经是 hello + 两个阶段都由内核完成,进程收到通知时数据已经在自己的缓冲区中。Linux 上实际的异步 I/O 多用 io_uring。 + diff --git a/tools/diagram/src/io-blocking.svg b/tools/diagram/src/io-blocking.svg new file mode 100644 index 000000000..7233fcea2 --- /dev/null +++ b/tools/diagram/src/io-blocking.svg @@ -0,0 +1,53 @@ + + + + + + + + + + + + + + + + 阻塞式 I/O + + 应用进程 + + 内核 + + + + ① 等待数据 + 例如等对方发来 hello + + ② 复制到用户缓冲区 + 数据到达 + + recvfrom(fd, buf, 1024) + + 两个阶段都阻塞 + + 返回 5(读到 hello) + 本机测试:对方 300 ms 后才发送,recv 阻塞 0.31 秒后返回。等待期间线程不占用 CPU,但也不能做别的事。 + diff --git a/tools/diagram/src/io-compare.svg b/tools/diagram/src/io-compare.svg new file mode 100644 index 000000000..c477b96b1 --- /dev/null +++ b/tools/diagram/src/io-compare.svg @@ -0,0 +1,66 @@ + + + + + + + + + + + + + + + + 五种 I/O 模型的比较 + ① 等待数据 + ② 复制数据 + + 阻塞式 + + 阻塞 + + 阻塞 + 非阻塞式 + + 反复轮询 + + 阻塞 + I/O 复用 + + 阻塞在 select + + 阻塞 + 信号驱动 + + 不阻塞 + + 阻塞 + 异步 + + 不阻塞 + + 不阻塞 + + 同步 I/O:第二阶段由进程自己 recvfrom,都会阻塞 + 异步 I/O + 红色表示进程阻塞,浅青色表示进程可以做别的事。前四种的区别只在第一阶段。 + diff --git a/tools/diagram/src/io-multiplex.svg b/tools/diagram/src/io-multiplex.svg new file mode 100644 index 000000000..962b47f5f --- /dev/null +++ b/tools/diagram/src/io-multiplex.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + I/O 复用 + + 应用进程 + + 内核 + + + + ① 等待数据 + 例如等对方发来 hello + + ② 复制到用户缓冲区 + 数据到达 + + select([fd1, fd2, …]) + + 阻塞在 select + + fd1 可读 + + recvfrom(fd1) + + 复制时阻塞 + + 返回 5 + 和阻塞式 I/O 一样要等,但一次可以等很多个连接,任何一个就绪就返回,一个线程就能处理大量连接。 + diff --git a/tools/diagram/src/io-nonblocking.svg b/tools/diagram/src/io-nonblocking.svg new file mode 100644 index 000000000..7d9b9a532 --- /dev/null +++ b/tools/diagram/src/io-nonblocking.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + 非阻塞式 I/O + + 应用进程 + + 内核 + + + + ① 等待数据 + 例如等对方发来 hello + + ② 复制到用户缓冲区 + 数据到达 + + recvfrom + + EAGAIN(没有数据) + + recvfrom + + EAGAIN ……共 6 次 + + recvfrom + + 轮询 + + 复制时阻塞 + + 返回 5 + 本机测试:每 50 ms 调用一次 recv,前 6 次返回 EAGAIN(没有数据),第 7 次读到 hello。轮询本身要消耗 CPU。 + diff --git a/tools/diagram/src/io-signal.svg b/tools/diagram/src/io-signal.svg new file mode 100644 index 000000000..4f9892826 --- /dev/null +++ b/tools/diagram/src/io-signal.svg @@ -0,0 +1,61 @@ + + + + + + + + + + + + + + + + 信号驱动 I/O + + 应用进程 + + 内核 + + + + ① 等待数据 + 例如等对方发来 hello + + ② 复制到用户缓冲区 + 数据到达 + + sigaction(SIGIO, handler) + + 立即返回 + + 继续执行其它代码 + + SIGIO 信号 + + 在处理函数中 recvfrom + + 复制时阻塞 + + 返回 5 + 等待阶段不阻塞,数据到达时内核发信号通知“可以读了”,读取仍由进程自己完成。 + diff --git a/tools/diagram/src/java-exceptions.svg b/tools/diagram/src/java-exceptions.svg new file mode 100644 index 000000000..a4530ff93 --- /dev/null +++ b/tools/diagram/src/java-exceptions.svg @@ -0,0 +1,69 @@ + + + + + + + + + + + + + + + + Java 异常的层次 + + Throwable + + Error + + Exception + + + + OutOfMemoryError + + + StackOverflowError + + + RuntimeException + + IOException + + SQLException + + + + + NullPointerException + + ArithmeticException + + + FileNotFoundException + + 淡紫色的 Error、RuntimeException 及它们的子类 + 是非受检异常,编译器不强制处理; + 其余的 Exception(浅蓝)是受检异常,必须 + 捕获或者用 throws 声明。 + diff --git a/tools/diagram/src/jc-atomic-cas.svg b/tools/diagram/src/jc-atomic-cas.svg new file mode 100644 index 000000000..613e3683c --- /dev/null +++ b/tools/diagram/src/jc-atomic-cas.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + AtomicInteger:CAS 失败就重新读取再试 + + 线程 T1 + incrementAndGet() + + + 线程 T2 + incrementAndGet() + + 时间 + + + 读取当前值 + → 0 + + 读取当前值 + → 0 + + CAS(期望 0,新值 1) + 成功 + + CAS(期望 0,新值 1) + 失败,当前是 1 + + 重新读取当前值 + → 1 + + CAS(期望 1,新值 2) + 成功 + 结果为 2。CAS 由 CPU 的一条原子指令完成:只有当前值等于期望值时才写入新值。 + diff --git a/tools/diagram/src/jc-cnt-race.svg b/tools/diagram/src/jc-cnt-race.svg new file mode 100644 index 000000000..70eec535a --- /dev/null +++ b/tools/diagram/src/jc-cnt-race.svg @@ -0,0 +1,64 @@ + + + + + + + + + + + + + + + + 两个线程同时执行 cnt++,结果只加了 1 + + 线程 T1 + cnt++ + + + 线程 T2 + cnt++ + + 时间 + + + load:从主内存读入 cnt + → 0 + + load:从主内存读入 cnt + → 0 + + assign:cnt = 0 + 1 + → 1 + + assign:cnt = 0 + 1 + → 1 + + store:写回主内存 + cnt = 1 + + store:写回主内存 + cnt = 1 + 执行了两次自增,主内存中的 cnt 是 1 而不是 2。 + load、assign、store 每一步都是原子的,但三步合在一起不是。 + diff --git a/tools/diagram/src/jc-countdownlatch.svg b/tools/diagram/src/jc-countdownlatch.svg new file mode 100644 index 000000000..14b67d354 --- /dev/null +++ b/tools/diagram/src/jc-countdownlatch.svg @@ -0,0 +1,68 @@ + + + + + + + + + + + + + + + + CountDownLatch:计数减到 0 时唤醒等待的线程 + main + + worker-1 + + worker-2 + + worker-3 + + + 执行 + + await(),等待 + + 被唤醒,继续执行 + + 执行任务 + + countDown() + + + 执行任务 + + countDown() + + + 执行任务 + + countDown() + + count = 3 + 2 + 1 + 0 + 示意:new CountDownLatch(3),main 调用 await() 等待 3 个工作线程各调用一次 countDown()。计数不能重置,只能使用一次。 + diff --git a/tools/diagram/src/jc-cpu-cache.svg b/tools/diagram/src/jc-cpu-cache.svg new file mode 100644 index 000000000..3779c5a69 --- /dev/null +++ b/tools/diagram/src/jc-cpu-cache.svg @@ -0,0 +1,79 @@ + + + + + + + + + + + + + + + + CPU 缓存:每个核心先读写自己的缓存 + + 核心 0 + + L1 数据缓存 + 128 KB + + + 核心 1 + + L1 数据缓存 + 128 KB + + + 核心 2 + + L1 数据缓存 + 128 KB + + + 核心 3 + + L1 数据缓存 + 128 KB + + + L2 缓存,4 个性能核共享 + 12 MB + + + + + + 主内存 + 32 GB + + 以本机 Apple M1 Pro 为例(sysctl) + 缓存以缓存行为单位读写, + 本机的缓存行为 128 字节。 + 核心 0 修改了缓存中的变量, + 其它核心缓存里可能还是旧值, + 缓存一致性协议负责让它们失效, + 但编译器和 CPU 的重排序、 + 写缓冲仍会导致其它线程看不到 + 最新的值。 + 图中只画了一组 4 个性能核;本机共有 8 个性能核和 2 个能效核。 + diff --git a/tools/diagram/src/jc-cyclicbarrier.svg b/tools/diagram/src/jc-cyclicbarrier.svg new file mode 100644 index 000000000..10804b065 --- /dev/null +++ b/tools/diagram/src/jc-cyclicbarrier.svg @@ -0,0 +1,68 @@ + + + + + + + + + + + + + + + + CyclicBarrier:线程到齐后一起继续,然后自动开始下一轮 + thread-0 + + thread-1 + + thread-2 + + + 第 1 轮 + + await() + + 第 2 轮 + + await() + + 第 1 轮 + + await() + + 第 2 轮 + + await() + + 第 1 轮 + + 第 2 轮 + + 屏障打开 + 执行 barrierAction + + 再次打开 + 执行 barrierAction + new CyclicBarrier(3, barrierAction):先到的线程在 await() 处等待,第 3 个线程到达时屏障打开; + 计数随即恢复为 3,同一个对象可以用于下一轮。在 JDK 21 上运行两轮,barrierAction 各执行了一次。 + diff --git a/tools/diagram/src/jc-hb-join.svg b/tools/diagram/src/jc-hb-join.svg new file mode 100644 index 000000000..9dd8f88f3 --- /dev/null +++ b/tools/diagram/src/jc-hb-join.svg @@ -0,0 +1,50 @@ + + + + + + + + + + + + + + + + 线程加入规则 + + 线程 t + + main + + x = 1; + + // 线程结束 + + t.join(); // 返回 + + print(x); // 1 + + + + 线程 t 中的所有操作先行发生于其它线程从 t.join() 返回。 + diff --git a/tools/diagram/src/jc-hb-monitor.svg b/tools/diagram/src/jc-hb-monitor.svg new file mode 100644 index 000000000..a12e21394 --- /dev/null +++ b/tools/diagram/src/jc-hb-monitor.svg @@ -0,0 +1,51 @@ + + + + + + + + + + + + + + + + 管程锁定规则 + + 线程 T1 + + 线程 T2 + + synchronized (lock) { + + x = 1; + + } // unlock + + synchronized (lock) { // lock + + print(x); // 1 + + + T1 释放锁先行发生于 T2 之后获得同一把锁,T1 在锁内的修改对 T2 可见。 + diff --git a/tools/diagram/src/jc-hb-program-order.svg b/tools/diagram/src/jc-hb-program-order.svg new file mode 100644 index 000000000..df9922ecd --- /dev/null +++ b/tools/diagram/src/jc-hb-program-order.svg @@ -0,0 +1,45 @@ + + + + + + + + + + + + + + + + 单一线程原则 + + 线程 T + + x = 1; + + y = x + 1; + + print(y); // 2 + + + 同一个线程内,前面的操作先行发生于后面的操作。 + diff --git a/tools/diagram/src/jc-hb-start.svg b/tools/diagram/src/jc-hb-start.svg new file mode 100644 index 000000000..a6f1bb94a --- /dev/null +++ b/tools/diagram/src/jc-hb-start.svg @@ -0,0 +1,47 @@ + + + + + + + + + + + + + + + + 线程启动规则 + + main + + 线程 t + + x = 1; + + t.start(); + + print(x); // 1 + + + start() 先行发生于新线程中的每一个操作。 + diff --git a/tools/diagram/src/jc-hb-volatile.svg b/tools/diagram/src/jc-hb-volatile.svg new file mode 100644 index 000000000..652b537b3 --- /dev/null +++ b/tools/diagram/src/jc-hb-volatile.svg @@ -0,0 +1,50 @@ + + + + + + + + + + + + + + + + volatile 变量规则 + + 线程 T1 + + 线程 T2 + + data = 42; + + ready = true; // volatile + + if (ready) // 读到 true + + print(data); // 42 + + + + 写 volatile 变量先行发生于之后读到这个值;加上传递性,T2 也能看到 data = 42。 + diff --git a/tools/diagram/src/jc-jmm-ops.svg b/tools/diagram/src/jc-jmm-ops.svg new file mode 100644 index 000000000..44076873e --- /dev/null +++ b/tools/diagram/src/jc-jmm-ops.svg @@ -0,0 +1,54 @@ + + + + + + + + + + + + + + + + 主内存与工作内存之间的 8 种操作 + + 主内存 + 变量 cnt + + 工作内存 + cnt 的副本 + + 执行引擎 + cnt + 1 + + read → load + + store → write + + use + + assign + lock / unlock + 作用于主内存中的变量 + read 把值从主内存传到工作内存,load 放入副本;store 把副本传回主内存,write 写入变量。 + diff --git a/tools/diagram/src/jc-jmm.svg b/tools/diagram/src/jc-jmm.svg new file mode 100644 index 000000000..ca5cf4aec --- /dev/null +++ b/tools/diagram/src/jc-jmm.svg @@ -0,0 +1,61 @@ + + + + + + + + + + + + + + + + Java 内存模型:线程读写自己的工作内存,通过主内存交换数据 + + 线程 1 + + 工作内存 + cnt = 1 + + + 已修改,还没写回 + + 线程 2 + + 工作内存 + cnt = 0 + + + 读到的是旧值 + + 线程 3 + + 工作内存 + cnt = 0 + + + + 主内存 + cnt = 0 + 工作内存是对寄存器、缓存等的抽象。线程 1 把 cnt 改为 1 但还没有写回主内存,线程 2 读到的仍然是 0。 + diff --git a/tools/diagram/src/jc-threadlocal.svg b/tools/diagram/src/jc-threadlocal.svg new file mode 100644 index 000000000..b1f3a5728 --- /dev/null +++ b/tools/diagram/src/jc-threadlocal.svg @@ -0,0 +1,73 @@ + + + + + + + + + + + + + + + + ThreadLocal:值保存在每个线程自己的 ThreadLocalMap 中 + + Thread1.threadLocals + + value + + 1 + + 1 + + key(弱引用) + + threadLocal1 + + threadLocal2 + + Thread2.threadLocals + + key(弱引用) + + threadLocal1 + + threadLocal2 + + value + + 2 + + 2 + + threadLocal1 + + + + threadLocal2 + + + ThreadLocal 对象 + 每个线程的 Map 以 ThreadLocal 对象为 key:同一个 threadLocal1,在两个线程中取到的值不同。 + Entry 对 key 是弱引用,对 value 是强引用;线程池中的线程一直存活,value 不 remove() 就一直留在 Map 中。 + diff --git a/tools/diagram/src/jc-work-stealing.svg b/tools/diagram/src/jc-work-stealing.svg new file mode 100644 index 000000000..1bb217df9 --- /dev/null +++ b/tools/diagram/src/jc-work-stealing.svg @@ -0,0 +1,53 @@ + + + + + + + + + + + + + + + + 工作窃取:自己从队列一端取,窃取从另一端取 + Thread1 的双端队列 + + + Task1 + + Task2 + + Task3 + 旧 + 新 + + Thread1 自己取出最新的 Task3 + (后进先出) + + Thread2 的队列为空 + + Thread2 窃取最早的 Task1(先进先出) + 所有者和窃取者在队列的两端操作,只有队列中只剩一个任务时才会发生竞争。 + 先放入的任务通常是拆分前更大的任务,窃取它能让空闲线程分到更多的工作。 + diff --git a/tools/diagram/src/kafka-topic.svg b/tools/diagram/src/kafka-topic.svg new file mode 100644 index 000000000..f8cc881b3 --- /dev/null +++ b/tools/diagram/src/kafka-topic.svg @@ -0,0 +1,111 @@ + + + + + + + + + + + + + + + + Kafka:按 key 选分区,组内每个分区只交给一个消费者 + + + + + + key value + 1024 下单 + 1025 下单 + 1024 支付 + 1026 下单 + 1024 发货 + 1025 支付 + 生产者按顺序发送 + hash(key) % 3 选分区 + 分区 0 + + + 1026 + 下单 + 0 + + + + + + 分区 1 + + + + + + + 分区 2 + + + 1024 + 下单 + 0 + + + 1025 + 下单 + 1 + + + 1024 + 支付 + 2 + + + 1024 + 发货 + 3 + + + 1025 + 支付 + 4 + + 订单 1024 的三条消息都在分区 2,顺序不变 + 偏移量 + + 消费者组 billing + + consumer-1 + + + consumer-2 + + + consumer-3 + + + consumer-4 + 没有分到分区 + 本机 3 个节点的 Kafka 4.4 实测:key 为 1024 和 1025 的消息都落在分区 2,1026 落在分区 0; + 4 个消费者分 3 个分区,consumer-4 空闲。停掉 consumer-3 后触发重平衡,分区 2 改由 consumer-4 消费。 + diff --git a/tools/diagram/src/lb-dns.svg b/tools/diagram/src/lb-dns.svg new file mode 100644 index 000000000..fc4f41a56 --- /dev/null +++ b/tools/diagram/src/lb-dns.svg @@ -0,0 +1,65 @@ + + + + + + + + + + + + + + + + DNS 负载均衡:解析域名时选出服务器 + + + + + 客户端 + + + + + + + DNS 服务器 + 按地域或轮询返回 IP + + + + + + + + + + Server 2 + 203.0.113.12 + + ① 查询 www.example.com + + ② A 203.0.113.12,TTL 600 + + ③ GET http://www.example.com/ + 600 秒内本地和各级 DNS 缓存都直接返回这个地址,下线 Server 2 后要等缓存过期才生效。 + diff --git a/tools/diagram/src/lb-http-redirect.svg b/tools/diagram/src/lb-http-redirect.svg new file mode 100644 index 000000000..4b4474981 --- /dev/null +++ b/tools/diagram/src/lb-http-redirect.svg @@ -0,0 +1,66 @@ + + + + + + + + + + + + + + + + HTTP 重定向:负载均衡器只返回目标地址 + + + + + 浏览器 + + + + + + + 负载均衡器 + www.example.com + + + + + + + + + + Server 2 + 203.0.113.12 + + ① GET http://www.example.com/ + + ② 302 Found + Location: http://203.0.113.12/ + + ③ GET http://203.0.113.12/ + 浏览器要发两次请求,之后直接访问 203.0.113.12,负载均衡器无法再调整。 + diff --git a/tools/diagram/src/lb-ip-hash.svg b/tools/diagram/src/lb-ip-hash.svg new file mode 100644 index 000000000..812913782 --- /dev/null +++ b/tools/diagram/src/lb-ip-hash.svg @@ -0,0 +1,85 @@ + + + + + + + + + + + + + + + + 源地址哈希:同一个 IP 总是落到同一台服务器 + + + + + 192.0.2.30 + crc32(IP) % 2 = 0 + + + + + + 198.51.100.8 + crc32(IP) % 2 = 0 + + + + + + 203.0.113.11 + crc32(IP) % 2 = 1 + + + + + + 198.51.100.7 + crc32(IP) % 2 = 1 + + + + + + + + + + + Server 1 + 余数为 0 的客户端 + + + + + + + + + + Server 2 + 余数为 1 的客户端 + 示意:用 crc32(IP) % 服务器数 选择服务器。服务器数量变化时,大部分客户端的结果都会改变。 + diff --git a/tools/diagram/src/lb-least-conn-problem.svg b/tools/diagram/src/lb-least-conn-problem.svg new file mode 100644 index 000000000..d78ed0a94 --- /dev/null +++ b/tools/diagram/src/lb-least-conn-problem.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + 轮询不考虑连接的持续时间 + Server 1 + + Server 2 + + + 请求 1 + + 请求 2 + + 请求 3 + + 请求 4 + + 请求 5 + + 请求 6 + 0 + 1 + 2 + 3 + 4 + 5 + 6 + 7 + 8 + 时间 + + 请求 6 到达时:Server 1 有 1 个连接,Server 2 有 2 个 + 请求 1、3 很快结束,请求 2 结束前又来了 4 和 6:轮询把 6 发给了已有 2 个连接的 Server 2。 + diff --git a/tools/diagram/src/lb-least-conn.svg b/tools/diagram/src/lb-least-conn.svg new file mode 100644 index 000000000..4c7f0e793 --- /dev/null +++ b/tools/diagram/src/lb-least-conn.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + 最少连接:发给当前连接数最少的服务器 + Server 1 + + Server 2 + + + 请求 1 + + 请求 2 + + 请求 3 + + 请求 4 + + 请求 5 + + 请求 6 + 0 + 1 + 2 + 3 + 4 + 5 + 6 + 7 + 8 + 时间 + + 请求 6 到达时:Server 1 有 1 个连接,Server 2 有 2 个 + 同样的请求,最少连接算法把请求 6 发给只有 1 个连接的 Server 1,两台各有 2 个连接。 + diff --git a/tools/diagram/src/lb-random.svg b/tools/diagram/src/lb-random.svg new file mode 100644 index 000000000..f35835ee7 --- /dev/null +++ b/tools/diagram/src/lb-random.svg @@ -0,0 +1,94 @@ + + + + + + + + + + + + + + + + 随机:每个请求随机选一台服务器 + 请求按顺序到达 + + 1 + + 2 + + 3 + + 4 + + 5 + + 6 + + + + + + + + + + + 负载均衡器 + 随机 + + + + + + + + + + + Server 1 + + 1 + + 2 + + 4 + + + + + + + + + + + Server 2 + + 3 + + 5 + + 6 + 请求少时分配可能不均,请求多时接近平均:模拟 10000 个请求,两台分到 5055 和 4945 个。 + diff --git a/tools/diagram/src/lb-round-robin-weak.svg b/tools/diagram/src/lb-round-robin-weak.svg new file mode 100644 index 000000000..569e0be76 --- /dev/null +++ b/tools/diagram/src/lb-round-robin-weak.svg @@ -0,0 +1,96 @@ + + + + + + + + + + + + + + + + 轮询不考虑服务器的性能 + 请求按顺序到达 + + 1 + + 2 + + 3 + + 4 + + 5 + + 6 + + + + + + + + + + + 负载均衡器 + 轮询 + + + + + + + + + + + Server 1 + + 1 + + 3 + + 5 + 8 核,CPU 30% + + + + + + + + + + + Server 2 + + 2 + + 4 + + 6 + 2 核,CPU 95%,请求排队 + 两台分到的请求一样多,但 Server 2 的处理能力只有 Server 1 的四分之一。 + diff --git a/tools/diagram/src/lb-round-robin.svg b/tools/diagram/src/lb-round-robin.svg new file mode 100644 index 000000000..f8ffe4375 --- /dev/null +++ b/tools/diagram/src/lb-round-robin.svg @@ -0,0 +1,94 @@ + + + + + + + + + + + + + + + + 轮询:请求轮流发给每台服务器 + 请求按顺序到达 + + 1 + + 2 + + 3 + + 4 + + 5 + + 6 + + + + + + + + + + + 负载均衡器 + 轮询 + + + + + + + + + + + Server 1 + + 1 + + 3 + + 5 + + + + + + + + + + + Server 2 + + 2 + + 4 + + 6 + 两台服务器各分到 3 个请求,适合性能相近的服务器。 + diff --git a/tools/diagram/src/lb-weighted-round-robin.svg b/tools/diagram/src/lb-weighted-round-robin.svg new file mode 100644 index 000000000..6d99265e7 --- /dev/null +++ b/tools/diagram/src/lb-weighted-round-robin.svg @@ -0,0 +1,122 @@ + + + + + + + + + + + + + + + + 加权轮询:按权重分配请求 + 请求按顺序到达 + + 1 + + 2 + + 3 + + 4 + + 5 + + 6 + + + + + + + + + + + 负载均衡器 + 加权轮询 + + + + + + + + + + + Server 1 + + 1 + + 2 + + 3 + + 4 + + 5 + 权重 5 + + + + + + + + + + + Server 2 + + 6 + 权重 1 + 6 个请求依次发给: + 按权重连续分配 + + S1 + + S1 + + S1 + + S1 + + S1 + + S2 + Nginx 平滑加权轮询 + + S1 + + S1 + + S1 + + S2 + + S1 + + S1 + diff --git a/tools/diagram/src/lock-level-1.svg b/tools/diagram/src/lock-level-1.svg new file mode 100644 index 000000000..c174f8610 --- /dev/null +++ b/tools/diagram/src/lock-level-1.svg @@ -0,0 +1,61 @@ + + + + + + + + + + + + + + + + 一级封锁协议:修改前加 X 锁,事务结束才释放 + + 事务 T1 + + + 事务 T2 + + 时间 + + + lock-x(A) + + read A + → 100 + + lock-x(A),等待 T1 释放 + + write A = 70 + + commit,unlock(A) + + 获得 X 锁,read A + → 70 + + write A = 120 + + commit,unlock(A) + 解决丢失修改:T2 只能在 T1 提交之后读取并修改,结果为 120。 + diff --git a/tools/diagram/src/lock-level-2.svg b/tools/diagram/src/lock-level-2.svg new file mode 100644 index 000000000..478ff3ed4 --- /dev/null +++ b/tools/diagram/src/lock-level-2.svg @@ -0,0 +1,56 @@ + + + + + + + + + + + + + + + + 二级封锁协议:读取前加 S 锁,读完立即释放 + + 事务 T1 + + + 事务 T2 + + 时间 + + + lock-x(A) + + write A = 200 + + lock-s(A),等待 T1 释放 + + rollback,unlock(A) + + 获得 S 锁,read A + → 100 + + unlock(A) + 解决读脏数据:T1 持有 X 锁期间,T2 加不上 S 锁,读不到 T1 未提交的 200。 + diff --git a/tools/diagram/src/lock-level-3.svg b/tools/diagram/src/lock-level-3.svg new file mode 100644 index 000000000..60c86a6c5 --- /dev/null +++ b/tools/diagram/src/lock-level-3.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + 三级封锁协议:读取前加 S 锁,事务结束才释放 + + 事务 T1 + + + 事务 T2 + + 时间 + + + lock-s(A) + + read A + → 100 + + lock-x(A),等待 T2 释放 + + read A + → 100 + + commit,unlock(A) + + 获得 X 锁,write A = 200 + + commit,unlock(A) + 解决不可重复读:T2 结束之前,T1 无法修改 A,T2 两次读到的都是 100。 + diff --git a/tools/diagram/src/lock-record.svg b/tools/diagram/src/lock-record.svg new file mode 100644 index 000000000..b39e73772 --- /dev/null +++ b/tools/diagram/src/lock-record.svg @@ -0,0 +1,52 @@ + + + + + + + + + + + + + + + + 轻量级锁:加锁就是一次 CAS + + 线程 T1 的栈 + + 其它栈帧 + + Lock Record + 保存原来的 Mark Word …01 + + 锁对象 + + Mark Word:Lock Record 的地址 …00 + + 类型指针 + + 字段 + + CAS 成功 + CAS 期望 Mark Word 仍是原来的 …01,成功就加锁完成;失败说明已被其它线程持有(或是当前线程重入),竞争时膨胀为重量级锁。 + diff --git a/tools/diagram/src/lock-states.svg b/tools/diagram/src/lock-states.svg new file mode 100644 index 000000000..0fa4a66fa --- /dev/null +++ b/tools/diagram/src/lock-states.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + synchronized 的锁状态变化(JDK 21 用 JOL 实测 Mark Word) + + 无锁 + 0x0000000000000001 + 末尾 01 + + 轻量级锁 + 0x000000016faceae0 + 末尾 00 + 指向加锁线程栈中的 Lock Record + + 重量级锁 + 0x000000015b630a72 + 末尾 10 + 指向 ObjectMonitor + + + 进入 synchronized:CAS 把 Mark Word 换成 + Lock Record 地址;退出时 CAS 换回 + + 另一个线程加锁时 CAS 失败, + 膨胀为重量级锁,抢不到的线程阻塞 + 实测:① 新建的对象是 0x…01;② 一个线程进入 synchronized 后变为 thin lock;③ 退出后恢复为 0x…01; + ④ 另一个线程持有锁时再去加锁,变为 fat lock;⑤ 两个线程都退出后仍是 fat lock,空闲的监视器由 JVM 之后回收。 + 如果对象调用过 hashCode(),哈希值会写进 Mark Word,例如 0x00000028ac3dc301 中的 28ac3dc3。 + 锁只会从轻量级膨胀为重量级,不会在使用中降级;JDK 15 之前,一个线程反复加锁时还会先进入偏向锁。 + diff --git a/tools/diagram/src/lru-stack.svg b/tools/diagram/src/lru-stack.svg new file mode 100644 index 000000000..8989597d0 --- /dev/null +++ b/tools/diagram/src/lru-stack.svg @@ -0,0 +1,153 @@ + + + + + + + + + + + + + + + + LRU:5 个页框,链表头是最近访问的页面 + 访问 + 缺页 + 4 + + 4 + + + + + 缺页 + 7 + + 7 + + 4 + + + + 缺页 + 0 + + 0 + + 7 + + 4 + + + 缺页 + 7 + + 7 + + 0 + + 4 + + + 1 + + 1 + + 7 + + 0 + + 4 + + 缺页 + 0 + + 0 + + 1 + + 7 + + 4 + + 1 + + 1 + + 0 + + 7 + + 4 + + 2 + + 2 + + 1 + + 0 + + 7 + + 4 + 缺页 + 1 + + 1 + + 2 + + 0 + + 7 + + 4 + 2 + + 2 + + 1 + + 0 + + 7 + + 4 + 6 + + 6 + + 2 + + 1 + + 0 + + 7 + 缺页 + 换出 4 + 头 + 尾 + 被访问的页面移到链表头(淡紫色);访问 6 时 5 个页框已满,换出链表尾部最久没有访问的 4。11 次访问共缺页 6 次。 + diff --git a/tools/diagram/src/markword.svg b/tools/diagram/src/markword.svg new file mode 100644 index 000000000..e9e53f4ec --- /dev/null +++ b/tools/diagram/src/markword.svg @@ -0,0 +1,79 @@ + + + + + + + + + + + + + + + + 64 位 HotSpot 的 Mark Word(JDK 8) + 是否偏向 + 锁标志 + 无锁 + + unused 25 + + hashCode 31 + + 1 + + age 4 + + 0 + + 01 + 偏向锁 + + 线程 ID 54 + + epoch 2 + + 1 + + age 4 + + 1 + + 01 + 轻量级锁 + + 指向栈中 Lock Record 的指针 62 + + 00 + 重量级锁 + + 指向 ObjectMonitor 的指针 62 + + 10 + GC 标记 + + + + 11 + 末尾两位是锁标志,01 时再看倒数第 3 位区分无锁和偏向锁。偏向锁在 JDK 15 默认禁用(JEP 374),之后被移除, + 现在对象只在无锁、轻量级锁、重量级锁之间转换。依据 jdk8u 的 markOop.hpp。 + diff --git a/tools/diagram/src/mbr-multiboot.svg b/tools/diagram/src/mbr-multiboot.svg new file mode 100644 index 000000000..f21d0900f --- /dev/null +++ b/tools/diagram/src/mbr-multiboot.svg @@ -0,0 +1,53 @@ + + + + + + + + + + + + + + + + MBR 与多重引导 + + 第 1 个扇区 + + 分区 1:Windows + + 分区 2:Linux + 446 字节开机管理程序 + + 64 字节分区表 + + 启动扇区 + + 开机菜单 + M1:Windows M2:转交 + + + M1 直接加载 + + M2 转交给 Linux 分区启动扇区中的 GRUB + BIOS 读取第 1 个扇区并执行其中的开机管理程序;先装 Windows 再装 Linux,因为安装 Windows 会覆盖 MBR 中的开机管理程序。 + diff --git a/tools/diagram/src/mediator-after.svg b/tools/diagram/src/mediator-after.svg new file mode 100644 index 000000000..583c5353c --- /dev/null +++ b/tools/diagram/src/mediator-after.svg @@ -0,0 +1,49 @@ + + + + + + + + + + + + + + + + 中介者:网状依赖变成星形 + + Alarm + + CoffeePot + + Calendar + + Sprinkler + + Mediator + + + + + 每个对象只把事件交给 Mediator,由它决定通知谁,例如闹钟响了就调用咖啡壶、日历和喷头。 + diff --git a/tools/diagram/src/mediator-before.svg b/tools/diagram/src/mediator-before.svg new file mode 100644 index 000000000..a671a0b10 --- /dev/null +++ b/tools/diagram/src/mediator-before.svg @@ -0,0 +1,49 @@ + + + + + + + + + + + + + + + + 没有中介者:对象之间互相调用 + + Alarm + + CoffeePot + + Calendar + + Sprinkler + + + + + + + 4 个对象之间有 6 条依赖,新增一个对象就要修改其它所有对象。 + diff --git a/tools/diagram/src/mime.svg b/tools/diagram/src/mime.svg new file mode 100644 index 000000000..7073e7181 --- /dev/null +++ b/tools/diagram/src/mime.svg @@ -0,0 +1,52 @@ + + + + + + + + + + + + + + + + MIME:把非 ASCII 内容编码成 ASCII 字符 + 邮件主题 + + 你好 + + UTF-8 编码 + + e4 bd a0 e5 a5 bd + + Base64 + + 5L2g5aW9 + + 邮件首部 + + =?utf-8?b?5L2g5aW9?= + SMTP 最初只能传送 7 位 ASCII 文本。MIME 不改变 SMTP,只规定如何把中文、图片、附件等内容编码成 ASCII: + Base64 把每 3 个字节变成 4 个可打印字符,6 个字节的“你好”编码后是 8 个字符;收件方按首部中注明的 + 字符集和编码方式还原。 + diff --git a/tools/diagram/src/modulation.svg b/tools/diagram/src/modulation.svg new file mode 100644 index 000000000..11cb2c28e --- /dev/null +++ b/tools/diagram/src/modulation.svg @@ -0,0 +1,73 @@ + + + + + + + + + + + + + + + + 带通调制:用载波的振幅、频率或相位表示 0 和 1 + + + + + + + + + + 0 + 1 + 0 + 1 + 1 + 0 + 0 + 1 + 数字信号 + 基带信号 + + 调幅 AM + 1 有载波,0 没有 + + 调频 FM + 1 频率高,0 频率低 + + 调相 PM + 0 和 1 的相位差 180° + + + + + + + + + + + 调相中圆圈标出了 0 和 1 交替处的相位跳变。示意图,每一位画 2 个载波周期(调频中 1 画 4 个)。 + diff --git a/tools/diagram/src/multilevel-cache.svg b/tools/diagram/src/multilevel-cache.svg new file mode 100644 index 000000000..cdad034bd --- /dev/null +++ b/tools/diagram/src/multilevel-cache.svg @@ -0,0 +1,81 @@ + + + + + + + + + + + + + + + + 多级缓存:本地缓存 → Redis → 数据库 + + 应用实例 1 + + + + + + + + 本地缓存 Caffeine + 约 21 ns + + 应用实例 2 + + + + + + + + 本地缓存 Caffeine + 约 21 ns + + + + Redis + 约 71 μs(本机回环) + + + + MySQL + 毫秒级 + + ① 未命中 + + ② 未命中 + + 回填 + + 回填 + + 数据更新:写数据库,删除 Redis,再广播删除本地缓存 + (Redis Pub/Sub 或消息队列) + + + 热点数据在本地内存中直接命中,不经过网络,也不会集中打到 Redis 的某一个节点; + 代价是每个实例各存一份,更新时要通知所有实例,并给本地缓存设置较短的过期时间兜底。 + diff --git a/tools/diagram/src/mvcc-readview.svg b/tools/diagram/src/mvcc-readview.svg new file mode 100644 index 000000000..316238c0b --- /dev/null +++ b/tools/diagram/src/mvcc-readview.svg @@ -0,0 +1,76 @@ + + + + + + + + + + + + + + + + ReadView:沿版本链找到第一个对自己可见的版本 + 读事务开始读取时,事务 103、105 还没有提交,下一个要分配的事务 ID 是 106: + TRX_IDs = {103, 105},TRX_ID_MIN = 103,TRX_ID_MAX = 106 + + 事务 ID + + 101 + 可见 + 已提交 + + 102 + 可见 + 已提交 + + 103 + 不可见 + 在 TRX_IDs 中 + + 104 + 可见 + 已提交 + + 105 + 不可见 + 在 TRX_IDs 中 + + 106 + 不可见 + 之后才开始 + TRX_ID_MIN + TRX_ID_MAX + 读取 id = 1 这一行: + + 版本 x = 'c' + DB_TRX_ID = 103,在 TRX_IDs 中 + 不可见,沿回滚指针找上一个版本 + + + 版本 x = 'b' + DB_TRX_ID = 102,小于 TRX_ID_MIN + 可见,读到 'b' + 可重复读在第一次读取时创建 ReadView,之后一直使用它;提交读每次读取都创建新的 ReadView,103 提交后就能读到 'c'。 + 事务 ID 为示意;读到的结果在 MySQL 8.0 上实测一致。 + diff --git a/tools/diagram/src/mvcc-undo-chain.svg b/tools/diagram/src/mvcc-undo-chain.svg new file mode 100644 index 000000000..5a9c4c479 --- /dev/null +++ b/tools/diagram/src/mvcc-undo-chain.svg @@ -0,0 +1,91 @@ + + + + + + + + + + + + + + + + Undo 版本链:每次修改都把旧版本写入 undo log,用回滚指针连起来 + 当前的数据行 + + id + + x + + DB_TRX_ID + + DB_ROLL_PTR + + 1 + + c + + 103 + + → 版本 2 + UPDATE t SET x = 'c'(事务 103) + + undo log 中的版本 2 + + id + + x + + DB_TRX_ID + + DB_ROLL_PTR + + 1 + + b + + 102 + + → 版本 1 + UPDATE t SET x = 'b'(事务 102) + + undo log 中的版本 1 + + id + + x + + DB_TRX_ID + + DB_ROLL_PTR + + 1 + + a + + 101 + + 无更早版本 + INSERT INTO t VALUES (1, 'a')(事务 101) + DB_TRX_ID 是最后修改这一行的事务 ID,DB_ROLL_PTR 指向上一个版本;事务 ID 为示意。 + diff --git a/tools/diagram/src/mysql-replication.svg b/tools/diagram/src/mysql-replication.svg new file mode 100644 index 000000000..f6eed3d00 --- /dev/null +++ b/tools/diagram/src/mysql-replication.svg @@ -0,0 +1,73 @@ + + + + + + + + + + + + + + + + 主从复制(MySQL 8.0 本机实测的线程) + + 主库 :3307 + + 从库 :3308 + + + + 数据 + + + + + + binlog + + 提交 + + Binlog Dump 线程 + + + I/O 线程 + + 发送 binlog 事件 + + + + + + relay log + + + SQL 线程 + 4 个 worker + + + + + 数据 + + 主库提交时不等从库,从库落后的时间就是复制延迟。8.0.27 起默认 4 个 worker 并行重放(replica_parallel_workers = 4)。 + diff --git a/tools/diagram/src/mysql-rw-split.svg b/tools/diagram/src/mysql-rw-split.svg new file mode 100644 index 000000000..a67227364 --- /dev/null +++ b/tools/diagram/src/mysql-rw-split.svg @@ -0,0 +1,70 @@ + + + + + + + + + + + + + + + + 读写分离与复制延迟 + + + + + + + + + + 应用 + + 代理或数据源路由 + 按 SQL 类型转发 + + + + + 主库:写和实时读 + + + + 从库 1:读 + + + + 从库 2:读 + + + 复制 + + INSERT、UPDATE + + + SELECT + 本机实测:主库一个事务插入 50 万行,从库在 1.4 秒后才一次性看到这些行。刚写完就去从库读,可能读不到自己写的数据。 + 常用做法:写入后的一段时间内这个用户的读请求走主库,或者把要求实时的读请求固定发到主库。 + diff --git a/tools/diagram/src/network-of-networks.svg b/tools/diagram/src/network-of-networks.svg new file mode 100644 index 000000000..a7fb90b02 --- /dev/null +++ b/tools/diagram/src/network-of-networks.svg @@ -0,0 +1,88 @@ + + + + + + + + + + + + + + + + 互联网:网络的网络 + + 公司 A 的局域网 + + 运营商 1 的网络 + + 运营商 2 的网络 + + 学校 B 的局域网 + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + + 每朵云是一个独立的网络,浅青色的路由器把它们连接起来;互联网就是由许多这样的网络互连而成的。 + diff --git a/tools/diagram/src/next-key-locks-v2.svg b/tools/diagram/src/next-key-locks-v2.svg new file mode 100644 index 000000000..68de180a4 --- /dev/null +++ b/tools/diagram/src/next-key-locks-v2.svg @@ -0,0 +1,79 @@ + + + + + + + + + + + + + + + + Next-Key Locks:锁住记录和它前面的间隙 + ① SELECT * FROM t WHERE c = 11 FOR UPDATE + + (10, 11] + + (11, 13) + + -∞ + + c=10 + + c=11 + + c=13 + + c=20 + +∞ + data_locks:c = 11 的记录上是 X(Next-Key Lock),c = 13 上是 X,GAP;插入 c = 12 被阻塞,c = 9、14、21 可以插入 + ② SELECT * FROM t WHERE c BETWEEN 10 AND 20 FOR UPDATE + + (-∞, 10] + + (10, 11] + + (11, 13] + + (13, 20] + + (20, +∞] + + -∞ + + c=10 + + c=11 + + c=13 + + c=20 + +∞ + data_locks:c = 10、11、13、20 和 supremum 上都是 X;插入 c = 9、12、14、21 都被阻塞 + + Next-Key Lock(前开后闭) + + Gap Lock(开区间) + MySQL 8.0,c 上有普通索引,可重复读 + diff --git a/tools/diagram/src/oauth-code-flow.svg b/tools/diagram/src/oauth-code-flow.svg new file mode 100644 index 000000000..6a7aa7639 --- /dev/null +++ b/tools/diagram/src/oauth-code-flow.svg @@ -0,0 +1,64 @@ + + + + + + + + + + + + + + + + OAuth 2.0 授权码流程:令牌由后端换取,不经过浏览器 + + 用户的浏览器 + + + 笔记网站 notes.example.com + + + 授权服务器 id.example.com + + + ① 点击“用账号中心登录” + + ② 302 到 id.example.com/authorize + 带上 state 和 code_challenge + + ③ GET /authorize,用户登录并点击同意 + + ④ 302 到 notes.example.com/callback + ?code=R9Ydi...&state=x7Kp2 + + ⑤ GET /callback?code=R9Ydi...&state=x7Kp2 + + ⑥ POST /token:code + code_verifier + + ⑦ {"access_token": "v-7Dl...", "expires_in": 3600} + + ⑧ GET /userinfo,Authorization: Bearer v-7Dl... + + ⑨ 登录成功,Set-Cookie: 笔记网站自己的会话 + 绿色是笔记网站后端与授权服务器之间的直接请求,访问令牌不经过浏览器;授权码经过浏览器,但只能用一次,换令牌时还要提供 code_verifier。 + diff --git a/tools/diagram/src/observer-intent.svg b/tools/diagram/src/observer-intent.svg new file mode 100644 index 000000000..f3f14cf8c --- /dev/null +++ b/tools/diagram/src/observer-intent.svg @@ -0,0 +1,58 @@ + + + + + + + + + + + + + + + + 观察者:一个主题,多个观察者 + + WeatherData(主题) + + registerObserver(o) + removeObserver(o) + notifyObserver() + observers = [布告板 1, 布告板 2] + + CurrentConditionsDisplay + + update(temp, humidity, pressure) + + + StatisticsDisplay + + update(temp, humidity, pressure) + + + 以后新增的布告板 + + update(temp, humidity, pressure) + + 状态改变时逐个调用 update + 主题只依赖 Observer 接口,不知道具体有哪些布告板;新增布告板时只需要调用 registerObserver 注册,主题的代码不用改。 + diff --git a/tools/diagram/src/observer-run.svg b/tools/diagram/src/observer-run.svg new file mode 100644 index 000000000..f8941114a --- /dev/null +++ b/tools/diagram/src/observer-run.svg @@ -0,0 +1,55 @@ + + + + + + + + + + + + + + + + setMeasurements(1, 1, 1) 之后发生了什么 + + WeatherStation + + + WeatherData + + + CurrentConditionsDisplay + + + StatisticsDisplay + + + setMeasurements(1, 1, 1) + + notifyObserver() + + update(1.0, 1.0, 1.0) + + update(1.0, 1.0, 1.0) + 实际输出:CurrentConditionsDisplay.update: 1.0 1.0 1.0,接着是 StatisticsDisplay.update: 1.0 1.0 1.0,顺序与注册的顺序相同。 + diff --git a/tools/diagram/src/os-kernels.svg b/tools/diagram/src/os-kernels.svg new file mode 100644 index 000000000..28df38a9f --- /dev/null +++ b/tools/diagram/src/os-kernels.svg @@ -0,0 +1,73 @@ + + + + + + + + + + + + + + + + 宏内核与微内核 + 宏内核(Linux) + + + 用户态 + 内核态 + + 应用程序 + + 文件系统 + + 设备驱动 + + 内存管理 + + 进程调度 + + 进程间通信 + + 硬件 + 微内核(Minix、QNX) + + + 用户态 + 内核态 + + 应用程序 + + 文件系统 + + 设备驱动 + + 内存管理 + + 进程调度 + + 进程间通信 + + 硬件 + 微内核把文件系统、驱动等移到用户态,通过消息与内核通信:一个驱动崩溃不会拖垮整个系统,但每次请求多了几次用户态和内核态的切换。 + diff --git a/tools/diagram/src/os-syscall.svg b/tools/diagram/src/os-syscall.svg new file mode 100644 index 000000000..fe27b007f --- /dev/null +++ b/tools/diagram/src/os-syscall.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + 系统调用:open() 从用户态进入内核态 + + + 用户态 + 内核态 + + + + + + fd = open("a.txt", O_RDONLY); + + C 库的 open 包装函数 + + + 系统调用表 + 按系统调用号查找 + + 内核的 open 实现 + + 系统调用号放进寄存器, + 执行陷入指令(x86-64 上是 syscall) + + + 返回文件描述符 + 进入内核时 CPU 切换到特权级,执行完再切回用户态。这一来一回比普通函数调用慢得多,所以频繁的小读写要用缓冲区合并。 + diff --git a/tools/diagram/src/page-translate.svg b/tools/diagram/src/page-translate.svg new file mode 100644 index 000000000..13520ac59 --- /dev/null +++ b/tools/diagram/src/page-translate.svg @@ -0,0 +1,145 @@ + + + + + + + + + + + + + + + + 地址转换:虚拟地址 0x3ABC + 虚拟地址 + + 0 + + 0 + + 1 + + 1 + + 1 + + 0 + + 1 + + 0 + + 1 + + 0 + + 1 + + 1 + + 1 + + 1 + + 0 + + 0 + 页号 3 + 偏移量 0xABC(12 位) + 页表 + + 页框号 + + 存在 + 0 + + 010 + + 1 + 1 + + 111 + + 1 + 2 + + --- + + 0 + 3 + + 101 + + 1 + 4 + + --- + + 0 + 5 + + 000 + + 1 + ……共 16 项 + + 用页号作下标 + 物理地址 + + 1 + + 0 + + 1 + + 1 + + 0 + + 1 + + 0 + + 1 + + 0 + + 1 + + 1 + + 1 + + 1 + + 0 + + 0 + + 页框号 101(5) + + 偏移量原样复制 + = 0x5ABC + 4 KB 的页需要 12 位偏移量,16 位地址剩下的 4 位就是页号,页表一共 16 项。 + 如果查到的“存在”位是 0(例如页 4),说明这一页不在内存中,CPU 触发缺页中断。 + diff --git a/tools/diagram/src/paxos-roles.svg b/tools/diagram/src/paxos-roles.svg new file mode 100644 index 000000000..b23788deb --- /dev/null +++ b/tools/diagram/src/paxos-roles.svg @@ -0,0 +1,58 @@ + + + + + + + + + + + + + + + + Paxos 的三类角色 + + Proposer A + + Proposer B + + Acceptor X + + Acceptor Y + + Acceptor Z + + Learner + + + + + + + + + + Prepare、Accept + 接受的提议 + Proposer 向所有 Acceptor 发请求,超过一半 Acceptor 接受同一个提议,这个值就被选定;Learner 只负责得知结果。 + diff --git a/tools/diagram/src/philosophers.svg b/tools/diagram/src/philosophers.svg new file mode 100644 index 000000000..82f5f51ae --- /dev/null +++ b/tools/diagram/src/philosophers.svg @@ -0,0 +1,68 @@ + + + + + + + + + + + + + + + + 哲学家进餐:5 个人、5 根筷子 + + + P0 + + + 0 + + P1 + + + 1 + + P2 + + + 2 + + P3 + + + 3 + + P4 + + + 4 + 如果每个人都先拿编号与自己相同的筷子: + P0 拿 0、P1 拿 1……P4 拿 4,再去拿另一根: + P0 等 4、P1 等 0……P4 等 3,形成环路,死锁。 + 解决方法: + ① 只有左右两根都能拿到时才拿(下面的代码); + ② 都先拿编号小的那根:P0 改为先拿 0 再拿 4, + 与 P1 争抢 0,环路被打破; + ③ 最多允许 4 个人同时拿筷子。 + diff --git a/tools/diagram/src/pipe.svg b/tools/diagram/src/pipe.svg new file mode 100644 index 000000000..5d3e6ea2d --- /dev/null +++ b/tools/diagram/src/pipe.svg @@ -0,0 +1,54 @@ + + + + + + + + + + + + + + + + 管道:fork 之后父进程写、子进程读 + + 父进程 + + 子进程 + + fd[1] 写端 + + fd[0] 关闭 + + fd[0] 读端 + + fd[1] 关闭 + + 内核中的管道缓冲区 + Linux 默认 64 KB + + + write(fd[1], "hello") + read(fd[0], buf) + pipe 返回两个文件描述符,fork 后父子进程都持有两端,各自关闭不用的一端,数据只能单向流动。 + diff --git a/tools/diagram/src/process-concurrent.svg b/tools/diagram/src/process-concurrent.svg new file mode 100644 index 000000000..94b9eac0f --- /dev/null +++ b/tools/diagram/src/process-concurrent.svg @@ -0,0 +1,57 @@ + + + + + + + + + + + + + + + + 4 个进程在一个 CPU 上并发执行 + 进程 A + + 进程 B + + 进程 C + + 进程 D + + + + + + + + + + + + + + + 时间 + 任一时刻只有一个进程在 CPU 上运行;操作系统按时间片轮流切换,宏观上看 4 个进程在同时推进。 + diff --git a/tools/diagram/src/process-mlfq.svg b/tools/diagram/src/process-mlfq.svg new file mode 100644 index 000000000..9ba84849c --- /dev/null +++ b/tools/diagram/src/process-mlfq.svg @@ -0,0 +1,114 @@ + + + + + + + + + + + + + + + + 多级反馈队列:一个需要 100 个时间片的进程 + 队列 1 + + + + + + + + + 时间片 1 + 累计运行 1 + + 队列 2 + + + + + + + + + 时间片 2 + 累计运行 3 + + 队列 3 + + + + + + + + + 时间片 4 + 累计运行 7 + + 队列 4 + + + + + + + + 时间片 8 + 累计运行 15 + + 队列 5 + + + + + + + + 时间片 16 + 累计运行 31 + + 队列 6 + + + + + + + + 时间片 32 + 累计运行 63 + + 队列 7 + + + + + + + + 时间片 64 + 累计运行 100,完成 + 没用完时间片就进入下一级。这个进程只被调度 7 次,而时间片固定为 1 时要调度 100 次;新来的短进程在上面的高优先级队列中很快完成。 + diff --git a/tools/diagram/src/process-rr.svg b/tools/diagram/src/process-rr.svg new file mode 100644 index 000000000..b476548ca --- /dev/null +++ b/tools/diagram/src/process-rr.svg @@ -0,0 +1,62 @@ + + + + + + + + + + + + + + + + 时间片轮转:时间片为 2,A、B、C 分别需要运行 5、3、2 + + A + + B + + C + + A + + B + + A + 0 + 1 + 2 + 3 + 4 + 5 + 6 + 7 + 8 + 9 + 10 + C 在 6 结束 + B 在 9 结束 + A 在 10 结束 + 用完时间片的进程回到队尾。平均完成时间 (10 + 9 + 6) / 3 ≈ 8.3;时间片越小响应越快,但切换次数越多, + 每次切换都要保存和恢复上下文。 + diff --git a/tools/diagram/src/process-states.svg b/tools/diagram/src/process-states.svg new file mode 100644 index 000000000..852a184bc --- /dev/null +++ b/tools/diagram/src/process-states.svg @@ -0,0 +1,57 @@ + + + + + + + + + + + + + + + + 进程状态的切换 + + 新建 + + 就绪 + + 运行 + + 阻塞 + + 终止 + + 创建完成 + + 被调度 + + 时间片用完 + + 结束 + + 等待 I/O 或事件 + + I/O 完成 + 只有就绪和运行可以相互转换;阻塞的进程即使 CPU 空闲也不能运行,要先回到就绪队列。 + diff --git a/tools/diagram/src/process-threads.svg b/tools/diagram/src/process-threads.svg new file mode 100644 index 000000000..6a37f0b65 --- /dev/null +++ b/tools/diagram/src/process-threads.svg @@ -0,0 +1,67 @@ + + + + + + + + + + + + + + + + 浏览器进程中的多个线程 + + 浏览器进程 + 所有线程共享: + + 代码 + + 全局数据 + + 堆 + + 打开的文件、网络连接 + + 网络请求线程 + + 自己的栈 + + 寄存器、程序计数器 + 独立调度 + + 事件响应线程 + + 自己的栈 + + 寄存器、程序计数器 + 独立调度 + + 渲染线程 + + 自己的栈 + + 寄存器、程序计数器 + 独立调度 + 线程共享进程的内存,可以直接读写同一个变量通信;每个线程只有自己的栈和寄存器,所以创建和切换的开销比进程小。 + diff --git a/tools/diagram/src/raft-election.svg b/tools/diagram/src/raft-election.svg new file mode 100644 index 000000000..add22dc08 --- /dev/null +++ b/tools/diagram/src/raft-election.svg @@ -0,0 +1,74 @@ + + + + + + + + + + + + + + + + Raft 选举:A 的竞选计时器最先到期 + 节点 A + 超时 180 ms + + Follower,等待心跳 + + + Leader,任期 1 + 节点 B + 超时 260 ms + + Follower + + + + + + + 原定 260 ms 超时 + 节点 C + 超时 230 ms + + Follower + + + + + + + 原定 230 ms 超时 + 180 ms 超时:成为候选人,任期加 1,投自己一票,向 B、C 请求投票 + + B、C 投票给 A,3 票中得到 3 票 + 浅青色短条是 Leader 当选后立即发出、之后每 50 ms 发一次的心跳,Follower 收到后重新计时 + + 0 ms + 100 ms + 200 ms + 300 ms + 400 ms + 每个节点的竞选超时在 150~300 ms 中随机选取,通常只有一个节点先超时,它在别人超时前就能拿到多数票。 + diff --git a/tools/diagram/src/raft-log.svg b/tools/diagram/src/raft-log.svg new file mode 100644 index 000000000..e67eb8364 --- /dev/null +++ b/tools/diagram/src/raft-log.svg @@ -0,0 +1,88 @@ + + + + + + + + + + + + + + + + Raft 日志复制:SET x = 5 + ① 写入 Leader 的日志 + Leader + + 1 y=1 + + 1 x=5 + B + + 1 y=1 + + C + + 1 y=1 + + ② 复制给 Follower + + 1 y=1 + + 1 x=5 + + 1 y=1 + + 1 x=5 + + 1 y=1 + + ③ 多数写入后提交 + + 1 y=1 + + 1 x=5 + + 1 y=1 + + 1 x=5 + + 1 y=1 + + ④ 心跳通知 Follower 提交 + + 1 y=1 + + 1 x=5 + + 1 y=1 + + 1 x=5 + + 1 y=1 + + 1 x=5 + 格子中是任期号和命令。浅青色已提交,淡紫色已写入日志但未提交。 + 第 ③ 步时 C 还没有写入,但 Leader 和 B 已经构成 3 个节点中的多数,Leader 就可以提交、执行并回复客户端; + 已提交的日志一定在多数节点上,新 Leader 也一定包含它,所以不会丢失。C 落后或宕机恢复后,Leader 再把缺少的日志补给它。 + diff --git a/tools/diagram/src/raft-split.svg b/tools/diagram/src/raft-split.svg new file mode 100644 index 000000000..8f096d4f9 --- /dev/null +++ b/tools/diagram/src/raft-split.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + Raft 选举:选票被瓜分时进入下一个任期 + 任期 4 + + 节点 A + 投 B + + 节点 B + 候选人,2 票 + + 节点 C + 投 D + + 节点 D + 候选人,2 票 + B、D 同时超时,各得 2 票,都不足 3 票(4 个节点的多数),没有 Leader + 任期 5 + + 节点 A + 投 D + + 节点 B + 投 D + + 节点 C + 投 D + + 节点 D + 候选人,4 票 + 重新随机超时,D 先超时,得到全部选票,成为 Leader + 淡紫色是候选人,浅青色是当选的 Leader。随机超时让两个节点再次同时超时的概率很低。 + diff --git a/tools/diagram/src/redis-aof-rewrite.svg b/tools/diagram/src/redis-aof-rewrite.svg new file mode 100644 index 000000000..13dff8f69 --- /dev/null +++ b/tools/diagram/src/redis-aof-rewrite.svg @@ -0,0 +1,71 @@ + + + + + + + + + + + + + + + + AOF 重写:对 counter 执行 1000 次 INCR + 重写前 + + + + + + appendonly.aof.1.incr.aof + 27023 字节,1000 条命令 + + + + + + *2 $4 INCR $7 counter + *2 $4 INCR $7 counter + *2 $4 INCR $7 counter + …… + + BGREWRITEAOF + 子进程按当前数据 + 重新生成 + 重写后 + + + + + + appendonly.aof.2.base.rdb + 105 字节,RDB 格式:counter = 1000 + + + + + + appendonly.aof.2.incr.aof + 0 字节,之后的写命令追加到这里 + Redis 7.4 实测,文件在 appendonlydir 目录中,由 appendonly.aof.manifest 记录;aof-use-rdb-preamble 默认开启,基础文件用 RDB 格式。 + diff --git a/tools/diagram/src/redis-article-hash.svg b/tools/diagram/src/redis-article-hash.svg new file mode 100644 index 000000000..d0ac62044 --- /dev/null +++ b/tools/diagram/src/redis-article-hash.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + 文章信息:一篇文章是一个 HASH + + + article:1001 + article + 命名空间 + 1001 + ID + + + 字段 + + 值 + + title + + Redis 为什么快 + + author + + user:2001 + + time + + 1760923800(2025-10-20 09:30) + + votes + + 3 + 相当于关系型数据库中 article 表里 id = 1001 的一行。 + diff --git a/tools/diagram/src/redis-article-vote.svg b/tools/diagram/src/redis-article-vote.svg new file mode 100644 index 000000000..e9d15569b --- /dev/null +++ b/tools/diagram/src/redis-article-vote.svg @@ -0,0 +1,71 @@ + + + + + + + + + + + + + + + + 点赞:user:2004 给 article:1001 点赞 + + + user:2004 + + + ① SADD voted:1001 user:2004 + + 返回 1:第一次点赞 + + 返回 0:点过了 + + 拒绝 + + ② HINCRBY article:1001 votes 1 + → 4 + + ③ ZINCRBY votes: 1 article:1001 + → 4 + + + + voted:1001(SET) + + user:2002 + + user:2003 + + user:2005 + + user:2004 + 新增 + + + EXPIRE 604800:7 天后自动删除 + 超过一周不能再点赞,也不再占用内存 + 已点赞的用户记在集合里,SADD 的返回值说明这个用户是否点过,防止重复点赞。 + 三步可以放进一个 Lua 脚本中原子执行,避免只执行了一部分。 + diff --git a/tools/diagram/src/redis-article-zsets.svg b/tools/diagram/src/redis-article-zsets.svg new file mode 100644 index 000000000..4e1a90d6b --- /dev/null +++ b/tools/diagram/src/redis-article-zsets.svg @@ -0,0 +1,73 @@ + + + + + + + + + + + + + + + + 排序:两个有序集合,成员都是文章 ID + time:(分值是发布时间) + + 成员 + + 分值 + + article:1001 + + 1760923800 + + article:1002 + + 1761026400 + + article:1003 + + 1761135300 + ZRANGE time: 0 9 REV + 最新的 10 篇:1003、1002、1001 + votes:(分值是点赞数) + + 成员 + + 分值 + + article:1003 + + 1 + + article:1001 + + 4 + + article:1002 + + 8 + ZRANGE votes: 0 9 REV + 点赞最多的 10 篇:1002、1001、1003 + 有序集合按分值从小到大排列,REV 表示倒序取;取到文章 ID 后再用 HGETALL 读出每篇文章的信息。 + diff --git a/tools/diagram/src/redis-event-loop.svg b/tools/diagram/src/redis-event-loop.svg new file mode 100644 index 000000000..c31a6a2e2 --- /dev/null +++ b/tools/diagram/src/redis-event-loop.svg @@ -0,0 +1,55 @@ + + + + + + + + + + + + + + + + 事件循环 + + 初始化服务器 + + ① 找到最近的时间事件 + 例如 serverCron 还有 30 ms 到期 + + ② epoll_wait 最多等待 30 ms + 期间有文件事件就提前返回 + + + ③ 处理已就绪的文件事件 + 接受连接、执行命令、写回结果 + + + ④ 处理已到期的时间事件 + serverCron 默认每 100 ms 执行一次 + + + + 直到关闭 + 等待时间由最近的时间事件决定:既不会一直阻塞在 epoll_wait 上,也不会空转。 + diff --git a/tools/diagram/src/redis-file-event.svg b/tools/diagram/src/redis-file-event.svg new file mode 100644 index 000000000..c0ddebd6b --- /dev/null +++ b/tools/diagram/src/redis-file-event.svg @@ -0,0 +1,84 @@ + + + + + + + + + + + + + + + + 文件事件:一个线程处理多个客户端 + + + + + 客户端 A + + 新连接 + + + + + 客户端 B + + 发来 GET k + + + + + 客户端 C + + 可以写回结果 + + I/O 多路复用 + epoll_wait + 同时监听所有套接字 + + + + A + + B + + C + 就绪的事件 + + + 分派 + + 连接应答处理器 + A:accept 新连接 + + + 命令请求处理器 + B:读出并执行 GET k + + + 命令回复处理器 + C:把结果写给客户端 + + 执行命令的始终是一个线程:事件按顺序逐个处理,所以单条命令是原子的,但一条慢命令会阻塞其它客户端。 + diff --git a/tools/diagram/src/redis-hash.svg b/tools/diagram/src/redis-hash.svg new file mode 100644 index 000000000..0d339f57b --- /dev/null +++ b/tools/diagram/src/redis-hash.svg @@ -0,0 +1,57 @@ + + + + + + + + + + + + + + + + HASH + + + user:1001 + + + 字段 + + 值 + + name + + alice + + age + + 25 + + city + + hangzhou + HGET、HINCRBY + 只读写一个字段 + 一个键下存放多个字段和值,适合存储对象,修改一个字段不用读出整个对象。 + diff --git a/tools/diagram/src/redis-list.svg b/tools/diagram/src/redis-list.svg new file mode 100644 index 000000000..76ced145b --- /dev/null +++ b/tools/diagram/src/redis-list.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + LIST + + + orders:queue + + + 1024 + 0 + -3 + + 1025 + 1 + -2 + + 1026 + 2 + -1 + 下标 + 负数下标 + + + + + LPUSH / LPOP + RPUSH / RPOP + 按插入顺序排列,元素可以重复;在两端插入和弹出是 O(1),按下标访问要从一端数过去。 + diff --git a/tools/diagram/src/redis-replica-chain.svg b/tools/diagram/src/redis-replica-chain.svg new file mode 100644 index 000000000..2be345868 --- /dev/null +++ b/tools/diagram/src/redis-replica-chain.svg @@ -0,0 +1,90 @@ + + + + + + + + + + + + + + + + 主从链:中间层分担复制 + + + + 主服务器 + + + + + 从服务器 1 + + + + + + + + + + + + + + + + + 从服务器 2 + + + + + + + + + + + + + + + + + 从服务器 3 + + + + + + + + + + + + + 中间层既是上一层的从服务器,又是下一层的主服务器;主服务器只需向 3 台发送数据,而不是 12 台。 + diff --git a/tools/diagram/src/redis-sentinel-failover.svg b/tools/diagram/src/redis-sentinel-failover.svg new file mode 100644 index 000000000..5ba926c72 --- /dev/null +++ b/tools/diagram/src/redis-sentinel-failover.svg @@ -0,0 +1,76 @@ + + + + + + + + + + + + + + + + 哨兵故障转移:kill -9 主服务器之后(本机实测) + + + 0 s + + 1 s + + 2 s + + 3 s + + 4 s + + 5 s + + 6 s + + 哨兵在 down-after-milliseconds(5 秒)内收不到回复 + + + + kill -9 主服务器 6400 + + + 5.04 s ① 主观下线 +sdown + + + 5.14 s ② 客观下线 +odown,3 个哨兵都同意(quorum 2) + + + 5.22 s ③ 投票选出领头哨兵 +elected-leader + + + 5.28 s ④ 选中 6402 +selected-slave + + + 6.37 s ⑤ 6402 升为主服务器 +promoted-slave + + + 6.47 s ⑥ 通知切换 +switch-master + 1 主 2 从、3 个哨兵,quorum 为 2。约 6.5 秒后客户端从哨兵查到新地址 6402,之前写入的 order:1024 仍在; + 重启的 6400 被哨兵改为 6402 的从服务器。超时检测占了大部分时间,down-after-milliseconds 越小切换越快, + 但网络抖动时也越容易误判。 + diff --git a/tools/diagram/src/redis-set.svg b/tools/diagram/src/redis-set.svg new file mode 100644 index 000000000..d65db1892 --- /dev/null +++ b/tools/diagram/src/redis-set.svg @@ -0,0 +1,45 @@ + + + + + + + + + + + + + + + + SET + + + cache + nosql + redis + mysql + article:7:tags + article:8:tags + SINTER 得到交集 redis + 元素不重复, + 没有顺序 + diff --git a/tools/diagram/src/redis-skiplist.svg b/tools/diagram/src/redis-skiplist.svg new file mode 100644 index 000000000..53406c0ef --- /dev/null +++ b/tools/diagram/src/redis-skiplist.svg @@ -0,0 +1,104 @@ + + + + + + + + + + + + + + + + 跳跃表:查找 26 + 第 2 层 + + head + + + + 15 + + 30 + + + 第 1 层 + + head + + + + + + 7 + + 15 + + 22 + + 30 + + + + + 第 0 层 + + head + + + + + + + + + + + 3 + + 7 + + 11 + + 15 + + 19 + + 22 + + 26 + + 30 + + 37 + + + + + + 30 > 26,下降 + 30 > 26,下降 + 找到 + 从最高层出发,下一个节点小于 26 就向右走,大于 26 就下降一层。 + 共比较 5 次(15、30、22、30、26);在最底层的链表中逐个查找要比较 7 次,节点越多差距越大。 + diff --git a/tools/diagram/src/redis-string.svg b/tools/diagram/src/redis-string.svg new file mode 100644 index 000000000..1fe0e4222 --- /dev/null +++ b/tools/diagram/src/redis-string.svg @@ -0,0 +1,49 @@ + + + + + + + + + + + + + + + + STRING + + + user:1001:name + + + alice + 字符串 + + + page:views + + + 42 + 整数,可以 INCR 自增 + 一个键对应一个值,值可以是字符串、整数或浮点数,最大 512 MB。 + diff --git a/tools/diagram/src/redis-zset.svg b/tools/diagram/src/redis-zset.svg new file mode 100644 index 000000000..23a77e2e8 --- /dev/null +++ b/tools/diagram/src/redis-zset.svg @@ -0,0 +1,62 @@ + + + + + + + + + + + + + + + + ZSET + + + rank:score + + + 成员 + + 分值 + + bob + + 85 + + 名次 0 + + alice + + 92 + + 名次 1 + + carol + + 97 + + 名次 2 + 按分值从小到大排列,名次从 0 开始 + 成员不重复,每个成员带一个分值;可以按名次或分值范围查询,适合排行榜。 + diff --git a/tools/diagram/src/second-chance.svg b/tools/diagram/src/second-chance.svg new file mode 100644 index 000000000..f41d3c914 --- /dev/null +++ b/tools/diagram/src/second-chance.svg @@ -0,0 +1,76 @@ + + + + + + + + + + + + + + + + 第二次机会:访问过的页面再给一次机会 + (a) 时间 20 缺页 + + A R=1 + 装入 0 + + + B R=0 + 装入 3 + + + C R=1 + 装入 7 + + + D R=0 + 装入 8 + + + E R=1 + 装入 12 + 最老的 A 的 R = 1:清零,移到队尾,装入时间改为 20;再看 B,R = 0,换出 B + (b) 处理之后 + + C R=1 + 装入 7 + + + D R=0 + 装入 8 + + + E R=1 + 装入 12 + + + A R=0 + 装入 20 + + + 新页 R=1 + 装入 20 + 队头是最早装入的页面。FIFO 会直接换出刚被访问过的 A,第二次机会算法换出的是又老又没被访问的 B。 + diff --git a/tools/diagram/src/segments.svg b/tools/diagram/src/segments.svg new file mode 100644 index 000000000..9b3ccd967 --- /dev/null +++ b/tools/diagram/src/segments.svg @@ -0,0 +1,91 @@ + + + + + + + + + + + + + + + + 分段:每个段是独立的地址空间 + + 代码 + 段 0 + 长 12K + + 全局数据 + 段 1 + 长 4K + + 堆 + 段 2 + 长 8K + + 可增长 + + 栈 + 段 3 + 长 8K + + 可增长 + 段表 + + 段号 + + 基址 + + 长度 + + 0 + + 0x4000 + + 12K + + 1 + + 0x9000 + + 4K + + 2 + + 0xC000 + + 8K + + 3 + + 0x1C000 + + 8K + 地址 = (段号 2, 偏移 0x300) + 0x300 < 8K,没有越界 + 物理地址 = 0xC000 + 0x300 = 0xC300 + 偏移 ≥ 段长时触发越界异常 + 各段长度不同、可以单独增长,并且可以按段设置权限(例如代码段只读);但段的大小不固定, + 内存中会留下大小不一的空闲碎片。段页式在每个段内再分页,兼顾两者。 + diff --git a/tools/diagram/src/shard-horizontal.svg b/tools/diagram/src/shard-horizontal.svg new file mode 100644 index 000000000..3eb2c1404 --- /dev/null +++ b/tools/diagram/src/shard-horizontal.svg @@ -0,0 +1,87 @@ + + + + + + + + + + + + + + + + 水平切分:按 user_id % 2 把行分到两个库 + orders(切分前) + + order_id + + user_id + + 1024 + + 7 + + 1025 + + 8 + + 1026 + + 9 + + 1027 + + 10 + 库 0 的 orders + + order_id + + user_id + + 1025 + + 8 + + 1027 + + 10 + 库 1 的 orders + + order_id + + user_id + + 1024 + + 7 + + 1026 + + 9 + + + 表结构相同,每个库只存一部分行 + 按 user_id 查询只访问一个库; + 按其它条件查询要访问所有库 + 同一个用户的订单落在同一个库,查询“某用户的订单”不需要跨库。 + diff --git a/tools/diagram/src/shard-vertical.svg b/tools/diagram/src/shard-vertical.svg new file mode 100644 index 000000000..f746e1844 --- /dev/null +++ b/tools/diagram/src/shard-vertical.svg @@ -0,0 +1,76 @@ + + + + + + + + + + + + + + + + 垂直切分:按列拆成两张表 + product(切分前) + + id + + 1024 + + name + + 键盘 + + price + + 199 + + detail_html + + <div>…20 KB…</div> + + + + id + + 1024 + + name + + 键盘 + + price + + 199 + product:常用的列 + + id + + 1024 + + detail_html + + <div>…20 KB…</div> + product_detail:大字段 + 列表页只查 product,一页能放下更多行;打开详情时再按 id 查 product_detail。 + diff --git a/tools/diagram/src/short-url.svg b/tools/diagram/src/short-url.svg new file mode 100644 index 000000000..2d03c47c6 --- /dev/null +++ b/tools/diagram/src/short-url.svg @@ -0,0 +1,100 @@ + + + + + + + + + + + + + + + + 短链系统:生成时取 ID 转 Base62,访问时查缓存返回 302 + 生成 + + + 运营人员 + + + + + + + + + + 短链服务 + + POST /shorten + + + 发号器 + + 号段 100000000~100000999 + + 本次取到 100000000 + + 100000000 转 Base62 → 6LAze + + + + MySQL + + 6LAze → + https://shop.example.com/item/1024 + + 访问 + + + + + 浏览器 + + + + + + + + + + 短链服务 + + ① GET s.example/6LAze + + + + Redis + + ② 查 6LAze + + 命中:返回长链接 + 未命中时查 MySQL + 再写入缓存 + + + ③ 302 Found + Location: https://shop.example.com/... + 浏览器收到 302 后再访问长链接。用 301 时浏览器会缓存跳转,之后的点击不再经过短链服务,无法统计点击量。 + diff --git a/tools/diagram/src/snowflake.svg b/tools/diagram/src/snowflake.svg new file mode 100644 index 000000000..1df1330cb --- /dev/null +++ b/tools/diagram/src/snowflake.svg @@ -0,0 +1,56 @@ + + + + + + + + + + + + + + + + 雪花算法:64 位 ID 的组成 + + 0 + 符号位 + 1 位,固定为 0 + + 00001010010110100100001001111001110111101 + 时间戳 + 41 位:距 2024-01-01 的毫秒数 + + 0000000101 + 机器 ID + 10 位:0~1023 + + 000000000000 + 序号 + 12 位:同一毫秒内 0~4095 + 本机生成的一个 ID:372990889737342976 + 时间戳 88927957949 ms → 2026-10-26 06:12:37.949(UTC),机器 ID 5,序号 0 + 41 位毫秒数可以用 69.7 年;每台机器每毫秒最多 4096 个,即每秒约 409 万个。 + 高位是时间,多台机器生成的 ID 整体上按时间递增,作为 InnoDB 主键时基本是顺序插入。 + 需要注意的是,ID 依赖本机时钟:时钟回拨后可能生成重复的 ID,生成器发现当前时间小于上次的时间时, + 回拨很小就等待追上,较大就报错,由运维排查时钟同步。 + diff --git a/tools/diagram/src/sql-flow.svg b/tools/diagram/src/sql-flow.svg new file mode 100644 index 000000000..2db2a9479 --- /dev/null +++ b/tools/diagram/src/sql-flow.svg @@ -0,0 +1,95 @@ + + + + + + + + + + + + + + + + 一条 SELECT 在 MySQL 中的执行过程 + + + + + + SELECT * FROM orders WHERE user_id = 1024 +   AND create_time > '2025-01-10' + + Server 层 + + 连接器 + 校验用户名、密码和权限,维持连接 + + 解析器 + 词法、语法分析,生成语法树 + 写成 selec 时报 ERROR 1064 + + + 预处理 + 检查表和列是否存在 + 写成 amout 时报 ERROR 1054 Unknown column + + + 优化器 + 估算各种执行方式的代价, + 选择代价最小的(右表) + + + 执行器 + 按执行计划调用存储引擎的接口,过滤、返回结果 + + + 优化器估算的代价(optimizer trace) + + 方案 + + 估算行数 + + 代价 + + 全表扫描 + + 1978736 行 + + 222512 + + idx_create_time + + 989368 行 + + 934036 + + idx_user_status_time + + 20 行 + + 2.27 + + InnoDB:先在 Buffer Pool 中找数据页,不在内存中才从磁盘读入 + 按 idx_user_status_time 找到 20 条索引记录,用索引条件下推过滤 create_time,再回表取整行 + + diff --git a/tools/diagram/src/state-gumball.svg b/tools/diagram/src/state-gumball.svg new file mode 100644 index 000000000..c2c2172c8 --- /dev/null +++ b/tools/diagram/src/state-gumball.svg @@ -0,0 +1,57 @@ + + + + + + + + + + + + + + + + 糖果机的状态转移 + + NoQuarterState + 没有投币 + + HasQuarterState + 已投币 + + SoldState + 出货中 + + SoldOutState + 售罄 + + insertQuarter() + + ejectQuarter() + + turnCrank() + + dispense(),count > 0 + + dispense(),count == 0 + GumballMachine 把每个操作转交给当前状态对象,状态对象在合适的时候调用 setState 切换状态,避免一大串 if-else。 + diff --git a/tools/diagram/src/static-link.svg b/tools/diagram/src/static-link.svg new file mode 100644 index 000000000..4bdb8ea4a --- /dev/null +++ b/tools/diagram/src/static-link.svg @@ -0,0 +1,85 @@ + + + + + + + + + + + + + + + + 静态链接:符号解析和重定位 + + + + + + // main.c + int sum(int *a, int n); + int main() { return sum(arr, 2); } + + + + + + // sum.c + int sum(int *a, int n) { +   ... } + + + + + + main.o + 引用 sum,地址未知 + + + + + + sum.o + 定义 sum + + + + 链接器 ld + + + + + + + + + prog + 可执行目标文件 + ① 符号解析:把 main.o 中 + 对 sum 的引用对应到 + sum.o 中的定义 + ② 重定位:合并代码后确定 + sum 的地址,填回 main 中 + 调用指令的地址字段 + 找不到定义时报 undefined reference,出现两个同名的强定义时报 multiple definition,都是在符号解析这一步发现的。 + diff --git a/tools/diagram/src/template-recipe.svg b/tools/diagram/src/template-recipe.svg new file mode 100644 index 000000000..ed04f7e2f --- /dev/null +++ b/tools/diagram/src/template-recipe.svg @@ -0,0 +1,59 @@ + + + + + + + + + + + + + + + + 模板方法:流程固定在父类,变化的步骤交给子类 + CaffeineBeverage.prepareRecipe() + + boilWater() + + brew() + + + + Coffee.brew + + Tea.brew + + pourInCup() + + + addCondiments() + + + + Coffee.addCondiments + + Tea.addCondiments + 咖啡 + 茶 + 灰色步骤在父类中实现,所有饮料共用;淡紫色是抽象方法,由子类实现。prepareRecipe 是 final 的,子类不能改变步骤的顺序。 + diff --git a/tools/diagram/src/tls-handshake.svg b/tools/diagram/src/tls-handshake.svg new file mode 100644 index 000000000..739766096 --- /dev/null +++ b/tools/diagram/src/tls-handshake.svg @@ -0,0 +1,82 @@ + + + + + + + + + + + + + + + + TLS 1.2 与 TLS 1.3 的握手(本机 openssl 实测的报文顺序) + TLS 1.2:www.baidu.com + + + 客户端 + 服务器 + + ClientHello + + ServerHello + + Certificate + + ServerKeyExchange + ECDHE 公钥 + 签名 + + ServerHelloDone + + ClientKeyExchange + ECDHE 公钥 + + ChangeCipherSpec, Finished + + ChangeCipherSpec, Finished + + HTTP 请求(加密) + 2 个 RTT 后才能发送请求 + TLS 1.3:www.example.com + + + 客户端 + 服务器 + + ClientHello + key_share + 带上 ECDHE 公钥 + + ServerHello + key_share + + {EncryptedExtensions} + + {Certificate} + + {CertificateVerify} + 用私钥签名 + + {Finished} + + {Finished} + HTTP 请求 + 1 个 RTT 后就能发送请求 + diff --git a/tools/diagram/src/tool-call-text.svg b/tools/diagram/src/tool-call-text.svg new file mode 100644 index 000000000..92b2b023f --- /dev/null +++ b/tools/diagram/src/tool-call-text.svg @@ -0,0 +1,69 @@ + + + + + + + + + + + + + + + + Qwen2.5-7B 实际收到和输出的文本 + + <|im_start|>system + 系统消息 + + 你是电商客服助手,回答要简短。 + + # Tools ... <tools> + 推理服务按模板 + + {"name": "get_order", "description": "按订单号查询…"} + 拼入的工具定义 + + {"name": "get_logistics", ...}</tools> + + <|im_start|>user 订单 1024 到哪了? + 用户消息 + + <|im_start|>assistant + + <tool_call> + 模型生成的文本 + + {"name": "get_order", "arguments": {"order_id": "1024"}} + + </tool_call> + + <|im_start|>user + 应用执行工具后, + + <tool_response>{"status": "已发货", "tracking_no": "SF1234567"} + 把结果放回去 + + </tool_response> + 第 2 次调用时,上面的全部文本加上工具结果一起重新发给模型,共 327 个 Token;第 1 次是 255 个。 + tool_calls、tool 角色这些结构化字段,在模型看来都只是这样一段特定格式的文本。 + diff --git a/tools/diagram/src/txn-dirty-read.svg b/tools/diagram/src/txn-dirty-read.svg new file mode 100644 index 000000000..48e300656 --- /dev/null +++ b/tools/diagram/src/txn-dirty-read.svg @@ -0,0 +1,57 @@ + + + + + + + + + + + + + + + + 读脏数据:读到了另一个事务没有提交的修改 + + 事务 T1 + + + 事务 T2 + READ UNCOMMITTED + + 时间 + + + BEGIN + + UPDATE account SET balance = 200 WHERE id = 1 + + SELECT balance FROM account WHERE id = 1 + → 200 + + ROLLBACK + + SELECT balance FROM account WHERE id = 1 + → 100 + T2 读到的 200 从来没有提交过。 + T2 的隔离级别为 READ COMMITTED 及以上时,第一次读到的是 100。 + diff --git a/tools/diagram/src/txn-flow.svg b/tools/diagram/src/txn-flow.svg new file mode 100644 index 000000000..7971e3086 --- /dev/null +++ b/tools/diagram/src/txn-flow.svg @@ -0,0 +1,62 @@ + + + + + + + + + + + + + + + + 事务:要么全部提交,要么全部回滚 + 从 A 账户向 B 账户转账 30 元 + + 一致的状态 + A = 100 + B = 0 + + 中间状态 + A = 70 + B = 0 + + 中间状态 + A = 70 + B = 30 + + 一致的状态 + A = 70 + B = 30 + + A − 30 + + B + 30 + + COMMIT + + + 出错或执行 ROLLBACK:用 undo log 撤销已做的修改,回到初始状态 + 在提交读及以上的隔离级别下,中间状态只有当前事务看得到;提交后修改才对其它事务可见,并由 redo log 保证不会丢失。 + A、B 两个账户的余额总和在事务前后都是 100,这就是一致性。 + diff --git a/tools/diagram/src/txn-lost-update.svg b/tools/diagram/src/txn-lost-update.svg new file mode 100644 index 000000000..4d0ef5781 --- /dev/null +++ b/tools/diagram/src/txn-lost-update.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + 丢失修改:两个事务基于同一个旧值计算后写回 + + 事务 T1:取出 30 元 + REPEATABLE READ + + + 事务 T2:存入 50 元 + REPEATABLE READ + + 时间 + + + SELECT balance FROM account WHERE id = 1 + → 100 + + SELECT balance FROM account WHERE id = 1 + → 100 + + UPDATE account SET balance = 70 WHERE id = 1 + + COMMIT + + UPDATE account SET balance = 150 WHERE id = 1 + + COMMIT + + SELECT balance FROM account WHERE id = 1 + → 150 + 正确结果应为 120,T1 取出的 30 元丢失了。 + 改为 SET balance = balance - 30 后,T2 的 UPDATE 会等待 T1 的行锁,再在 70 的基础上加 50,结果为 120。 + diff --git a/tools/diagram/src/txn-non-repeatable.svg b/tools/diagram/src/txn-non-repeatable.svg new file mode 100644 index 000000000..d309655cb --- /dev/null +++ b/tools/diagram/src/txn-non-repeatable.svg @@ -0,0 +1,58 @@ + + + + + + + + + + + + + + + + 不可重复读:同一个事务两次读取同一行,结果不同 + + 事务 T1 + 自动提交 + + + 事务 T2 + READ COMMITTED + + 时间 + + + BEGIN + + SELECT balance FROM account WHERE id = 1 + → 100 + + UPDATE account SET balance = 200 WHERE id = 1 + + SELECT balance FROM account WHERE id = 1 + → 200 + + COMMIT + T1 在 T2 的两次读取之间修改并提交了这一行。 + T2 的隔离级别为 REPEATABLE READ 时,第二次读到的仍然是 100。 + diff --git a/tools/diagram/src/txn-phantom.svg b/tools/diagram/src/txn-phantom.svg new file mode 100644 index 000000000..4f783d82c --- /dev/null +++ b/tools/diagram/src/txn-phantom.svg @@ -0,0 +1,58 @@ + + + + + + + + + + + + + + + + 幻影读:同一个事务两次范围查询,行数不同 + + 事务 T1 + 自动提交 + + + 事务 T2 + READ COMMITTED + + 时间 + + + BEGIN + + SELECT id FROM account WHERE balance > 50 + → 1,2 + + INSERT INTO account VALUES (3, 100) + + SELECT id FROM account WHERE balance > 50 + → 1,2,3 + + COMMIT + T1 在 T2 查询的范围内插入了新的一行。 + T2 的隔离级别为 REPEATABLE READ 时,第二次查询仍然只有 1、2。 + diff --git a/tools/diagram/src/url-timeline.svg b/tools/diagram/src/url-timeline.svg new file mode 100644 index 000000000..f7faea580 --- /dev/null +++ b/tools/diagram/src/url-timeline.svg @@ -0,0 +1,63 @@ + + + + + + + + + + + + + + + + 访问 https://www.example.com/ 的耗时(本机一次实测,RTT 约 200 ms) + DNS 解析 + + 10 ms,命中缓存 + TCP 三次握手 + + 1 个 RTT + TLS 1.3 握手 + + 1 个 RTT + 请求到首字节 + + 1 个 RTT + 服务器处理 + + 0 ms + + 100 ms + + 200 ms + + 300 ms + + 400 ms + + 500 ms + + 600 ms + + curl -w 测得:time_connect 0.210 s、time_appconnect 0.423 s、time_starttransfer 0.629 s。 + HTTPS 首次请求至少要 3 个 RTT 才能收到响应,这也是连接复用、TLS 会话恢复和 HTTP/3 要解决的问题。 + diff --git a/tools/diagram/src/vm-mapping.svg b/tools/diagram/src/vm-mapping.svg new file mode 100644 index 000000000..0987ac221 --- /dev/null +++ b/tools/diagram/src/vm-mapping.svg @@ -0,0 +1,141 @@ + + + + + + + + + + + + + + + + 虚拟内存:64 KB 的地址空间,只有 32 KB 物理内存 + 虚拟页(4 KB 一页) + + 2 + 0K~4K + 0 + + 7 + 4K~8K + 1 + + × + 8K~12K + 2 + + 5 + 12K~16K + 3 + + × + 16K~20K + 4 + + 0 + 20K~24K + 5 + + × + 24K~28K + 6 + + × + 28K~32K + 7 + + 3 + 32K~36K + 8 + + × + 36K~40K + 9 + + × + 40K~44K + 10 + + 6 + 44K~48K + 11 + + × + 48K~52K + 12 + + × + 52K~56K + 13 + + 4 + 56K~60K + 14 + + × + 60K~64K + 15 + 物理页框 + + 页 5 + 0K~4K + 0 + + 空闲 + 4K~8K + 1 + + 页 0 + 8K~12K + 2 + + 页 8 + 12K~16K + 3 + + 页 14 + 16K~20K + 4 + + 页 3 + 20K~24K + 5 + + 页 11 + 24K~28K + 6 + + 页 1 + 28K~32K + 7 + + + + + + + + 左边格子中的数字是页框号,× 表示这一页不在内存中,访问它会触发缺页中断,由操作系统从磁盘调入。 + 只有 7 页在内存中,程序照样可以运行;各页映射到哪个页框没有顺序要求。 + diff --git a/tools/diagram/src/zero-copy.svg b/tools/diagram/src/zero-copy.svg new file mode 100644 index 000000000..6894606e5 --- /dev/null +++ b/tools/diagram/src/zero-copy.svg @@ -0,0 +1,85 @@ + + + + + + + + + + + + + + + + 零拷贝:sendfile 让数据不经过用户空间 + read + write:4 次拷贝,2 次系统调用带来 4 次用户态与内核态的切换 + + 用户空间 + + 内核空间 + + 硬件 + + 磁盘 + + 页缓存 + + 应用的缓冲区 + + Socket 缓冲区 + + 网卡 + + ① DMA + + ② CPU + + ③ CPU + + ④ DMA + read() + write() + sendfile:数据留在内核中,网卡支持 SG-DMA 时 CPU 不拷贝数据 + + 用户空间 + + 内核空间 + + 硬件 + + 磁盘 + + 页缓存 + + Socket 缓冲区 + + 网卡 + 应用只调用一次 sendfile() + + ① DMA + + 只追加地址和长度 + + ② DMA:网卡直接从页缓存读取 + Kafka 的 broker 把日志文件发给消费者时使用 sendfile。启用 TLS 后数据要在用户空间加密,就不再使用零拷贝。 + 网卡不支持 SG-DMA 时,sendfile 仍要由 CPU 把页缓存中的数据拷贝到 Socket 缓冲区,共 3 次拷贝。 +