Repository navigation
Conventions
En este apartado estableceremos las convenciones con el objetivo de establecer un marco de trabajo.
Se decidió adoptar la estructura de archivos utilizada por la plataforma Astronomer (más info: https://www.astronomer.io/guides/airflow-sql-tutorial/).
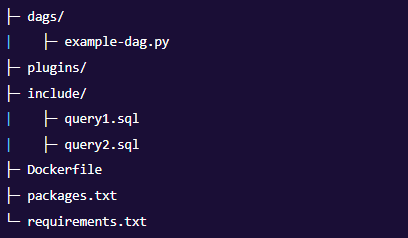
Se agrega a la estructura del proyecto:
- Folder
assets, donde irán archivos suplementarios que no produjimos nosotros, por ejemplo el .csv de codigo postal y ciudades. - Folder
datasets, donde irán los .csv que transformamos con pandas. - Folder
files, donde irán los .csv que son fiel imagen de lo que extrajimos de postgres. - Folder
plugins\dynamic_dags, contiene archivos necesarios para el uso de los dynamic dags: - LETRAGRUPO_config_uni_nombre_de_universidad.yaml < archivo de configuración especifico de cada universidad - LETRAGRUPO_generators.py < archivo generador de los dags dinamicos - LETRAGRUPO_template.jinja2 < archivo jinja con el template de como se debe diseñar el dag
LETRAGRUPO_uni_nombre_de_la_universidad.sql
- university
- career
- inscription_date
- first_name
- last_name
- gender
- birth_date
- age
- postal_code
- location
Nota: Se llenarán con NULLs aquellas columnas cuyos valores no se encuentren en la fuente de información.
LETRAGRUPO_uni_nombre_de_la_universidad.py
Para la tarea "Configurar un DAG, sin consultas, ni procesamiento", se debe diseñar el DAG.
Para esto definiremos funciones de Python vacías y utilizaremos PythonOperators que ejecutarán estas funciones para cumplir las tareas del DAG.
Se debe documentar que operators se utilizarán en el futuro para realizar dichas tareas.
- Cantidad de retries: 5
- Intervalo de retries: 5 segundos
- Start date: (por definir)
- postgres_conn_id = "db_universidades_postgres"
- conexión a S3 = "universidades_S3"
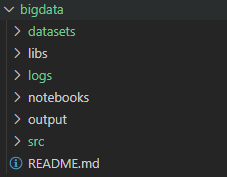
Descripción de cada carpeta:
-
Folder
datasets: se encuentra el archivo .xml de _posts _en Stack. -
Folder
libs: se encuentra la librería chunckify.py. También iremos guardando todas las librerías personales que generemos, bajo el nombre: "LETRAGRUPO_nombre_librería.py" -
Folder
logs: contiene archivos .cfg para la configuraciones de logs de cada grupo de datos. Se guardan bajo el nombre: "LETRAGRUPO_logger.cfg". -
Folder
notebooks: contiene las Jupyter Notebooks donde se realizarán análisis más profundos y visualizaciones sobre los .csv de la carpeta output. Se genera un archivo .ipynb por cada requerimiento y se guardan bajo el nombre "LETRA_GRUPO_descripcion_requerimiento.ipynb", por ej: "D_top10_preguntas_mayor_actividad.ipynb". -
Folder
output: contiene los archivos .csv generados por los archivos .py de la carpeta src. Se genera un archivo .csv por cada requerimiento y se guardan bajo el nombre "LETRA_GRUPO_descripcion_requerimiento.csv", por ej: "D_top10_preguntas_mayor_actividad.csv". -
Folder
src: contiene los archivos fuente .py que ejecutarán la lógica MapReduce para procesar todos los grupos de datos, y cada uno de sus requerimientos. Se utiliza un archivo .py por cada requerimiento y se guardan bajo el nombre "LETRA_GRUPO_descripcion_requerimiento.py", por ej: "D_top10_preguntas_mayor_actividad.py".
Extraído del archivo readme.txt que nos facilita Stack Overflow.

- Nivel mínimo de logueo: DEBUG
- Número de
loggers: - Número de
handlers: - Número de
formatters: